Strata vs Ollama:与 llama.cpp、LM Studio、vLLM 的区别和选择指南
更新于 2026-11-04。 依据公开文档、发布说明和第三方报告。我们没有自己做任何基准测试。
Strata vs Ollama 是这个月大家问得最多的对比,但这并不是两个做同一件事的工具之间的公平较量。Strata 是新出的引擎,专门让一类超大的混合专家(MoE)模型在小显存电脑上跑起来;Ollama 是成熟的通用模型管理器;llama.cpp、LM Studio 和 vLLM 则分占同一张地图的不同角落。本文把五个工具并排放好,说明各自的用途,核实我们能查到的 Qwen3.8-Flash-Next 支持情况,最后给出选择指南。如果你只听说过“Strata”这个词,先读Strata 是什么。
Strata vs Ollama:先给结论
- Strata: 想在 12 到 24 GB 显卡、48 到 64 GB 内存的电脑上跑超大的 MoE 模型(主要是 Qwen3.8-Flash-Next)时选它。
- Ollama: 想用最省事的方式运行大量中小模型并接入各种应用时选它。
- llama.cpp: 想对 GGUF 模型和硬件拥有最大的控制权,或者你用的工具本来就建立在它之上时选它。
- LM Studio: 想用图形界面查找、下载、聊天时选它。
- vLLM: 想用显存足够的 GPU 同时服务很多用户时选它。
并排对比
| Strata | Ollama | llama.cpp | LM Studio | vLLM | |
|---|---|---|---|---|---|
| 主要用途 | 通过显卡、内存、SSD 分层,让超大 MoE 模型在小显存上运行 | 一条命令拉取、运行并服务大量模型 | 许多工具所依赖的推理库和服务器 | 浏览、下载、聊天的桌面应用 | 高吞吐的服务引擎 |
| 许可 | MIT(引擎) | MIT | MIT | 专有应用,按其条款家庭和工作可免费使用 | Apache-2.0 |
| GitHub 星标(2026-11-04) | 39,548 | 185,856 | 133,318 | 不是开源仓库 | 96,277 |
| 界面 | 桌面应用和终端 | 命令行、应用、REST 接口 | 命令行和 llama-server |
图形应用、lms 命令行、无界面模式 |
Python 库和服务器 |
| 接口 | OpenAI、Anthropic 和 Responses 风格 | 自有接口加 OpenAI 兼容端点 | OpenAI 兼容服务器 | OpenAI 兼容服务器 | OpenAI 兼容服务器 |
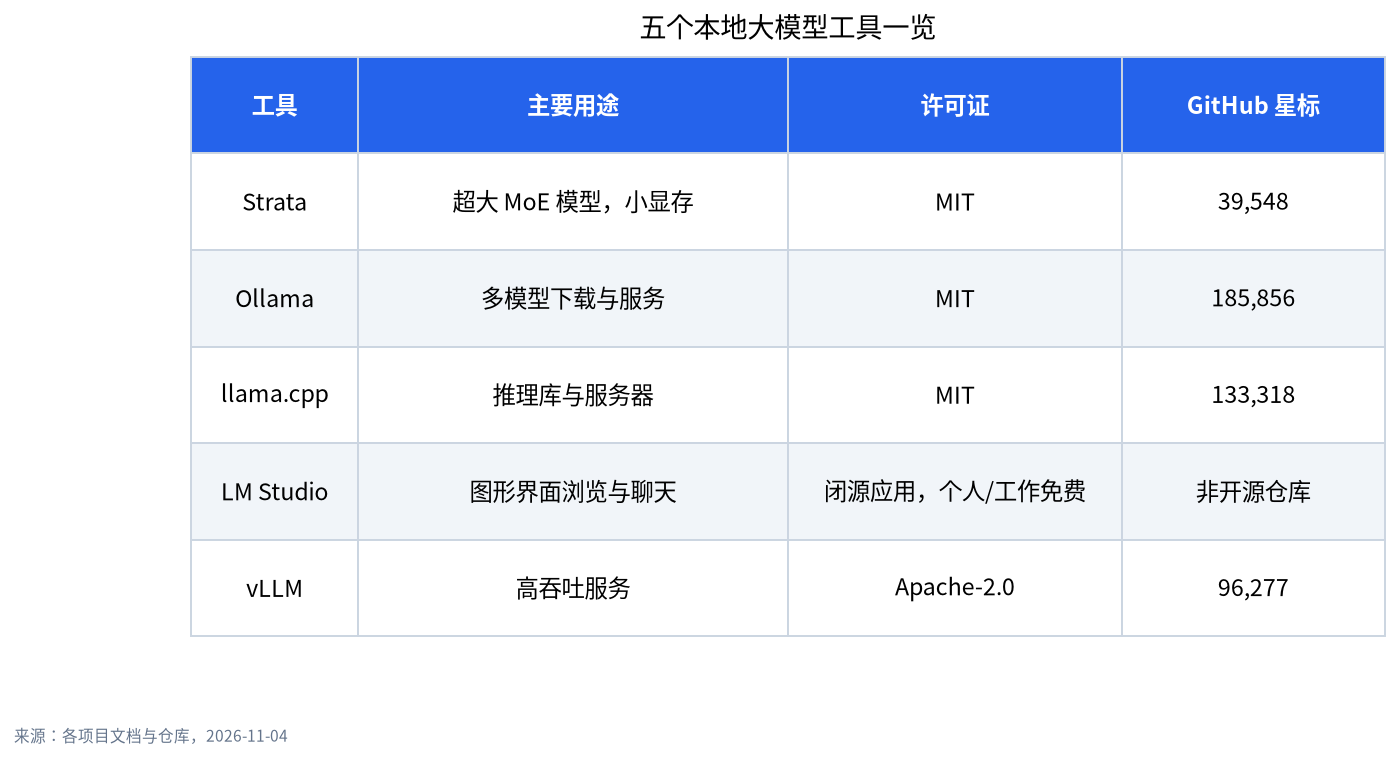
星标衡量的是关注度而不是质量。Strata 的仓库才六周,Ollama 有好几年来积累。想看势头,更应该看发布记录:Strata 在 10 月 25 日到 11 月 2 日之间发了六个版本,Ollama 的 v0.40.14 出现在 11 月 3 日。
各自擅长什么,要注意什么
| 工具 | 擅长 | 要注意 |
|---|---|---|
| Strata | 12 到 24 GB 显卡上的超大 MoE 模型,一键安装,strata connect 对接编程智能体 |
支持的模型很少,项目年轻,12 GB 显卡上长提示很慢(PC Watch),按其文档尚无外部安全审计 |
| Ollama | 简单、模型库大、生态庞大,ollama launch 对接编程工具,v0.40.0 起在 Apple 芯片上用 MLX |
并非为从内存和 SSD 流式读取 125B MoE 而设计;本地使用之外还有可选的云端模型和付费套餐 |
| llama.cpp | 硬件支持广、量化格式多、控制精细;它在 PR #27742(2026-08-27 合并)中加入了 Qwen3.8-Flash-Next 支持 | 要学的参数更多,需要自己搭配环境 |
| LM Studio | 友好的图形界面,同时带 llama.cpp 和 MLX 引擎,可用 lms 无界面运行 |
闭源应用;若要嵌入产品,需遵守它的条款 |
| vLLM | 并发请求下的吞吐量 | 需要整个模型放进显存,不是为 12 GB 显卡准备的 |
vLLM 的官方仓库在 github.com/vllm-project/vllm。想更详细地了解最常见的三个工具,请看Ollama、LM Studio、llama.cpp 对比,vLLM 请看vLLM 与 SGLang 入门。
对 Qwen3.8-Flash-Next 的支持:我们能核实到的
大部分 Strata 热度都来自这个模型,所以要说准确。以下全部是 2026-11-04 的状态。
- Strata: 为它而生(模型列表)。文档列出四档量化,内存加显存 37.6 到 54.8 GB。
- llama.cpp: PR #27742“model: add Qwen3.8-Flash-Next (qwen4exp)”已于 2026-08-27 合并。Hacker News 上有用户称在一套 AMD 配置上 llama.cpp 约 21 token/s,而 Strata 约 60 token/s。这只是一条个例,不是我们能担保的测试。
- Ollama:
qwen3.8-flash-next的库页面只有一个标签125b-mlx(105 GB,面向 Apple 芯片)。一个功能请求 issue 在 2026-10-17 被关闭。我们没找到面向 NVIDIA 显卡的标签,也没有测试,所以不声称 Ollama 跑不了,只说我们没查到有文档的途径。 - LM Studio 和 vLLM: 我们没有核查。
各工具如何处理比显存更大的模型
这是几个工具真正不同的地方。模型放不进显卡时,Ollama 和 llama.cpp 通常按层拆分:一部分层在 GPU 上,其余在 CPU 上,权重放在内存。这对稠密模型很有效,也是小显卡的标准做法。MoE 模型不同,因为每个 token 只用几个专家。llama.cpp 有把专家留在 CPU 一侧的选项(--cpu-moe 一类参数),有一位 Hacker News 用户称用这种方式在 192 GB 内存的机器上跑 Q8_0 文件达到 16 token/s。Strata 更进一步:在显卡上缓存最常用的专家,其余专家留在内存里由 CPU 计算,还能把剩下的从 SSD 流式读取。结果是一个把一件事做得很好的工具,代价是只支持少数几个模型。vLLM 则默认整个模型都在显存里,所以适合服务器,而不是 12 GB 的桌面显卡。
三种常见的组合用法
这一节是我们根据文档做的归纳,不是项目方的推荐,也没有经过我们自己的实测。
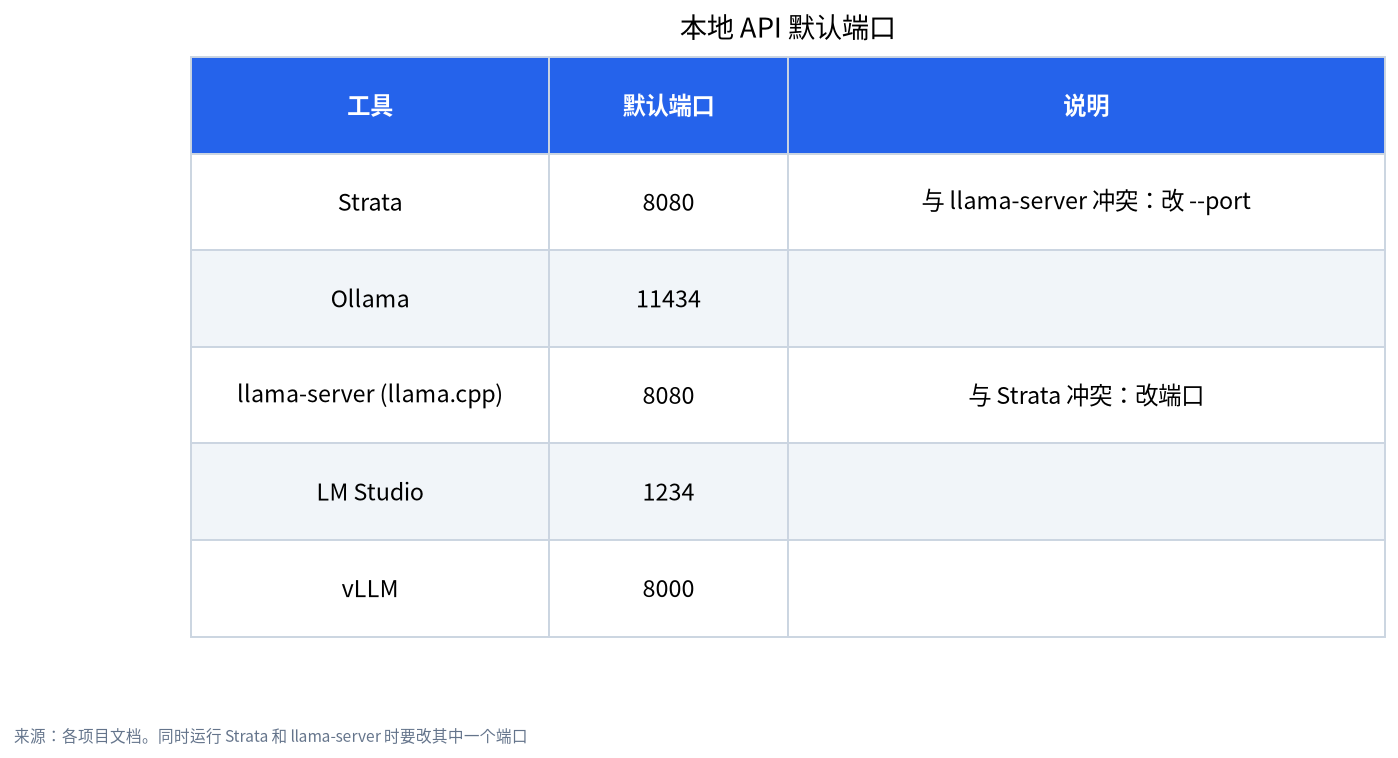
- Ollama 加 Strata。 Ollama 管日常的小模型和 Open WebUI,Strata 只在需要 Qwen3.8-Flash-Next 时启动。端口不冲突,但要记得先让 Ollama 把模型卸载,再启动 Strata。
- LM Studio 加 Strata。 喜欢图形界面的人可以用 LM Studio 浏览和试用各种模型,再用 Strata 跑那个大模型。LM Studio 默认端口是 1234,也不会和 Strata 冲突。
- llama.cpp 加 Strata。 想拿同一个模型做对照的人,可以让两者轮流跑,但
llama-server与 Strata 默认都用 8080,必须改掉其中一个端口,而且要在相同的量化、上下文和版本下比较才有意义。
如果你的机器只有 16 GB 内存、显卡也不足 12 GB,我们的建议是先不要在这件事上花时间:Strata 的优势恰恰建立在大内存之上,换一个更小的模型、继续用 Ollama 往往更实际。
怎样看待速度宣传
大部分“Strata 更快”的帖子比较的是不同的模型。一位做 RTX 3060 测试的日本博主,把 Strata 跑 125B 模型的 44.49 token/s,和同一台电脑上 Ollama 跑 9B、26B 模型的结果放在一张表里,随后明确说这张表并不能说明 Strata 比 Ollama 快还是慢。arm1.ru 的测试则是 Strata 跑 Flash-Next,对比 llama.cpp 跑另一个模型 Qwen3.8-27B。公平的对比需要相同的模型、量化、上下文、硬件和软件版本,我们没找到完全达到这个标准的。在出现之前,请把速度理解为“这个工具在这个模型上做到了多少”,而不是“哪个工具更快”。来源在这里:note.com 的测试、arm1.ru和 Hacker News 讨论。
选择指南
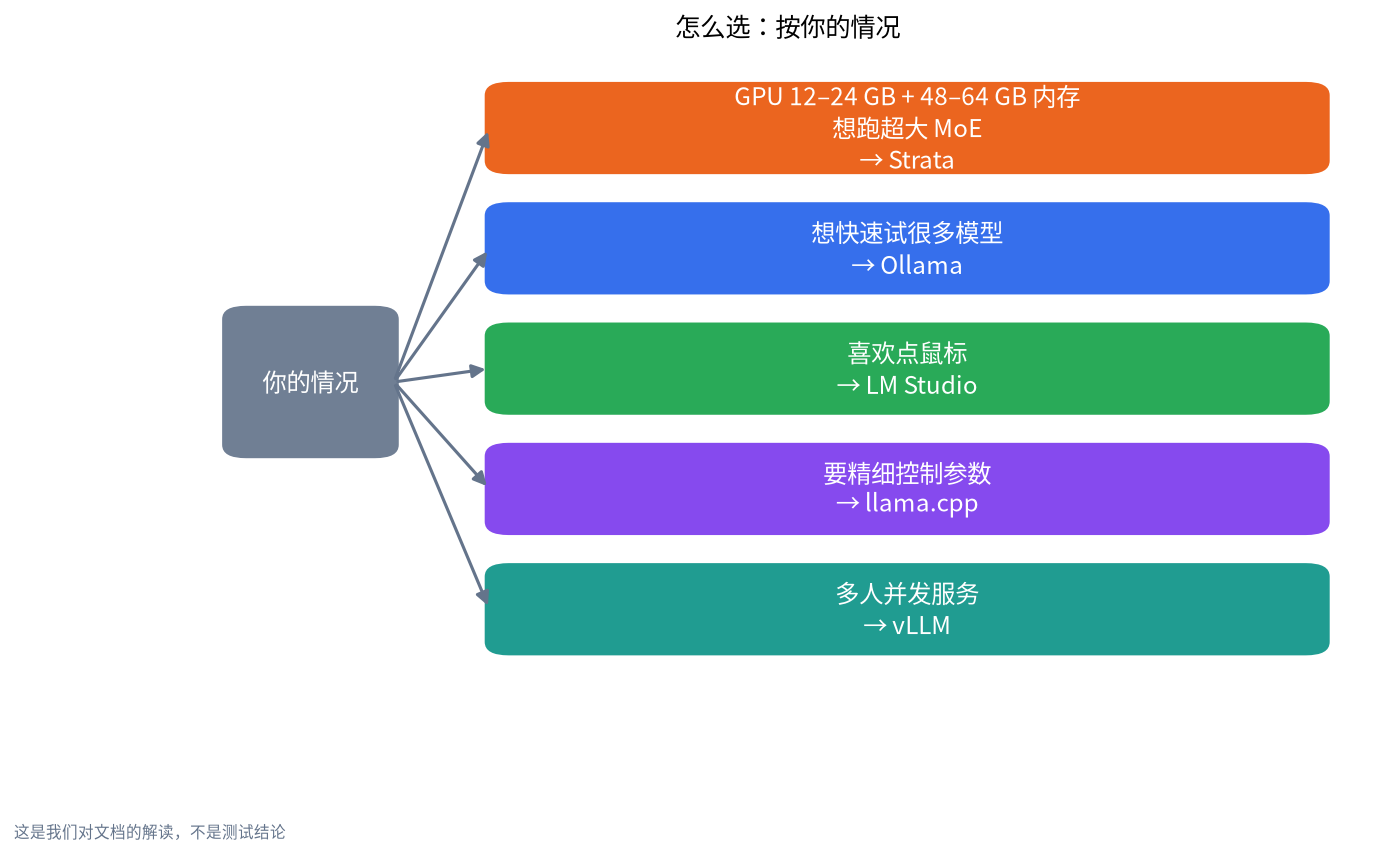
| 你的情况 | 先用 | 原因 |
|---|---|---|
| 12 到 24 GB 的 NVIDIA 或 AMD 显卡,48 到 64 GB 内存,想跑 Qwen3.8-Flash-Next | Strata | 它就是为这个模型和这种内存布局做的 |
| 想快速试很多模型,或接入 Open WebUI | Ollama | 安装最简单,生态最大;见Ollama 安装指南 |
| 喜欢点鼠标而不是敲命令 | LM Studio | 图形化模型浏览;见LM Studio 教程 |
| 需要精确控制参数、量化或编译选项 | llama.cpp | 最贴近底层 |
| 用一台 GPU 服务器服务团队 | vLLM | 为并发请求而设计 |
| 有大统一内存的 Mac | 先用 Ollama 或 LM Studio | 两者在 Apple 芯片上都用 MLX;Strata 也支持 macOS 15 及以上 |
没有人规定只能用一个。很多人会保留 Ollama 跑日常模型,再为一个大模型加装 Strata,只要记得两者争用同一份显存和内存。具体步骤见与 Ollama 并存的 Strata 安装指南,内存数字见硬件需求文章。
许可、数据与成本
这些引擎是开源的(MIT 或 Apache-2.0),但模型权重有各自的许可:Qwen3.8-Flash-Next 使用 Qwen Community License 1.0,计划商用的话请先阅读。Strata 的文档称没有遥测、不要账号;按其发布说明,Ollama 运行本地模型不需要登录,同时也提供可选的云端模型和付费套餐;LM Studio 的条款允许家庭和工作使用,但不允许再分发或作为服务托管。请务必自己核对当前条款。成本方面,这几个工具本身都不收费,真正的花费在硬件上:Strata 要的是大内存和一块 12 GB 以上的显卡,vLLM 要的是能装下整个模型的显存,两者的预算思路完全不同,选工具之前先想清楚自己手里有什么硬件。
我们做了什么,没做什么
2026-11-04 当天,我们阅读了各项目的仓库、发布说明和文档,以及上面链接的第三方报告。我们没有为这篇文章安装五个工具中的任何一个,也没有测量任何速度。凡是来自单个用户的说法,我们都做了说明。
常见问题(FAQ)
Strata 比 Ollama 快吗?
我们无法回答。已发布的对比大多用了不同的模型,所以回答不了这个问题。据测试者报告,Strata 能在 12 GB 显卡上以每秒几十个 token 跑 125B 的 MoE 模型,但这和在 Ollama 里跑 9B 模型是两件不同的事。
Ollama 能跑 Qwen3.8-Flash-Next 吗?
2026-11-04 时,Ollama 库里有一个面向 Apple 芯片的 105 GB MLX 标签。我们没找到面向 NVIDIA 显卡的有文档途径,也没有测试,所以请到库页面查看你所用平台的情况。
新手用哪个最好?
Ollama 或 LM Studio。两者几分钟就能装好,教程也最多。以后想要某个特定的超大模型时,再加装 Strata。
Strata 是基于 llama.cpp 的吗?
它的文档把 ggml(llama.cpp 背后的张量库)列为第三方组件,但 Strata 是独立的 C++ 引擎,有自己的调度,并没有被描述为 llama.cpp 的分叉。
服务一个团队用哪个最好?
如果有足够的显存放下整个模型,用 vLLM。Strata 默认按你的显卡来决定并行请求数(12 GB 显卡是 1 个),所以 12 GB 的卡更适合一个人用,而不是一个团队。
试用 Strata 需要先卸载 Ollama 吗?
不需要。两者默认端口不同,模型文件夹也不同。只要别同时往同一块显卡里加载两个大模型就行。
和我们聊聊
不确定哪个工具适合你的显卡和预算?欢迎加入社区,或发邮件到 admin@microaione.com,告诉我们你的显卡、内存和用途。如果想要一台为此搭建并调试好的整机,可以看我们的整机与方案指南。