Strata vs Ollama vs llama.cpp vs LM Studio vs vLLM: para qué sirve cada uno y cuál elegir
Actualizado 2026-11-04. Basado en documentación pública, notas de versión e informes de terceros. No hemos ejecutado ningún benchmark nosotros mismos.
Strata vs Ollama es la comparación que todo el mundo pide este mes, pero no es un duelo justo entre dos herramientas que hacen el mismo trabajo. Strata es un motor nuevo creado para ejecutar una clase de modelos de mezcla de expertos (MoE) muy grandes en un PC con una tarjeta gráfica pequeña. Ollama es un gestor general de modelos y está maduro. llama.cpp, LM Studio y vLLM están en otras esquinas del mismo mapa. Este artículo pone las cinco herramientas lado a lado, muestra para qué sirve cada una, revisa lo que pudimos verificar sobre el soporte de Qwen3.8-Flash-Next y termina con una guía de decisión. Si solo conoces el término «Strata», empieza con nuestra explicación de qué es Strata.
La respuesta corta de Strata vs Ollama
- Strata: elígelo si quieres un modelo MoE muy grande, sobre todo Qwen3.8-Flash-Next, en un PC con GPU de 12 a 24 GB y de 48 a 64 GB de RAM.
- Ollama: elígelo si quieres la forma más fácil de ejecutar muchos modelos pequeños y medianos y conectarlos a aplicaciones.
- llama.cpp: elígelo si quieres el máximo control sobre los modelos GGUF y el hardware, o si una herramienta que usas está construida sobre él.
- LM Studio: elígelo si quieres una aplicación gráfica para buscar, descargar y conversar con modelos.
- vLLM: elígelo si sirves a muchos usuarios a la vez desde GPU con memoria suficiente.
Lado a lado
| Strata | Ollama | llama.cpp | LM Studio | vLLM | |
|---|---|---|---|---|---|
| Función principal | Ejecutar modelos MoE enormes con poca VRAM repartiendo GPU, RAM y SSD | Descargar, ejecutar y servir muchos modelos con un comando | La biblioteca de inferencia y servidor sobre la que se construyen muchas herramientas | Aplicación de escritorio para explorar, descargar y chatear | Motor de servicio de alto rendimiento |
| Licencia | MIT (motor) | MIT | MIT | Aplicación propietaria, gratuita para uso doméstico y laboral según sus términos | Apache-2.0 |
| Estrellas en GitHub (2026-11-04) | 39.548 | 185.856 | 133.318 | No es un repositorio abierto | 96.277 |
| Interfaz | Aplicación de escritorio y terminal | Línea de comandos, aplicación, API REST | Línea de comandos y llama-server |
Aplicación gráfica, CLI lms, modo sin interfaz |
Biblioteca de Python y servidor |
| API | Estilo OpenAI, Anthropic y Responses | API propia más endpoints compatibles con OpenAI | Servidor compatible con OpenAI | Servidor compatible con OpenAI | Servidor compatible con OpenAI |
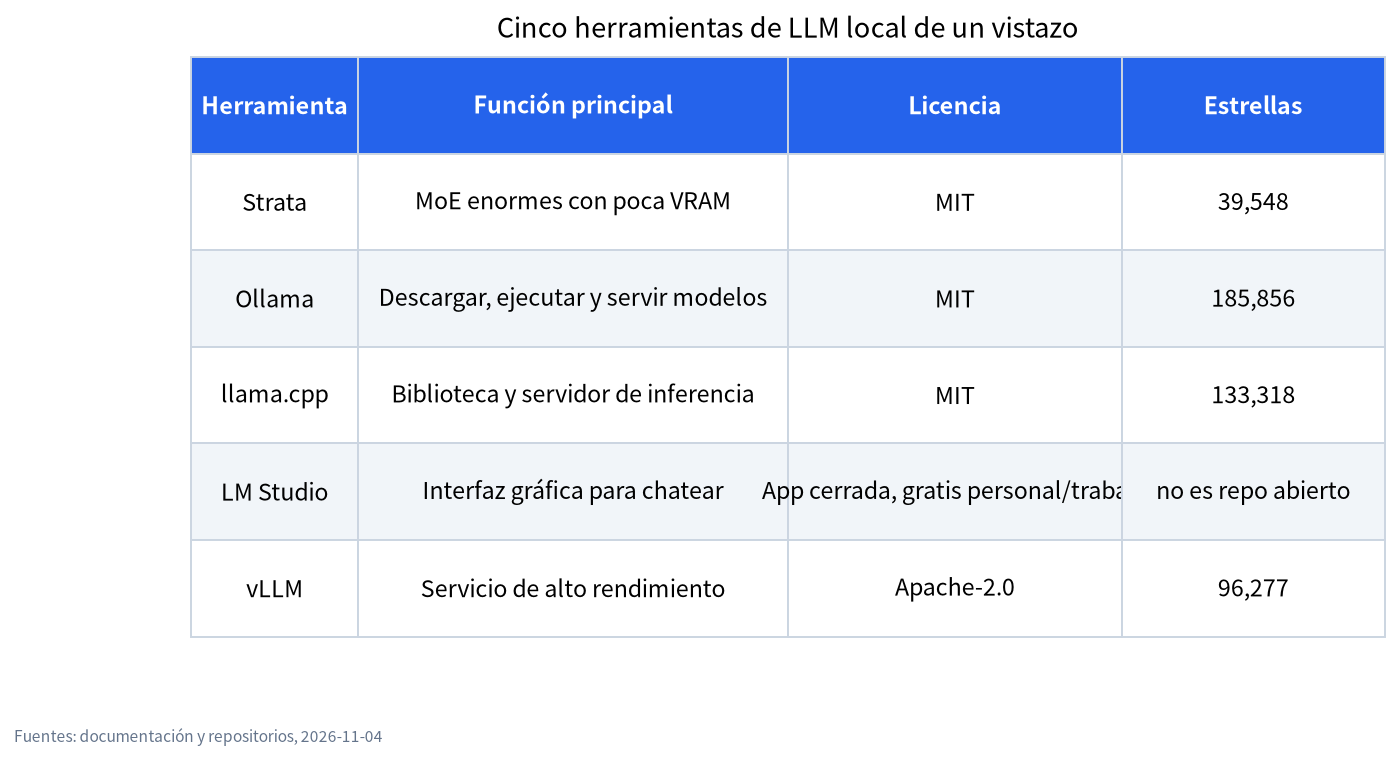
Las estrellas miden atención, no calidad. El repositorio de Strata tiene seis semanas; el de Ollama ha tenido años para acumularlas. Las notas de versión dicen más sobre el impulso: Strata publicó seis versiones entre el 25 de octubre y el 2 de noviembre, y v0.40.14 de Ollama apareció el 3 de noviembre.
En qué es bueno cada uno y qué vigilar
| Herramienta | Fuerte en | Ojo con |
|---|---|---|
| Strata | Modelos MoE muy grandes en tarjetas de 12 a 24 GB, instalación con un clic, strata connect para agentes de programación |
Pocos modelos compatibles, proyecto joven, los prompts largos son lentos en tarjetas de 12 GB (PC Watch), sin auditoría de seguridad externa según su documentación |
| Ollama | Sencillez, gran biblioteca de modelos, enorme ecosistema, ollama launch para herramientas de programación, MLX en Apple Silicon desde v0.40.0 |
No está diseñado para leer un MoE de 125B desde RAM y SSD; junto al uso local existen modelos en la nube opcionales y planes de pago |
| llama.cpp | Amplio soporte de hardware, formatos de cuantización, control fino; añadió soporte de Qwen3.8-Flash-Next en el pull request #27742, fusionado el 2026-08-27 | Más opciones que aprender; montas tú mismo la configuración |
| LM Studio | Interfaz amable, usa motores llama.cpp y MLX, puede funcionar sin interfaz con lms |
Aplicación de código cerrado; respeta sus términos si la integras en un producto |
| vLLM | Rendimiento con muchas peticiones paralelas | Necesita memoria de GPU para todo el modelo; no apunta a una tarjeta de 12 GB |
El repositorio propio de vLLM está en github.com/vllm-project/vllm. Para ver más a fondo las tres herramientas más comunes, consulta nuestra guía Ollama vs LM Studio vs llama.cpp, y para vLLM, nuestra introducción a vLLM y SGLang.
Soporte de Qwen3.8-Flash-Next, según pudimos verificarlo
Este es el modelo detrás de la mayor parte del revuelo de Strata, así que conviene ser exactos. Todo lo que sigue está fechado a 2026-11-04.
- Strata: construido para él (lista de modelos). La documentación indica cuatro cuantizaciones, de 37,6 a 54,8 GB de RAM más VRAM.
- llama.cpp: el pull request #27742, «model: add Qwen3.8-Flash-Next (qwen4exp)», se fusionó el 2026-08-27. Un usuario de Hacker News reportó llama.cpp a unos 21 tokens/s frente a Strata a unos 60 tokens/s en una configuración AMD. Es una anécdota, no una prueba que podamos avalar.
- Ollama: su página de biblioteca de
qwen3.8-flash-nextmostraba una sola etiqueta,125b-mlx(105 GB, para Apple Silicon). Una solicitud de función se cerró el 2026-10-17. No encontramos etiqueta para GPU NVIDIA y no probamos, así que no afirmamos que Ollama no pueda ejecutarlo, solo que no encontramos una vía documentada. - LM Studio y vLLM: no lo comprobamos.
Cómo trata cada herramienta un modelo mayor que tu VRAM
Aquí es donde las herramientas realmente difieren. Cuando un modelo no cabe en la tarjeta, Ollama y llama.cpp normalmente lo dividen por capas: unas capas se ejecutan en la GPU y el resto en la CPU, con los pesos en RAM. Funciona bien con modelos densos y es la vía estándar en tarjetas pequeñas. Un modelo MoE es distinto, porque solo se usan unos pocos expertos por token. llama.cpp tiene opciones que dejan los expertos del lado de la CPU (la familia de opciones --cpu-moe), y un usuario de Hacker News reportó 16 tokens/s con un archivo Q8_0 en una máquina con 192 GB de RAM usando ese enfoque. Strata va un paso más allá: mantiene en la GPU una caché de los expertos más usados, calcula los demás en la CPU donde residen en RAM y puede leer el resto desde el SSD. El resultado es una herramienta que hace bien una cosa, a costa de admitir pocos modelos. vLLM, en cambio, supone que todo el modelo vive en la memoria de la GPU, por lo que encaja con servidores y no con una tarjeta de escritorio de 12 GB.
Cómo leer las afirmaciones de velocidad
La mayoría de los textos de «Strata es más rápido» comparan modelos distintos. El bloguero japonés de una prueba con RTX 3060 puso los 44,49 tokens/s de Strata con el modelo de 125B junto a resultados de Ollama con modelos de 9B y 26B en el mismo PC, y dijo claramente que esa tabla no muestra que Strata sea más rápido o más lento que Ollama. La prueba de arm1.ru comparó Strata ejecutando Flash-Next con llama.cpp ejecutando otro modelo, Qwen3.8-27B. Una comparación justa exige el mismo modelo, cuantización, contexto, hardware y versión de software; no encontramos ninguna que cumpla del todo ese listón. Hasta que aparezca una, lee las velocidades como «lo que esta herramienta consiguió con este modelo», no como «qué herramienta es más rápida». Lee las fuentes: la prueba de note.com, arm1.ru y el hilo de Hacker News.
Guía de decisión
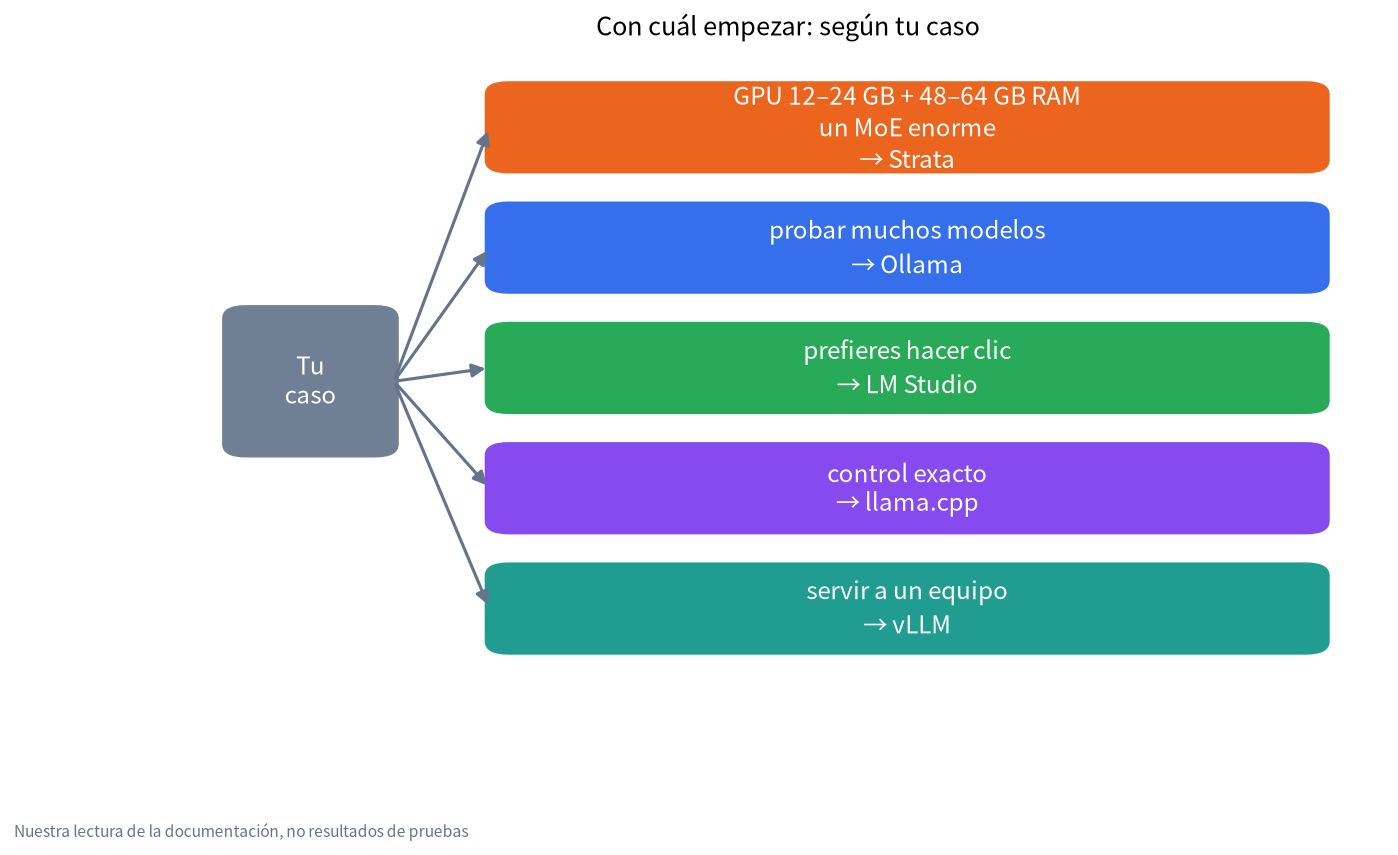
| Tu situación | Empieza con | Por qué |
|---|---|---|
| GPU NVIDIA o AMD de 12 a 24 GB, de 48 a 64 GB de RAM, quieres Qwen3.8-Flash-Next | Strata | Está hecho para ese modelo y esa distribución de memoria |
| Quieres probar muchos modelos rápido o conectar Open WebUI | Ollama | Instalación más sencilla y mayor ecosistema; véase nuestra guía de instalación de Ollama |
| Prefieres hacer clic a escribir | LM Studio | Explorador de modelos gráfico; véase nuestro tutorial de LM Studio |
| Necesitas control exacto de opciones, cuantización o compilaciones | llama.cpp | Lo más cercano al metal |
| Sirves a un equipo desde un servidor con GPU | vLLM | Hecho para peticiones concurrentes |
| Tienes un Mac con mucha memoria unificada | Primero Ollama o LM Studio | Ambos usan MLX en Apple Silicon; Strata también admite macOS 15 o posterior |
Nada impide usar dos. Mucha gente mantendrá Ollama para los modelos de todos los días y añadirá Strata para un modelo grande; solo recuerda que ambos quieren la misma VRAM y RAM. Los pasos prácticos están en nuestra guía de instalación para ejecutar Strata junto a Ollama, y las cifras de memoria en nuestro artículo de requisitos de hardware.
Licencias, datos y coste
Los motores son de código abierto (MIT o Apache-2.0), pero los pesos de los modelos tienen sus propias licencias; Qwen3.8-Flash-Next usa la Qwen Community License 1.0, así que léela si planeas un uso comercial. Los documentos de Strata dicen que no hay telemetría ni cuenta; Ollama ejecuta modelos locales sin iniciar sesión y, según sus notas de versión, también ofrece modelos en la nube opcionales y planes de pago; los términos de LM Studio permiten el uso doméstico y laboral, pero no redistribuirlo ni alojarlo como servicio. Comprueba siempre los términos vigentes por tu cuenta.
Lo que hicimos y lo que no
El 2026-11-04 leímos el repositorio, las notas de versión y la documentación de cada proyecto, además de los informes de terceros enlazados arriba. No instalamos ninguna de las cinco herramientas para este artículo ni medimos una sola velocidad. Cuando una afirmación viene de un solo usuario, lo decimos.
Preguntas frecuentes (FAQ)
¿Es Strata más rápido que Ollama?
No podemos decirlo. Las comparaciones publicadas usan sobre todo modelos distintos, así que no responden a la pregunta. Según los probadores, Strata puede ejecutar un MoE de 125B a decenas de tokens por segundo en una tarjeta de 12 GB, pero es un trabajo distinto de ejecutar un modelo de 9B en Ollama.
¿Puede Ollama ejecutar Qwen3.8-Flash-Next?
El 2026-11-04 la biblioteca de Ollama listaba una etiqueta MLX de 105 GB para Apple Silicon. No encontramos una vía documentada para GPU NVIDIA y no probamos, así que consulta la página de la biblioteca para tu plataforma.
¿Qué herramienta es mejor para un principiante?
Ollama o LM Studio. Ambos se instalan en minutos y tienen más guías. Añade Strata más tarde si quieres un modelo muy grande concreto.
¿Está Strata construido sobre llama.cpp?
Su documentación cita ggml, la biblioteca de tensores de llama.cpp, como componente de terceros, pero Strata es un motor C++ aparte con su propia planificación. No se describe como un fork de llama.cpp.
¿Cuál es el mejor para servir a un equipo?
vLLM, si tienes memoria de GPU suficiente para todo el modelo. El valor por defecto de Strata ajusta las peticiones paralelas a tu tarjeta (una en una GPU de 12 GB), así que una tarjeta de 12 GB es para un solo usuario y no para un equipo.
¿Tengo que desinstalar Ollama para probar Strata?
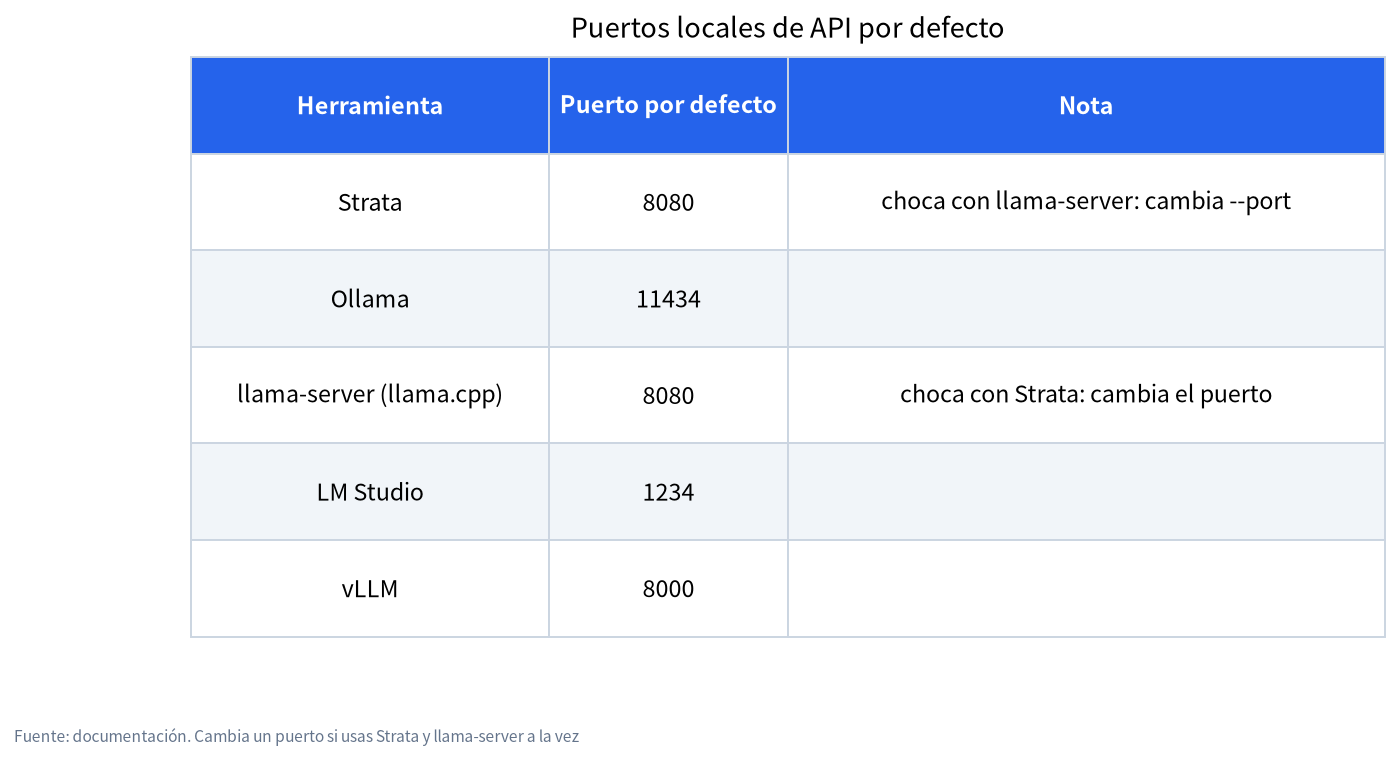
No. Usan puertos por defecto y carpetas de modelos distintos. Solo no cargues dos modelos grandes en la misma GPU a la vez.
Habla con nosotros
Si no sabes qué herramienta encaja con tu GPU y tu presupuesto, únete a la comunidad o escribe a admin@microaione.com con tu GPU, RAM y uso previsto. Si prefieres una máquina montada y probada para esto, consulta la guía de máquinas y soluciones.