Strata是什么?这款本地大模型引擎为何爆火,和Ollama有何不同
更新于 2026-11-04。 本文是对公开资料的解读。我们没有安装过 Strata,也没有自己跑过任何测试。
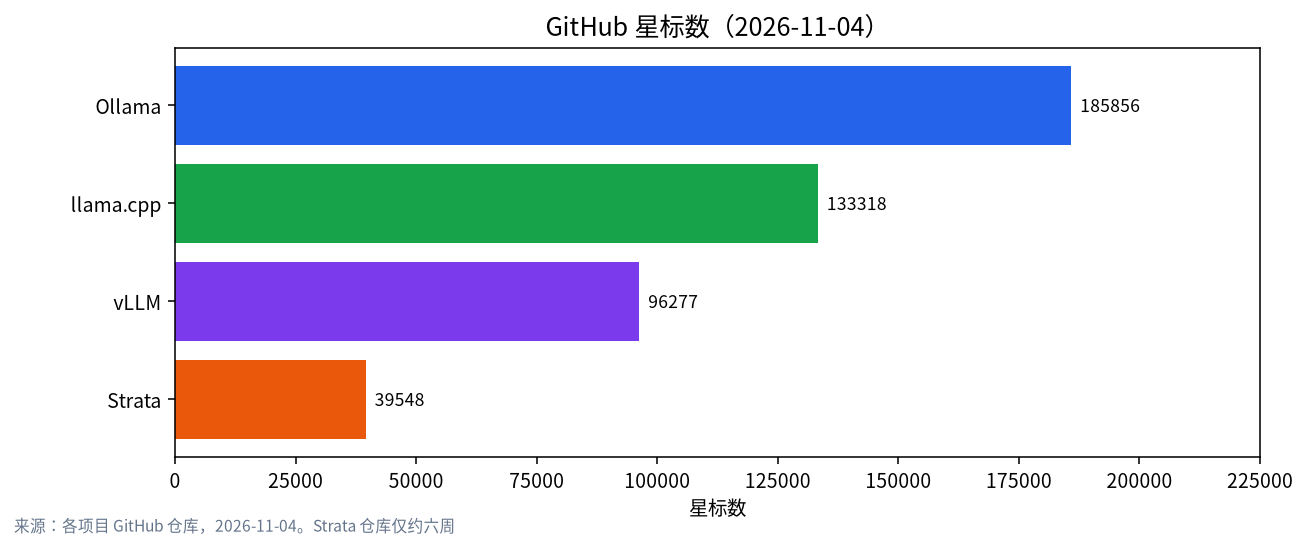
Strata是什么?它是一个开源的推理引擎,以桌面应用和终端工具两种形式发布,只做一件事:让一台普通的游戏电脑跑起超大的混合专家(MoE)模型,比如 1250 亿参数的 Qwen3.8-Flash-Next。办法是把模型拆开,分别放在显卡、系统内存和固态硬盘里。仓库创建大约六周,已有约 39,500 个 GitHub 星标,几乎每个本地大模型论坛都有关于它的帖子。下面我们讲清楚:Strata 到底是什么、为什么传得这么快、独立测试者量到了什么、风险在哪里。它是 Ollama 旁边的另一个选项,不是 Ollama 的替代品,对比见Strata 与 Ollama 对比文章。
Strata是什么:一段话讲清
Strata 发布在 GitHub,引擎采用 MIT 许可,仓库主要用 C++ 编写。它可以装成桌面应用(Windows、Linux AppImage、macOS),也可以用终端里的 strata launch 启动。模型跑起来之后,它在本机提供 OpenAI Chat Completions、Anthropic Messages 和 Responses 三种接口,编程工具可以直接连。文档把 ggml(llama.cpp 背后的张量库)列为第三方组件,但让 Strata 与众不同的调度逻辑是它自己的。
| 项目 | 2026-11-04 的数值 | 来源 |
|---|---|---|
| 仓库创建时间 | 2026-09-24 | GitHub |
| 星标 / 分叉 | 39,548 / 4,298 | GitHub |
| 最新版本 | v0.2.10(2026-11-02,UTC) | GitHub 发布页 |
| 引擎许可 | MIT | 仓库 |
| 模型许可 | Qwen3.8-Flash-Next 权重使用 Qwen Community License 1.0,不是 MIT | 项目文档 |
| 默认本地地址 | http://127.0.0.1:8080 |
安装文档 |
| 遥测 | 项目称无遥测、无需账号 | 安全文档 |
| 外部安全审计 | 同一文档称尚未做过 | 安全文档 |
Strata 能跑哪些模型
混合专家模型里有很多“专家”子网络,每生成一个 token 只用其中几个。Qwen3.8-Flash-Next 总参数约 1250 亿,但每个 token 只激活约 60 亿(每层 512 个专家,共 24,576 个,原生上下文 262,144 个 token)。大约只有 5% 的权重参与每一步计算,这正是 Strata 利用的地方。
| 模型 | 规模 | 文档说法 |
|---|---|---|
| Qwen3.8-Flash-Next | 总 125B,激活约 6B | 四档量化,权重占用内存加显存分别为 37.6 GB(Q2_0)、39.2 GB(IQ2_XS)、47.0 GB(IQ3_XXS)、54.8 GB(IQ3_S) |
| Qwen3.6-35B-A3B | 总 35B,激活约 3B | Unsloth 打包,32 到 52 GB 内存 |
| DeepSeek V4.1-Flash | 极大 | 下载 239 到 274 GB,12 GB 显卡,46 到 64 GB 内存,见12GB 显存跑 DeepSeek V4.1 Flash |
想弄懂 MoE 模型为何有这种特点,可以看MoE 模型本地运行指南。
Strata 的原理:三层放置
Strata 官方的 HOW_IT_WORKS 文档把模型分成三层。
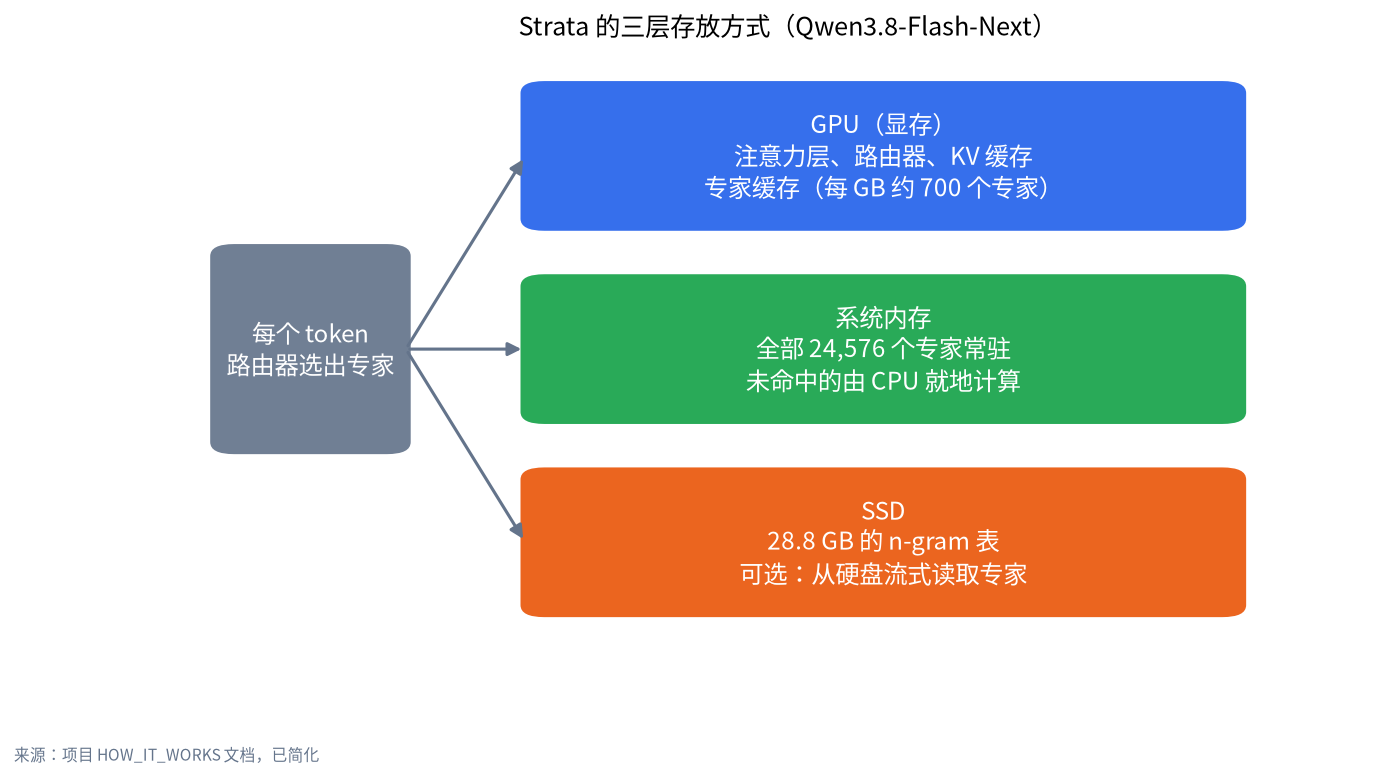
- 显卡。 放注意力层、路由器、共享专家、输出头、多 token 预测(MTP)草稿层、KV 缓存,以及用剩余显存建立的专家缓存。文档称每多 1 GB 显存大约能多放 700 个专家。
- 内存。 放全部 24,576 个专家,并锁定在内存里。路由器选中的专家不在显存时,由 CPU 就地计算,而不是复制到显卡。
- 固态硬盘。 放一张 28.8 GB 的 n-gram 嵌入表,每个 token 只读其中几行。内存不够时还有可选的
--mmap-experts模式,从硬盘流式读专家,能用,但慢得多。
速度取决于一个 token 需要的专家有多少已经在显卡上。PC Watch 在 RTX 3060 上的测试报告:IQ2_XS 文件下显卡里约有 3,031 个专家,缓存命中率约 72%;IQ3_S 下约 1,104 个专家,命中率 56%。项目论文称 MTP 推测解码带来 1.6 到 1.8 倍加速,这是作者自己的数字。
Strata 为什么爆火
综合我们读到的资料,有几个因素叠在了一起:
- 一键安装。 Windows 安装包、Linux AppImage、macOS 镜像,外加一行终端安装命令,首次启动时自动下载适合你显卡的引擎。
- 一句好传播的标题。 “12GB 显卡跑 125B 模型”很容易转发,虽然完整的账是较大的量化档需要 64GB 内存。
- 时机。 Qwen3.8-Flash-Next 本来就是十月大家热议的模型。
- 支持编程智能体。
strata connect可以为 Claude Code、Codex CLI、OpenCode、Hermes Agent、OpenClaw 等写入配置。 - 发布节奏很快。 10 月 25 日到 11 月 2 日之间发了六个版本。
- Hacker News 的热度。 一个帖子在我们读到时有 940 分、420 条评论,另一个帖子则抱怨本地大模型讨论被 Strata 链接刷屏。主帖在这里。
独立测试者报告了什么
下面所有数字都不是我们测的。它们来自不同的硬件、Strata 版本和量化档,请当作一个范围,而不是排行榜。
| 来源 | 硬件 | 模型与量化 | 报告结果 |
|---|---|---|---|
| Strata 社区基准(v0.1.41) | RTX 3060 12 GB,DDR4-3200 | Q2_0 / IQ2_XS / IQ3_XXS | 4,096 token 提示下生成 42.9 / 45.5 / 26.2 tok/s |
| PC Watch(v0.1.38) | RTX 3060 12 GB,Core i9-12900,64 GB DDR4 | IQ2_XS;IQ3_S | 34 到 44;25 到 32 tok/s。5.9k token 提示约 7 秒出首字,23k 约 25 秒 |
| note.com,usshi_it | RTX 3060 12 GB,Ryzen 5 3600,48 GB | Q2_0 | 生成 44.49 tok/s,预填充 326.68 tok/s,首字 1.60 秒 |
| Siddhant Dembi | Proxmox 虚拟机里的 RTX 3060,约 50 GiB 内存 | IQ3_S | 约 36 到 38 tok/s;需要设推理预算以免无休止思考 |
| AkitaOnRails | RTX 5090 | IQ3_S | 约 159 tok/s,作者自己的编程基准得分 91 |
| arm1.ru | RTX 5080 笔记本,30 GB 内存 | Flash-Next 对比 llama.cpp 里的 Qwen3.8-27B | 编程质量相近;Strata 占约 21 GB 内存,4 到 5 GB 进了交换区,1.3 小时测试中从 SSD 读了约 6.9 TB |
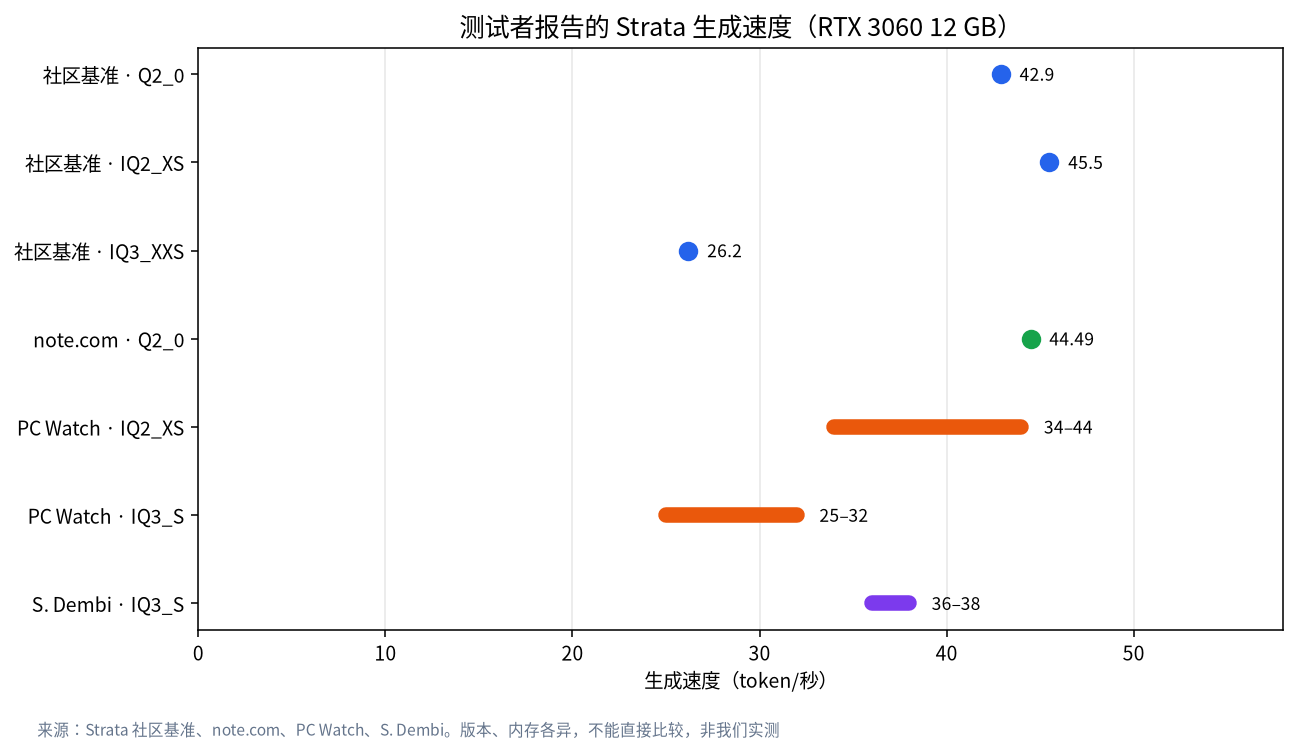
同一张 RTX 3060 就能产生约 20 到 45 tok/s 的各种结果,取决于量化档、版本和内存。所以“Strata 到底多快”没有唯一答案。
争议与风险
- 2 到 3 位量化的质量。 项目称 IQ3_S 在其公布的测试中与完整模型相当,这是作者的说法。PC Watch 发现 IQ2_XS 的代码生成比 IQ3_S 弱一档;Hacker News 上也有质疑,有用户报告在一项视觉测试中,同样的权重在 Strata 上的误差比 llama.cpp 大,我们无法验证。
- 12GB 显卡上长提示很慢。 PC Watch 测得 23k token 的提示要等约 25 秒才出首字,对一次发整个文件的编程智能体不友好。
- 内存压力。 arm1.ru 的测试里,30 GB 内存的笔记本整个过程都在换页,SSD 一直很忙。
- 项目很年轻。 仓库只有六周,每两天左右就有新版本,设置和速度会随版本变化;文档自己也说没有做过外部安全审计。
- 管道式安装。 一行安装命令方便,但它是以你的用户权限执行的脚本。先读一遍,或使用有签名的应用安装包。
- 模型许可。 引擎是 MIT,但 Qwen 权重适用 Qwen Community License,商用前请先阅读。
- 数字并不一致。 有些文章写 1760 亿参数,仓库写的是 1250 亿,我们采用后者。
Strata 与 Ollama 一览
| Strata | Ollama | |
|---|---|---|
| 主要目标 | 通过显卡、内存、SSD 分层,让特定的超大 MoE 模型在小显存上运行 | 通用模型管理器:拉取、运行、服务大量中小型模型 |
| 星标(2026-11-04) | 39,548 | 185,856 |
| 模型 | Qwen3.8-Flash-Next、Qwen3.6-35B-A3B、DeepSeek V4.1-Flash | 庞大的模型库,见 ollama.com/library |
| 我们看到的最新版本 | v0.2.10(11 月 2 日) | v0.40.14(11 月 3 日) |
| Qwen3.8-Flash-Next | 可在 Windows、Linux、macOS 上运行 | 库页面只显示一个标签 125b-mlx(105 GB,面向 Apple 芯片);我们没找到面向 NVIDIA 显卡的标签,也没有测试 |
两者的重叠比标题显示的要小。想用一个工具管很多模型,Ollama 依然更省事;想在 12 到 24 GB 显卡上跑这一类模型,Strata 是专门为此做的。与 llama.cpp、LM Studio 的完整对比见对比文章,安装步骤见安装指南,硬件需求见硬件需求文章。如果你还没接触过 Ollama,先看Ollama 安装指南。
谁适合试 Strata,谁可以先观望
这一节是我们根据上面的资料做的判断,不是项目方的说法,也没有经过我们自己的实测。
- 适合试的人: 手里有 12 GB 以上的 NVIDIA 显卡或较新的 AMD、Apple 芯片,内存有 48 GB 以上,并且确实想本地运行 Qwen3.8-Flash-Next 这一类超大 MoE 模型,用来写代码或做长文本分析。
- 可以先观望的人: 内存只有 16 到 32 GB,或者日常只用 7B 到 30B 的小模型。这种情况下 Ollama 或 LM Studio 更省事,Strata 的优势发挥不出来。
- 需要小心的人: 想把它放在局域网或公网上给别人用的人。项目要求跨设备访问时设置 API 密钥,并且没有经过外部安全审计,请先读完官方的安全文档,再决定要不要开放访问。
另外有三个常见误解值得澄清。第一,“显存只要 12GB”不等于“电脑只要 12GB”,内存和硬盘同样重要,具体账见硬件需求文章,其中还列出了各档配置下测试者报告的速度,方便你对照自己的电脑。第二,Strata 不是 llama.cpp 的换皮,文档把 ggml 列为组件,但专家缓存和调度是它自己的实现。第三,速度数字不能脱离量化档、上下文长度和版本去谈,同样一张 RTX 3060,不同测试者就量出了从二十多到四十多 tok/s 的结果。
我们做了什么,没做什么
2026-11-04 当天,我们阅读了 Strata 仓库文档和发布说明、Ollama 的发布说明与库页面,以及上文链接的第三方报告。我们没有安装 Strata,没有下载任何权重,也没有测量任何速度。每个数字都标明了来源。
常见问题(FAQ)
用最简单的话说,Strata 是什么?
Strata 是一个免费程序,让普通电脑也能跑超大的 AI 模型:最忙的部分放在显卡上,其余放内存,一张查找表放在固态硬盘上。它是引擎加聊天应用,不是模型本身。
Strata 免费、开源吗?
引擎使用 MIT 许可。它下载的模型有各自的许可,Qwen3.8-Flash-Next 使用 Qwen Community License 1.0。
真的是 12GB 显卡跑 125B 模型吗?
模型总参数是 1250 亿,但每个 token 只激活约 60 亿。Strata 仍然需要约 38 到 55 GB 的内存加显存来放模型,另需约 80 GB 磁盘,所以 12GB 显卡只是显卡这一部分的最低要求。
Strata 和 Ollama 能装在同一台电脑上吗?
可以。Strata 默认监听 8080,Ollama 是 11434,但它们抢同一份显存和内存,所以一次只跑一个大模型。安装指南里有详细说明。
安装 Strata 安全吗?
项目称没有遥测、不需要账号,服务只监听本机,但也承认没有外部安全审计。建议先在没有敏感数据的机器上装,并且只从官方仓库下载。
Strata 会取代 Ollama 吗?
不会。两者解决的问题不同。很多人会保留 Ollama 跑日常模型,只为某个大型 MoE 模型再装 Strata。
和我们聊聊
对显卡、内存和预算有疑问?欢迎加入社区,或发邮件到 admin@microaione.com,我们一起帮你理一理。如果你希望直接买一台调试好的整机,可以看我们的整机与方案指南和本地大模型一体机选购指南。