Guía de instalación de Strata: cómo ponerlo junto a Ollama en Windows o Linux, paso a paso
Actualizado 2026-11-04. Esta guía de instalación de Strata sigue la documentación del propio proyecto (INSTALL.md y TERMINAL_LAUNCH.md) a fecha de v0.2.10. No hemos ejecutado el instalador nosotros mismos, así que cada paso se atribuye a su fuente y debes leer la documentación actual antes de empezar.
Esta guía de instalación de Strata es para quien ya usa Ollama. Si quieres probar Strata con un modelo muy grande como Qwen3.8-Flash-Next, la buena noticia es que ambos no se pelean por puertos ni carpetas de modelos. La mala es que sí se pelean por la memoria gráfica y la RAM. Esta guía cubre las comprobaciones previas, las dos formas de instalar, los comandos importantes, cómo conectar herramientas de programación, cómo ejecutar Strata junto a Ollama y qué dicen los probadores que sale mal. Si aún dudas de si lo necesitas, lee antes nuestra comparación Strata vs Ollama.
Antes de empezar
| Comprobación | Qué dice la documentación |
|---|---|
| Sistema operativo | Windows 10/11 o Linux x86-64 para tarjetas NVIDIA RTX; macOS 15 o posterior en Apple Silicon; Linux para Intel Arc; guías aparte para AMD Radeon, Ryzen AI Max y DGX Spark |
| Controlador NVIDIA | Los paquetes CUDA 13 necesitan el controlador 580 o posterior; las tarjetas más antiguas usan un motor CUDA 12 |
| Memoria de GPU | Se recomiendan 12 GB o más para Qwen3.8-Flash-Next |
| RAM | Depende del tamaño que elijas, de unos 38 a 55 GB solo para el modelo; véase la sección siguiente |
| Disco | Unos 80 GB libres en un SSD, según un analista que siguió la documentación; DeepSeek V4.1-Flash necesita mucho más |
| Internet | Necesario para descargar modelos y actualizaciones del motor |
Instala primero un controlador gráfico; los paquetes de Strata no lo sustituyen. Después cierra otros programas que usen mucho la GPU. La planificación de memoria se trata en nuestro artículo de requisitos de hardware.
Guía de instalación de Strata: dos formas de instalar
| Aplicación de escritorio | Terminal | |
|---|---|---|
| Ideal para | Una ventana con chat y ajustes | Herramientas de programación, servidores y scripts |
| Cómo | Descarga el instalador de la última versión: un .exe para Windows (sin permisos de administrador), un AppImage de Linux o un .dmg de macOS |
Ejecuta el instalador de una línea y luego strata launch |
| Motor | Se descarga en el primer arranque para tu GPU | Se obtiene con el primer modelo, con firma comprobada y arranque de prueba |
Para la terminal, la documentación da un comando para Linux y macOS que primero guarda el script y luego lo ejecuta, y un comando de PowerShell para Windows. Abre el script y léelo antes de ejecutarlo; se ejecuta con tus permisos de usuario.
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh
less install.sh
sh install.sh
En PowerShell de Windows, la línea documentada es irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex; si prefieres, descarga el archivo, léelo y luego ejecútalo. Abre una terminal nueva después para que strata esté en el PATH. Si un AppImage no arranca porque falta FUSE, la documentación sugiere ejecutarlo con --appimage-extract-and-run.
Paso a paso en la terminal
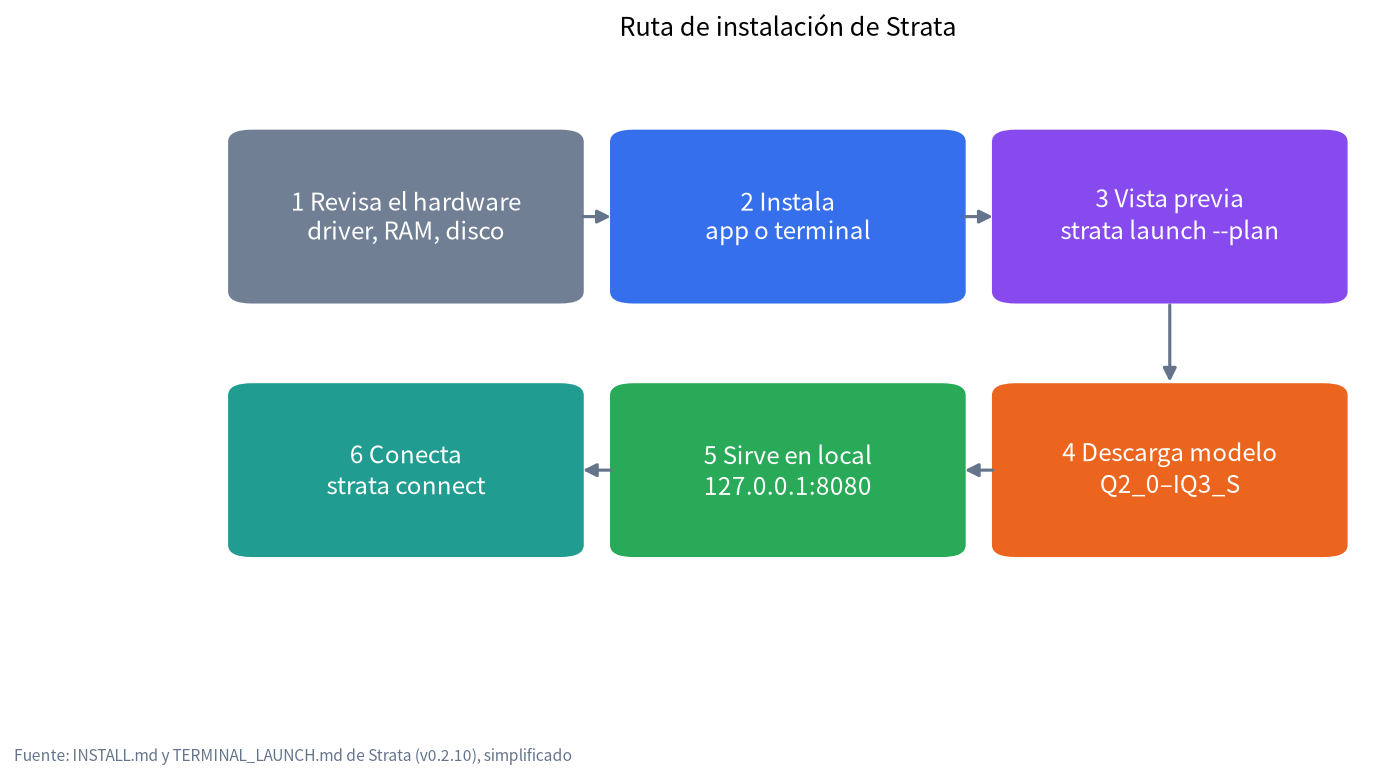
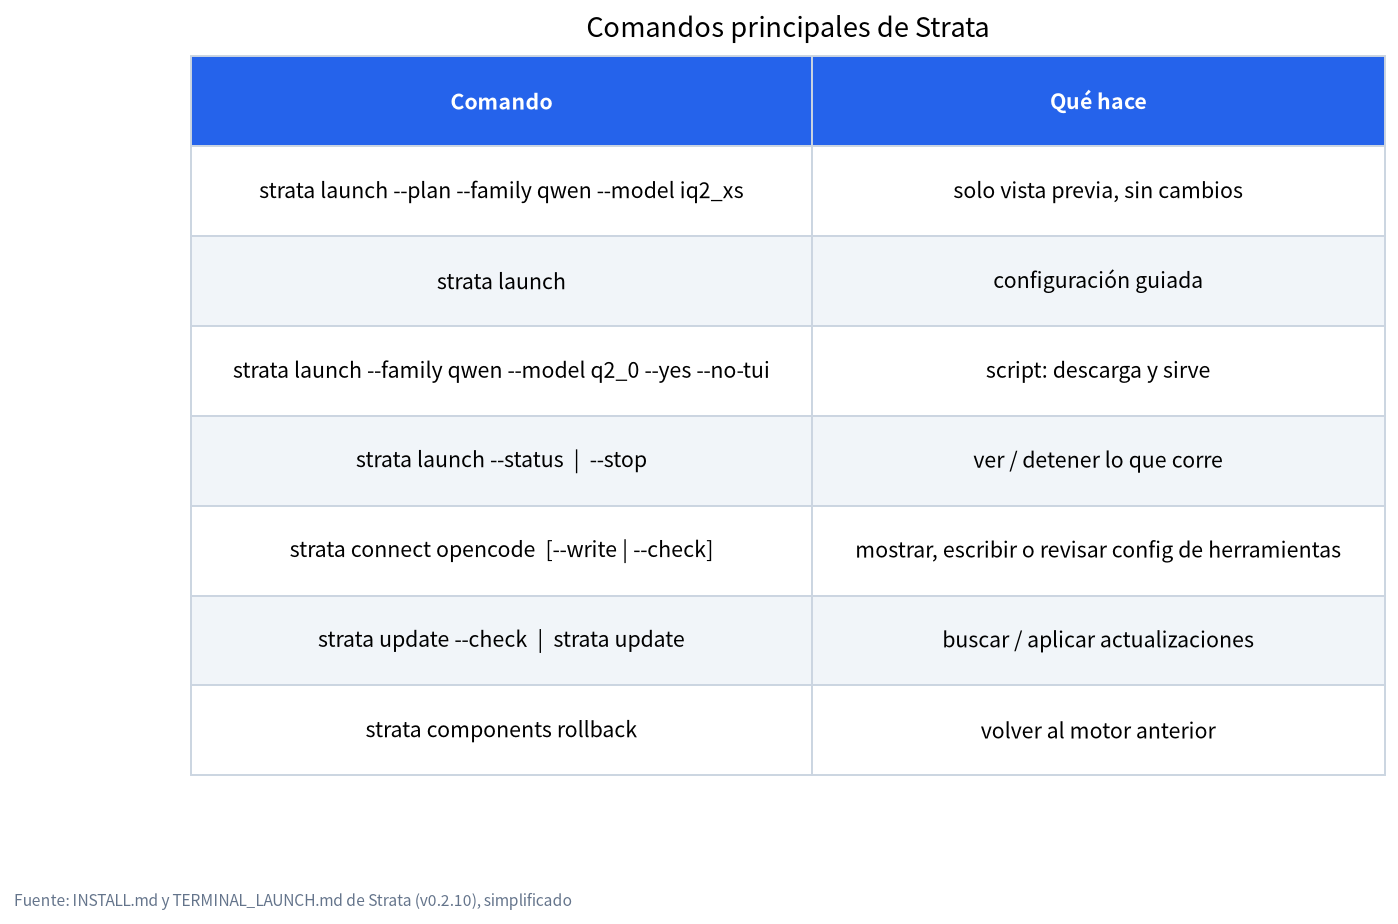
- Primero, vista previa.
strata launch --plan --family qwen --model iq2_xsmuestra lo que ocurriría y no cambia nada. También te dice qué falta. - Configuración guiada. Ejecuta
strata launchy sigue las pantallas: modelo, carpeta, contexto (de 8K a 512K), imágenes, peticiones paralelas, ajuste, acceso y un preajuste guardado. Para las peticiones paralelas el valor por defecto se adapta a tu tarjeta: 1 en una GPU de 12 GB, 2 en 20 GB, 3 en 24 GB y 4 con 32 GB o más. El ajuste rápido dura unos 20 minutos y es opcional. - Configuración por script.
strata launch --family qwen --model q2_0 --yes --no-tuidescarga, sirve, muestra la dirección y termina.strata launch --statusmuestra lo que está en marcha ystrata launch --stoplo detiene.
Qué tamaño elegir
| Tamaño | RAM + VRAM para el modelo | La descripción de la documentación |
|---|---|---|
| Q2_0 | 37,6 GB | El más rápido, buena calidad |
| IQ2_XS | 39,2 GB | Rápido, mejor calidad |
| IQ3_XXS | 47,0 GB | Más lento, gran calidad |
| IQ3_S | 54,8 GB | El más lento, la mejor calidad; la documentación dice que iguala al modelo completo en las pruebas publicadas |
Deja memoria para el sistema operativo. En una tarjeta de 12 GB con 64 GB de RAM, los probadores han usado IQ2_XS e IQ3_S. PC Watch encontró cómodas las conversaciones cortas con IQ2_XS, pero la generación de código un escalón por debajo de IQ3_S, así que elige el tamaño mayor si programas y tienes la RAM.
Comprueba que el servidor funciona
La dirección por defecto es http://127.0.0.1:8080. Strata expone /health, /v1/models, la ruta OpenAI Chat Completions /v1/chat/completions, la ruta Anthropic /v1/messages y una ruta Responses.
curl http://127.0.0.1:8080/health
curl http://127.0.0.1:8080/v1/models
Usa en tu cliente el nombre de modelo que devuelve /v1/models. Cualquier cliente compatible con OpenAI, incluido Open WebUI (véase nuestra guía de Open WebUI), puede apuntar a http://127.0.0.1:8080/v1. El servidor escucha solo en tu PC. Si lo abres a tu red, a un túnel de Cloudflare o a Tailscale, configura una clave de API, porque sin ella cualquiera que llegue al puerto puede usar el modelo y sus herramientas. Nuestra guía de servidor de API de LLM local cubre las reglas generales de seguridad.
Conecta herramientas de programación con strata connect
strata connect lista OpenCode, Codex CLI, Claude Code, oh-my-pi, pi, Hermes Agent y OpenClaw. strata connect opencode muestra la configuración, --write la escribe tras preguntar (lo que se reemplaza queda en copia de seguridad) y --check envía un prompt y una llamada a herramienta como lo haría esa aplicación. La documentación enumera límites conocidos: Claude Code necesita el ajuste CLAUDE_CODE_MAX_CONTEXT_TOKENS, OpenCode necesita limit.input, Hermes rechaza ventanas de menos de 64K salvo que se configure y OpenClaw necesita Node 24.16 o posterior. Un probador que usaba OpenCode vio que una llamada a herramienta emitida como texto plano terminaba una tarea antes de tiempo y lo arregló con la opción tool_call_recovery de Strata; lee ese informe.
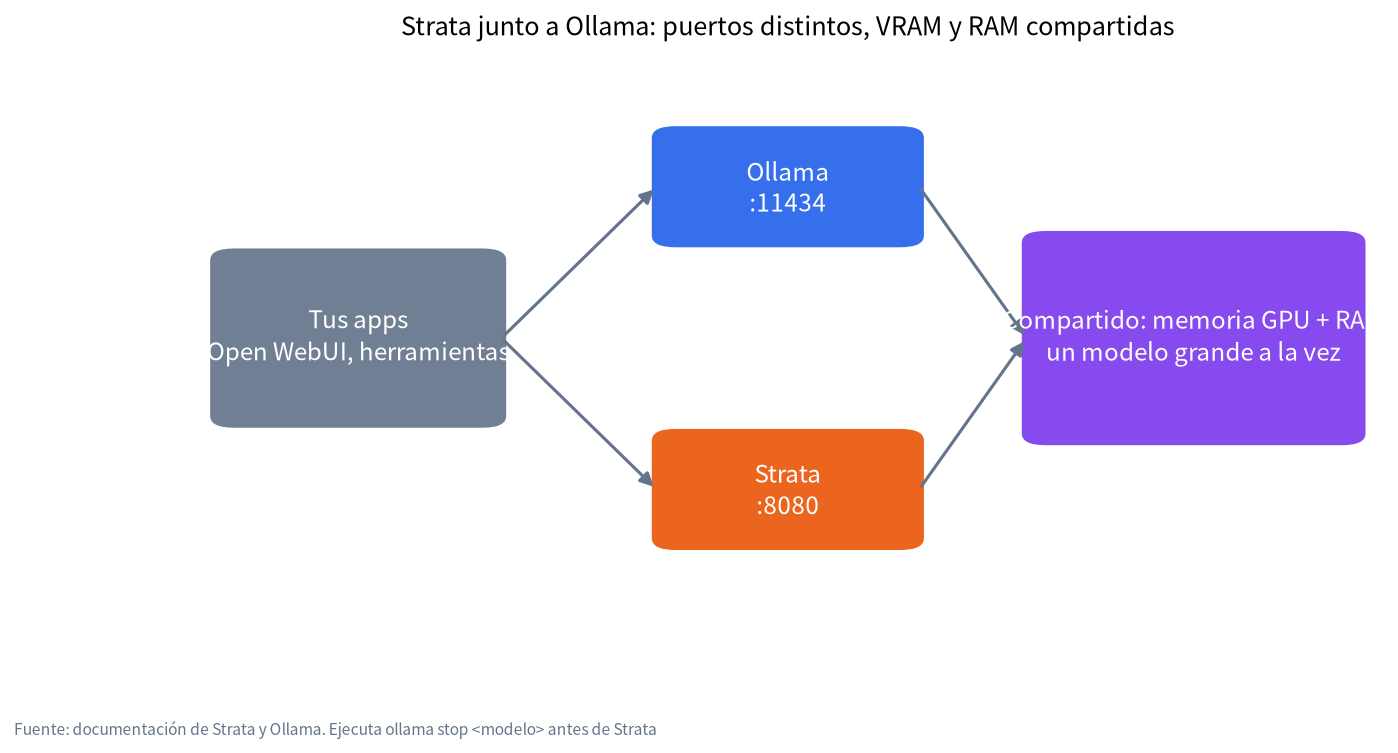
Ejecutar Strata junto a Ollama
| Tema | Strata | Ollama | Qué hacer |
|---|---|---|---|
| Puerto por defecto | 8080 | 11434 | Sin conflicto. Cambia --port de Strata si otra herramienta ya usa el 8080 |
| Archivos de modelo | Su propia carpeta de instalación (~/.local/share/strata/install en Linux, %LOCALAPPDATA%\Strata\install en Windows) |
La carpeta de modelos de Ollama; véase nuestra guía de la ruta de modelos de Ollama | Mantenlas separadas; la documentación de Strata no describe importar desde Ollama |
| Memoria de GPU | Llena la VRAM con una caché de expertos | Carga un modelo cuando se pide y lo descarga tras un tiempo inactivo | Ejecuta ollama stop <modelo> antes de iniciar Strata |
| RAM | Fija todos los expertos en RAM | Carga por modelo | No ejecutes dos modelos grandes a la vez |
strata models import PATH --plan de Strata reconoce conjuntos de archivos concretos que instala el propio Strata; no se copia ni se mueve nada. No encontramos nada en la documentación sobre reutilizar los archivos de modelo que Ollama descargó, así que supón que descargarás los paquetes de Strata aparte. Para Ollama en sí, consulta nuestra guía de instalación de Ollama.
Solución de problemas según informes públicos
| Síntoma | Causa probable | Qué hicieron los probadores |
|---|---|---|
| El primer minuto es muy lento | Se están descargando o cargando el motor y los paquetes | Esperar y luego revisar strata launch --status |
| El sistema se ralentiza y crece el swap | RAM insuficiente para el tamaño | Elegir un tamaño menor o cerrar aplicaciones; un portátil con 30 GB de RAM hizo de 4 a 5 GB de swap |
| Piensa mucho y nunca responde | El razonamiento se desboca | Un probador en Proxmox fijó un presupuesto de razonamiento de 4.096 tokens y mantuvo IQ3_S |
| Primer token lento con archivos largos | Prefill en una tarjeta de 12 GB | Contexto más corto o prompts más pequeños; PC Watch vio unos 25 s con 23k tokens |
| Parece que faltan ajustes | Algunas opciones están en settings.json |
Un usuario japonés de note.com las encontró sin documentar en su momento; consulta la documentación actual |
| Puerto ya en uso | Otro servidor en el 8080, como llama-server |
Pasar otro --port |
Lista de comprobación segura para el primer arranque
Como Strata es nuevo y cambia rápido, unos hábitos ahorran problemas.
- Usa primero un equipo de pruebas o una cuenta de usuario limpia. El instalador es cómodo, pero ejecutas el script de otra persona, y el propio proyecto dice que no ha tenido auditoría de seguridad externa.
- Ejecuta el plan antes de descargar.
strata launch --planmuestra qué archivos se van a obtener y cuánto espacio ocupan, para que no descubras un disco lleno a los 30 GB de una descarga. - Empieza con el tamaño más pequeño. Q2_0 o IQ2_XS muestra si tu RAM, controlador y refrigeración están bien antes de comprometerte con los paquetes grandes.
- Mantenlo en localhost. Deja el acceso en «solo este equipo» hasta que el modelo funcione. Si luego lo compartes, activa la clave de API.
- Anota lo que funciona. Guarda un preajuste con nombre para reiniciar con los mismos ajustes tras una actualización.
- Vigila temperaturas y memoria. El SSD de un probador leyó unos 6,9 TB en una ejecución de 1,3 horas y el portátil de otro hizo swap; una ventana de monitor o la pestaña de monitor de Strata mostrará los problemas pronto.
Actualizar
En la terminal, strata update --check y strata update gestionan las actualizaciones del motor; con un modelo cargado, el comando pregunta antes de detenerlo. strata components rollback vuelve al motor anterior. En la aplicación, usa los controles de actualización en Ajustes. Como las versiones llegan cada dos días más o menos, revisa las notas de versión antes de actualizar una configuración que funciona.
Lo que hicimos y lo que no
El 2026-11-04 leímos los documentos INSTALL, de terminal y de modelos del proyecto y los informes de terceros enlazados arriba. No instalamos Strata, así que ningún comando de aquí fue ejecutado por nosotros. Los números de versión y las opciones cambian rápido; confía en strata launch --help antes que en esta página.
Preguntas frecuentes (FAQ)
¿Pueden Strata y Ollama ejecutarse a la vez?
Sí, en puertos distintos, pero comparten memoria de GPU y RAM. Detén el modelo de Ollama antes de cargar uno grande en Strata.
¿Tengo que desinstalar Ollama primero?
No. Usan puertos y carpetas de modelos distintos.
¿Puede Strata reutilizar los modelos que ya descargué con Ollama?
No encontramos una importación documentada desde Ollama. Strata descarga sus propios paquetes, así que cuenta con el espacio de disco extra.
¿Cuánto espacio de disco necesito?
Unos 80 GB libres para Qwen3.8-Flash-Next según un analista que siguió la documentación, y de 239 a 274 GB para DeepSeek V4.1-Flash según el proyecto.
¿Es seguro ejecutar el instalador de una línea?
Es un script que se ejecuta con tus permisos de usuario. Guárdalo, léelo y descarga solo del repositorio oficial. El proyecto dice que no envía telemetría, pero también que no ha tenido auditoría de seguridad externa.
¿Qué dirección usan mis aplicaciones?
http://127.0.0.1:8080/v1 para clientes compatibles con OpenAI. Usa el nombre de modelo que muestra /v1/models.
Habla con nosotros
¿Atascado con un controlador, un límite de memoria o una conexión? Únete a la comunidad o escribe a admin@microaione.com con tu GPU, tu RAM y el texto del error. Si prefieres una máquina probada, consulta nuestra guía de máquinas y soluciones.