DeepSeek V4.1 Flash 本地部署指南:Obliterated 版需要多少显存与预算
想在自己的机器上做 DeepSeek V4.1 Flash 本地部署,最先要回答的不是“怎么装”,而是“放不放得下”。我们在 Obliterated 版的评测解读里提到,这个版本是 754.6B 参数、BF16 精度、模型库文件总量约 1.51 TB 的检查点,比原版 DeepSeek-V4.1-Flash-1017(约 510 GB)大了近三倍,所以原版的部署经验不能直接套用。本文按内存容量把可行路线排成梯度,给出体积推算、硬件和成本的量级、一条概括性的下载与量化流程,以及我们不能确认的地方。我们没有下载或运行过这个模型,所有体积数字要么来自模型库,要么是公式推算,会逐条标明。
要点速览(更新于 2026-11-01)
- 官方 BF16 权重约 1.51 TB(83 个分片),权重本身就需要约 1.7 TB 以上的显存才能全部放进 GPU;单张 96GB 的卡差得很远。
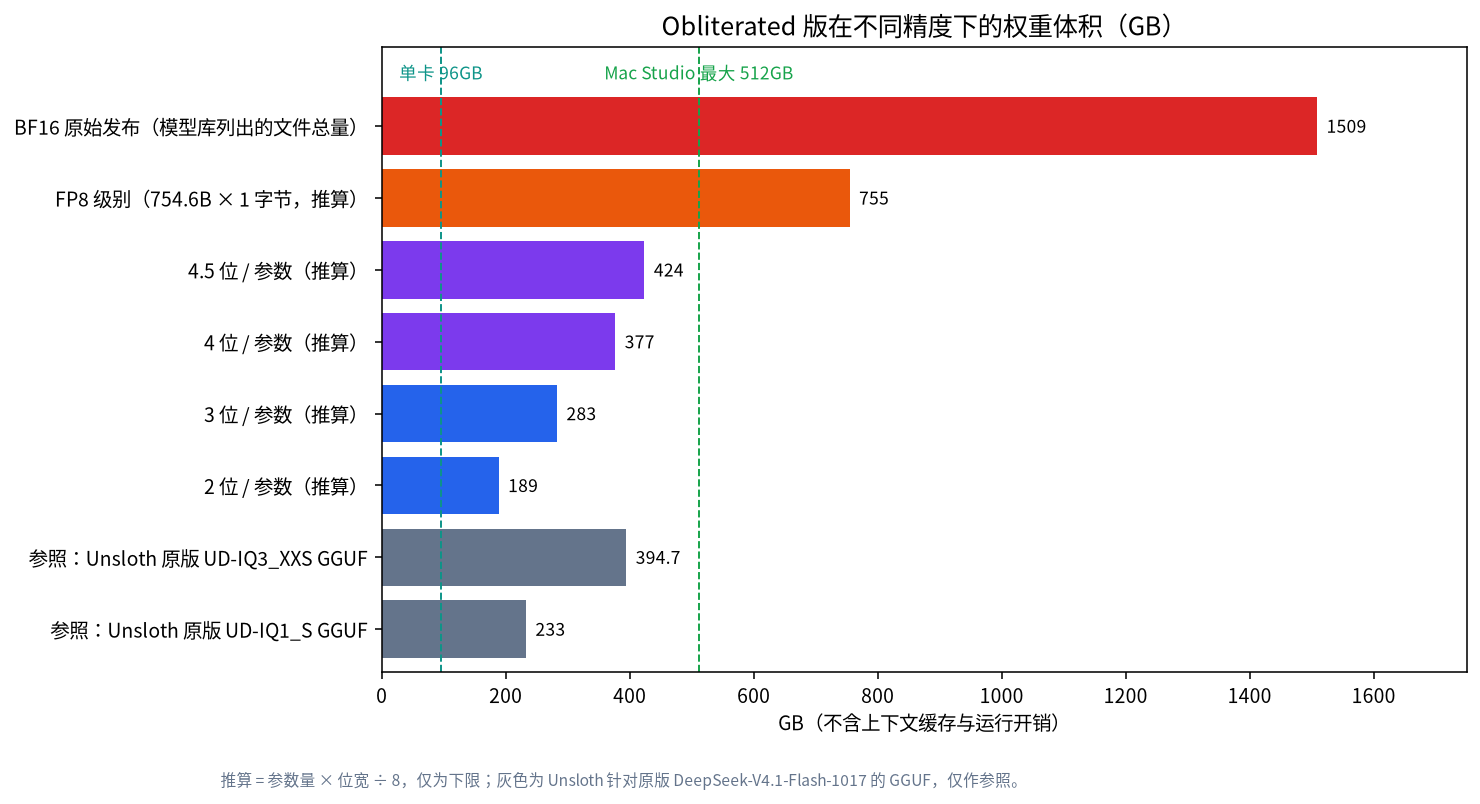
按“参数量 × 位宽 ÷ 8”推算,FP8 级约 755 GB,4 位约 377 GB,3 位约 283 GB。这是下限,真实 GGUF 量化是混合精度,还要加上下文缓存和运行开销。
成本粗估:一台满配 512GB 的 Mac Studio 约 2.23 万美元;若用 RTX PRO 6000(单卡约 1.6 万美元),3 位级约需 4 张、4 位级约需 5 张,仅显卡就是 6.4 至 8 万美元。
- 我们没有找到该检查点的官方 GGUF,也没有验证它的 deepseek_v41_text 配置能否被转换器直接处理;量化后质量需要自己重新评测。
DeepSeek V4.1 Flash 本地部署之前:它为什么这么大
这个检查点的配置显示,它是一个混合专家(MoE)模型:40 层、隐藏维度 5120、384 个路由专家、每个 token 激活 6 个,最大上下文 1,048,576 个 token,精度为 bfloat16,架构名 DeepseekV41ForCausalLM。MoE 的特点是每个 token 只用一小部分参数,但所有专家都得驻留在内存里,所以内存占用看总参数,而不是激活参数。想系统了解这一点,请读我们的 MoE 模型本地运行指南。
原版 DeepSeek-V4.1-Flash-1017 使用 FP8 加 FP4 专家的混合精度,约 510 GB;Obliterated 版保存成 BF16,体积约 1,509 GB。Unsloth 的指南还提到该模型由约 552B 的主干和约 196B 的 Engram 参数表构成,其中 Engram 表为 110.6–202.8 GB,可以通过 mmap 放在 SSD 上,用时按需读取。这套办法是针对原版 GGUF 描述的;它对 Obliterated 版是否同样适用,我们没有验证。
不同精度需要多少内存
| 精度 | 公式 | 权重体积(推算下限) | 说明 |
|---|---|---|---|
| BF16(官方) | 模型库文件总量 | 约 1,509 GB | 可直接加载,不需要转换 |
| FP8 级 | 754.6B × 1 字节 | 约 755 GB | 需要自己重新量化 |
| 4.5 位 | 754.6B × 4.5 ÷ 8 | 约 424 GB | 接近常见的 Q4 类 GGUF |
| 4 位 | 754.6B × 4 ÷ 8 | 约 377 GB | 实际混合精度会略大 |
| 3 位 | 754.6B × 3 ÷ 8 | 约 283 GB | 质量开始受影响 |
| 2 位 | 754.6B × 2 ÷ 8 | 约 189 GB | 质量损失更明显 |
作为参照,Unsloth 为原版 DeepSeek-V4.1-Flash-1017 发布的 GGUF 中,UD-IQ3_XXS 为 394.7 GB,UD-IQ1_S 为 233.0 GB,UD-Q8_K_XL 为 508.4 GB。它们对应的是另一个检查点,数字只能说明量化后的体积大致落在什么区间。上面的推算只算权重,下面几项还要另外留出空间。
- 上下文缓存。 上下文越长,缓存越大,支持 1M 上下文不等于每台机器都能用满。
- 运行开销。 激活值、缓冲区和多卡通信都要占内存,我们的成本估算统一多留 10%。
- 磁盘。 下载约 1.51 TB,如果还要转换,再加上中间文件和量化结果,建议准备至少约 3.5 TB 的空闲 NVMe 空间。
硬件路线与成本粗估
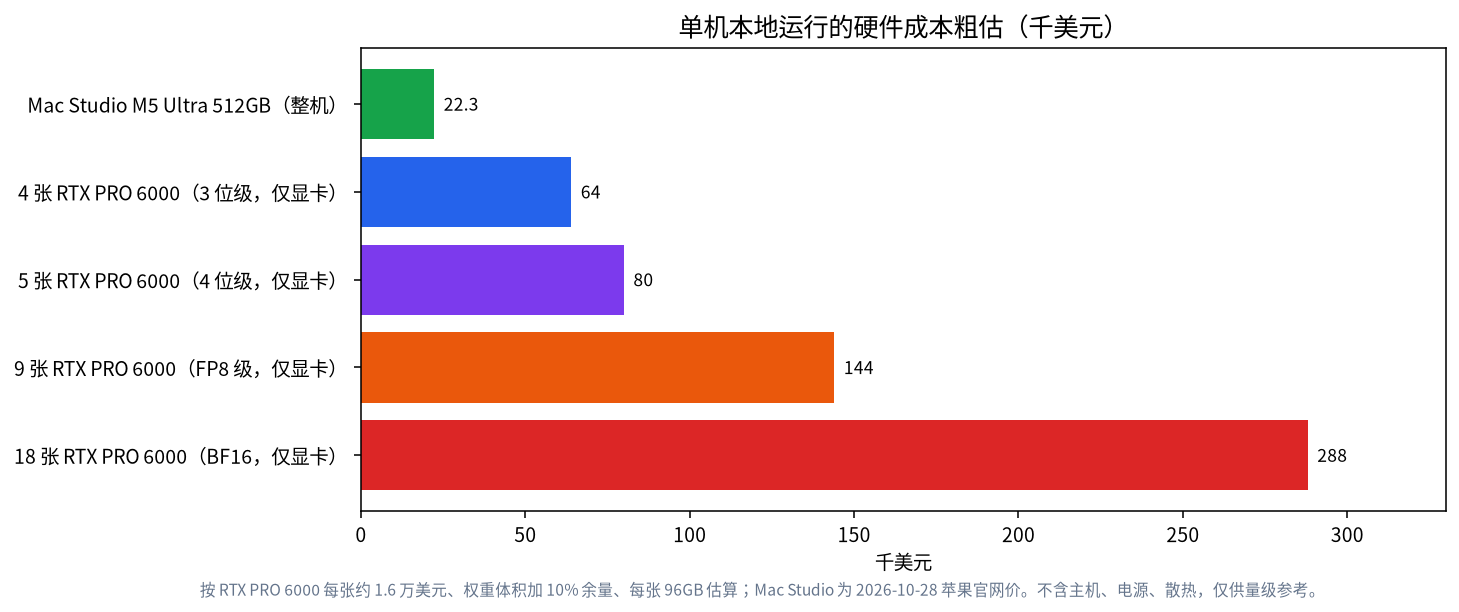
| 路线 | 能放下的精度 | 硬件量级 | 成本粗估(仅显卡或整机标价) | 主要限制 |
|---|---|---|---|---|
| 18 张 96GB 显卡 | BF16 | 多机或特殊机箱 | 约 28.8 万美元 | 常见服务器单机装不下这么多卡,需多机并行 |
| 9 张 96GB 显卡 | FP8 级 | 多机或高密度机箱 | 约 14.4 万美元 | 同上;需自行重新量化 |
| 5 张 96GB 显卡 | 4 位级 | 单台多卡工作站或服务器 | 约 8 万美元 | 功耗与散热要求高 |
| 4 张 96GB 显卡 | 3 位级 | 单台多卡工作站 | 约 6.4 万美元 | 质量需自测 |
| Mac Studio 512GB | 3 位级,或勉强 4 位级 | 一台桌面整机 | 约 2.23 万美元 | 统一内存带宽有限,上下文空间紧 |
| 大内存 CPU 服务器(512GB 以上 DDR5) | 3–4 位 GGUF | 一台服务器 | 我们没有核实报价 | 生成速度通常明显慢于显卡 |
成本的计算方式是:按 RTX PRO 6000 单卡约 1.6 万美元,权重体积加 10% 余量,每张卡 96GB 估算,所以 18 张约 28.8 万美元、9 张约 14.4 万美元、5 张约 8 万美元、4 张约 6.4 万美元。显卡单价依据 TechPowerUp 2026 年 8 月 13 日的报道(NVIDIA 官方商城标价 16,000 美元),价格还在变;Mac Studio 价格依据 MacRumors 2026 年 10 月 28 日的报道:M5 Ultra 配 512GB 内存起步价 22,299 美元。这里不含主机、电源、散热和电费,也没有算多机互联,只是量级参考。
读这张表要记住两点。第一,不是放得下就跑得动:我们没有在任何一种硬件上实测这个检查点的速度,所以不给出 token 每秒的数字。第二,MoE 在显存不足时可以把部分层放到系统内存,但速度会下降,这套取舍见我们的 内存与显存、CPU 卸载指南。
按可用内存选择路线
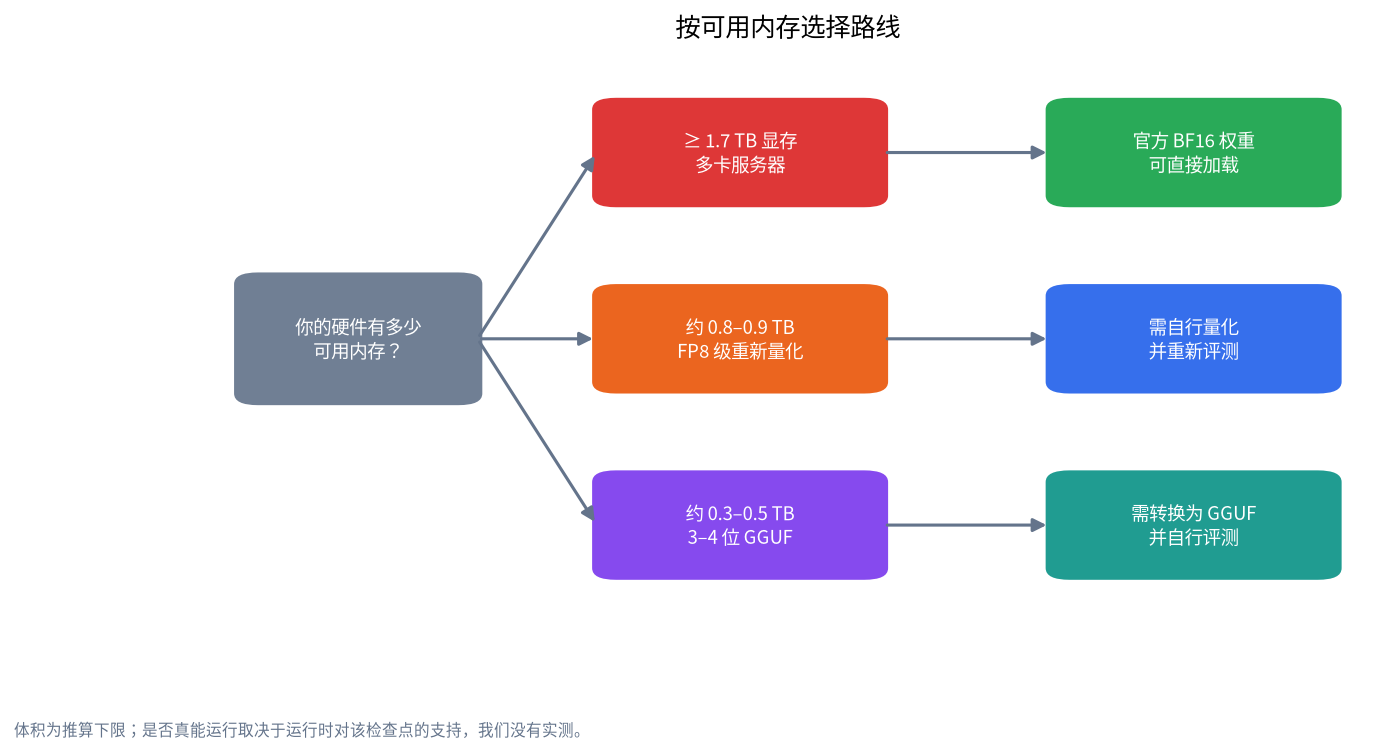
如果你已经知道自己有多少可用内存,可以按下面的梯度选择。
| 你有多少可用内存 | 建议路线 | 需要做的事 |
|---|---|---|
| 1.7 TB 以上显存 | 直接使用官方 BF16 | 多卡张量并行或专家并行,参考推理框架对该架构的支持 |
| 约 0.8–0.9 TB | FP8 级重新量化 | 自行量化并评测 |
| 约 0.3–0.5 TB | 3–4 位 GGUF | 转换为 GGUF、量化,再自行评测 |
| 低于 0.3 TB | 不建议跑这个检查点 | 改用更小的模型,或使用原版的 1–2 位 GGUF |
如果你要的只是 DeepSeek V4.1 Flash 的能力、并不需要无审查改版,那么原版更现实。按 Unsloth 的指南,原版 GGUF 的内存需求(RAM 加 VRAM,Engram 放在 SSD)是:1 位约 128–145 GB、2 位约 176–205 GB、3 位约 256–290 GB、4 位约 305 GB、8 位约 315 GB。这些数字针对原版,不适用于 Obliterated 版。
一条概括性的下载与量化流程
下面是高层次的流程,用于规划,不是逐行教程;具体命令请以各项目当前文档为准。
- 先确认值不值得。 这是一个体积超过 1.5 TB 的无审查改版,只有在研究、红队或受控的内部场景里才有意义。先读风险与合规部分,并决定你的护栏方案。
- 准备磁盘和网络。 1.51 TB 的下载,按 1 Gbps 理论满速也要约 3.4 小时,实际通常更长(推算)。磁盘按至少 3.5 TB 准备。
- 只从官方模型库下载。 仓库为 OBLITERATUS/DeepSeek-V4.1-Flash-1017-obliterated,共 83 个 safetensors 分片,另有配置、聊天模板和评测元数据。下载后核对文件数量和大小;不要使用来源不明的镜像或“整合包”。
- 选择运行时。 配置文件由 Transformers 5.18.0.dev0 写出,意味着需要匹配的新版本;vLLM、SGLang 等是否支持,我们没有核实。llama.cpp 的 deepseek41 架构已在 2026-10-25 合并进主线(PR #31086),但 Unsloth 的指南仍指向一个单独的 PR 分支,请使用带有 deepseek41 支持的较新版本。
- 转换并量化。 BF16 检查点要先转换为 GGUF 再量化。这个检查点的 model_type 是 deepseek_v41_text,我们没有验证转换器是否能直接处理它;如果失败,不要强行改配置,先去项目 issue 里查。
- 重新评测。 模型卡里的拒答、危害和 MMLU 结果只对 BF16 权重成立。量化会再次改变权重,Unsloth 对原版的测试也显示低位量化会降低评测分数(例如它的 IQ1_S 六项平均 83.53,对比 Q8 的 87.68),所以要用自己的提示集重新检查质量和拒答行为。
- 设置采样参数。 Obliterated 版的模型卡没有写使用说明。常见的做法是沿用原版的推荐:temperature 为 1.0、top_p 为 1.0,这个数字来自 Unsloth 指南和原版文档,不是这个改版自己的建议。
- 加护栏并隔离。 在运行环境里加入输入输出过滤,限制网络和工具权限。
另外,聊天模板的说法需要纠正:流传的说法把 deepseek_v41_text 当成聊天模板名,实际上它是配置里的 model_type;这个仓库自带 chat_template.jinja。
风险、合规与护栏
这一节与评测解读里的结论一致,这里只做提醒。无拒答的模型更容易输出有害内容,不应直接接入公开服务、联网浏览或自动执行工具的智能体。以下为一般性信息,不构成法律意见:在中国大陆向公众提供生成式人工智能服务,要遵守《生成式人工智能服务管理暂行办法》等规定;在欧盟要关注《人工智能法案》对通用目的模型的义务。我们认为可站得住脚的用途包括红队与安全研究、小说创作中减少过度拒答、研究拒答机制本身;原理可以读我们的拒绝方向消融详解。生产环境请加入 Llama Guard 一类的安全分类器,并保留日志。
参考配置与方案
如果你想了解具体机器怎么选,可以从这些页面开始:显存对照表可以快速核对不同模型的内存需求,硬件页汇总了不同预算的配置,方案页介绍整机与企业私有化方案,需要深圳自研整机或远程协助时,可通过方案咨询页联系我们。相关的配置文章有:RTX PRO 6000 工作站、大内存迷你主机、Mac 本地运行大模型、双显卡组装和企业私有化部署,量化的基础见 Q4_K_M 量化解读。这些页面都不针对这个检查点的实测,只作为选型参考。
常见问题
DeepSeek V4.1 Flash Obliterated 本地运行至少需要多少内存?
官方 BF16 权重约 1.51 TB,要全部放进 GPU 需要约 1.7 TB 以上显存。若自行量化到 3 至 4 位,权重推算约 283 至 424 GB,再加上下文和运行开销。
一台 512GB 的 Mac Studio 能跑吗?
按推算,3 位级权重约 283 GB 放得下,4 位级约 377 GB 也许勉强,但要给系统和上下文留空间。我们没有实测,也没有找到该检查点的官方 GGUF,所以不能保证。
为什么不直接用原版的 GGUF 内存数据?
那些数据针对原版 DeepSeek-V4.1-Flash-1017,体积约 510 GB 的原生精度。Obliterated 版是 754.6B 的 BF16,两者不同,不能直接套用。
量化后拒答率和能力还和模型卡一样吗?
不一定。模型卡的结果只对 BF16 权重成立,量化会再次改变权重,需要用自己的提示集重新评测。
能用 Transformers 直接加载吗?
模型库的 library_name 标为 transformers,配置由 Transformers 5.18.0.dev0 写出,但我们没有加载过它,是否需要特定版本或额外设置请以模型卡和官方文档为准。
建议用在生产环境吗?
不建议直接对公众开放。若用于内部研究,请加入输入输出护栏、日志和访问控制,并先咨询合规人员。
和我们聊聊
想评估自己的预算和机器能跑到哪一档?欢迎加入社区交流,或发邮件到 admin@microaione.com。
参考资料:Obliterated 模型卡、Unsloth:DeepSeek-V4.1-Flash 本地运行指南、llama.cpp PR #31086、MacRumors:Mac Studio M5 Ultra 512GB 报价、TechPowerUp:RTX PRO 6000 报价。数据读取日期 2026-11-01。