Strata vs Ollama:llama.cpp、LM Studio、vLLMとの違いと選び方
更新日 2026-11-04。 公開されているドキュメント、リリースノート、第三者の報告に基づきます。ベンチマークは私たち自身では取っていません。
Strata vs Ollamaは今月いちばん聞かれている比較ですが、同じ仕事をする二つのツールの公平な勝負ではありません。Strataは、小さなグラフィックボードのPCで、ある種類の非常に大きなMoE(混合エキスパート)モデルを動かすために作られた新しいエンジンです。Ollamaは成熟した汎用のモデル管理ツールです。llama.cpp、LM Studio、vLLMは、同じ地図の別の場所にいます。この記事では5つのツールを並べ、それぞれの用途を示し、Qwen3.8-Flash-Nextへの対応について私たちが確認できたことをまとめ、最後に選び方のガイドを付けます。「Strata」という言葉しか知らない方は、先にStrataとは何かの解説をどうぞ。
Strata vs Ollama:結論から
- Strata: 12〜24 GBのGPUと48〜64 GBのRAMを積んだPCで、非常に大きなMoEモデル、主にQwen3.8-Flash-Nextを動かしたいときに選びます。
- Ollama: 多くの小〜中規模モデルを手軽に動かし、アプリにつなぎたいときに選びます。
- llama.cpp: GGUFモデルとハードウェアを細かく制御したいとき、または使っているツールがそれを土台にしているときに選びます。
- LM Studio: モデルの検索、ダウンロード、チャットを画面で行いたいときに選びます。
- vLLM: モデル全体が入る十分なメモリのGPUで、多くのユーザーに同時に提供したいときに選びます。
並べて比較
| Strata | Ollama | llama.cpp | LM Studio | vLLM | |
|---|---|---|---|---|---|
| 主な役割 | GPU、RAM、SSDを層に分けて、巨大なMoEモデルを小さなVRAMで動かす | 1つのコマンドで多くのモデルを取得、実行、提供する | 多くのツールの土台になる推論ライブラリとサーバー | 閲覧、ダウンロード、チャットのためのデスクトップアプリ | 高スループットの提供エンジン |
| ライセンス | MIT(エンジン) | MIT | MIT | 独自アプリ。規約上、家庭と仕事で無料 | Apache-2.0 |
| GitHubスター数(2026-11-04) | 39,548 | 185,856 | 133,318 | オープンなリポジトリではない | 96,277 |
| インターフェース | デスクトップアプリとターミナル | コマンドライン、アプリ、REST API | コマンドラインとllama-server |
GUIアプリ、lms CLI、ヘッドレスモード |
Pythonライブラリとサーバー |
| API | OpenAI、Anthropic、Responses形式 | 独自APIとOpenAI互換のエンドポイント | OpenAI互換サーバー | OpenAI互換サーバー | OpenAI互換サーバー |
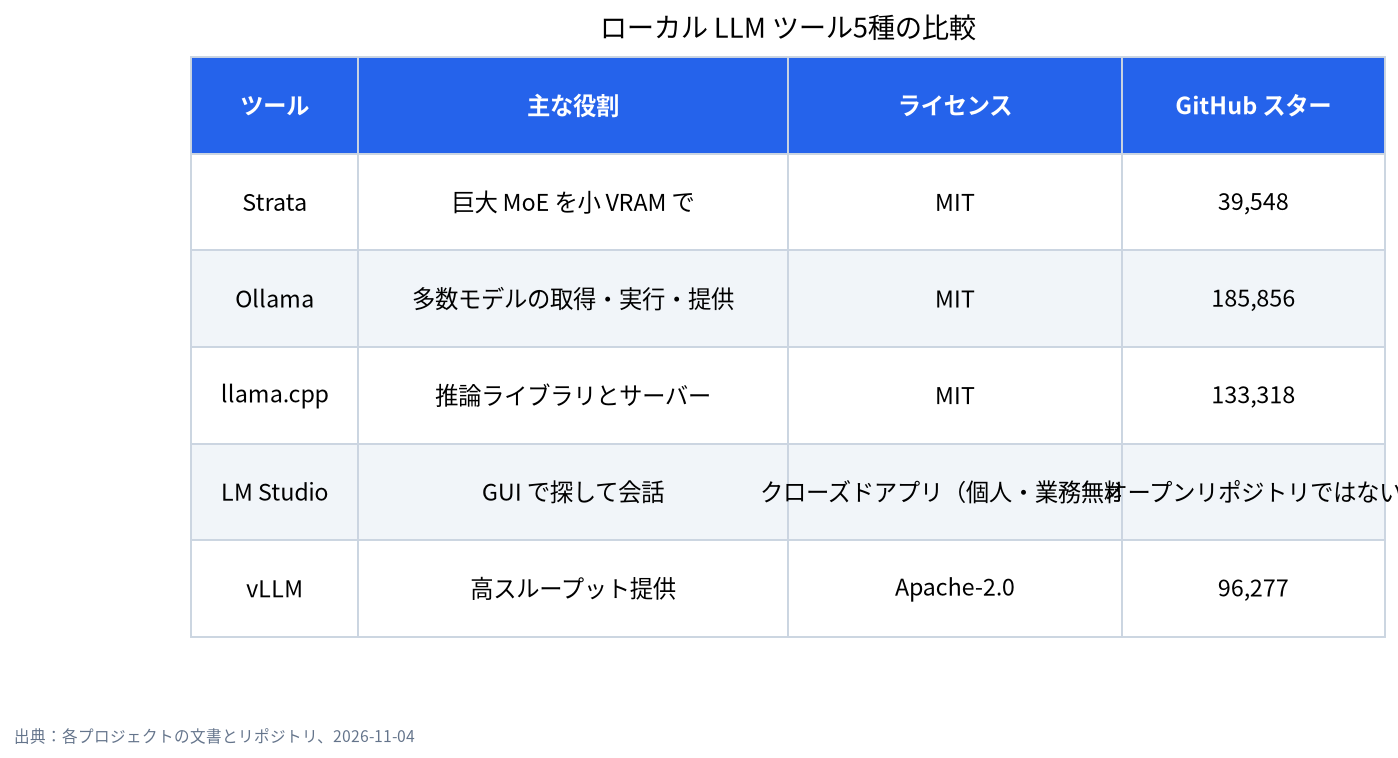
スター数が測るのは注目度で、品質ではありません。Strataのリポジトリはまだ6週間、Ollamaには何年もかけて集めた時間があります。勢いを見るなら、リリースの記録のほうが参考になります。Strataは10月25日から11月2日までに6回リリースし、Ollamaのv0.40.14は11月3日に出ました。
それぞれの得意分野と注意点
| ツール | 得意なこと | 注意すること |
|---|---|---|
| Strata | 12〜24 GBのカードでの非常に大きなMoEモデル、ワンクリックのインストール、コーディングエージェント向けのstrata connect |
対応モデルが少ない、若いプロジェクト、12 GBカードでは長いプロンプトが遅い(PC Watch)、文書によれば外部のセキュリティ監査なし |
| Ollama | 手軽さ、大きなモデルライブラリ、巨大なエコシステム、コーディングツール向けのollama launch、v0.40.0からApple SiliconでMLX |
RAMとSSDから125B MoEをストリーミングする用途は想定外。ローカル利用のほかに任意のクラウドモデルと有料プランがある |
| llama.cpp | 幅広いハードウェア対応、量子化形式、細かい制御。プルリクエスト#27742(2026-08-27マージ)でQwen3.8-Flash-Nextに対応 | 覚えるフラグが多く、環境は自分で組み立てる |
| LM Studio | 親しみやすいGUI、llama.cppとMLXのエンジン、lmsでヘッドレス実行も可 |
クローズドソースのアプリ。製品に組み込むなら規約に従う必要がある |
| vLLM | 多数の並列リクエストでのスループット | モデル全体がGPUメモリに入る前提で、12 GBカード向けではない |
vLLM自身のリポジトリはgithub.com/vllm-project/vllmです。最もよく使われる3つをもっと詳しく見るならOllama・LM Studio・llama.cpp比較ガイドを、vLLMについてはvLLMとSGLangの入門をご覧ください。
Qwen3.8-Flash-Nextへの対応:確認できた範囲
Strataをめぐる盛り上がりの多くはこのモデルに由来するので、正確に書いておきます。以下はすべて2026-11-04時点の状態です。
- Strata: このモデルのために作られています(モデル一覧)。ドキュメントには4種類の量子化があり、RAMとVRAMの合計で37.6〜54.8 GBです。
- llama.cpp: プルリクエスト#27742「model: add Qwen3.8-Flash-Next (qwen4exp)」が2026-08-27にマージされました。Hacker Newsのあるユーザーは、あるAMD環境でllama.cppが約21トークン/秒、Strataが約60トークン/秒だったと報告しています。これは一例であって、私たちが保証できるテストではありません。
- Ollama:
qwen3.8-flash-nextのライブラリのページには、タグが125b-mlx(105 GB、Apple Silicon向け)の一つだけありました。機能要望のissueは2026-10-17にクローズされています。NVIDIA GPU向けのタグは見つからず、テストもしていないので、Ollamaで動かないとは言いません。ドキュメントに載った手順を見つけられなかった、というだけです。 - LM StudioとvLLM: 確認していません。
VRAMより大きなモデルをどう扱うか
ツールの違いが最もはっきり出るのはここです。モデルがカードに収まらないとき、Ollamaとllama.cppは通常、層ごとに分割します。一部の層をGPUで、残りをCPUで動かし、重みはRAMに置きます。これは密なモデルにはよく効き、小さなカードでの標準的なやり方です。MoEモデルは事情が違い、1トークンで使うエキスパートはわずかです。llama.cppにはエキスパートをCPU側に置くオプション(--cpu-moe系のフラグ)があり、Hacker Newsのあるユーザーは、192 GBのRAMを積んだマシンでこの方法を使い、Q8_0のファイルで16トークン/秒だったと報告しています。Strataはさらに一歩進めて、よく使われるエキスパートのキャッシュをGPUに置き、残りはRAM上にあるままCPUで計算し、それでも足りない分はSSDからストリーミングできます。その結果、一つのことをよくこなすツールになりましたが、対応モデルは少数です。一方vLLMはモデル全体がGPUメモリにある前提なので、12 GBのデスクトップ向けカードではなくサーバー向けです。
速度の主張の読み方
「Strataのほうが速い」という投稿の多くは、異なるモデルを比べています。RTX 3060のテストを書いた日本のブロガーは、125Bモデルでの44.49トークン/秒を、同じPCでのOllamaの9Bと26Bモデルの結果の隣に並べたうえで、この表はStrataがOllamaより速いか遅いかを示すものではないとはっきり書いています。arm1.ruのテストは、Flash-Nextを動かすStrataと、別のモデルQwen3.8-27Bを動かすllama.cppの比較でした。公平な比較には、同じモデル、量子化、コンテキスト、ハードウェア、ソフトウェアのバージョンが必要で、その基準を完全に満たすものは見つかりませんでした。それが現れるまでは、速度を「どちらのツールが速いか」ではなく「このツールがこのモデルで出した値」として読んでください。出典はnote.comのテスト、arm1.ru、Hacker Newsのスレッドです。
選び方のガイド
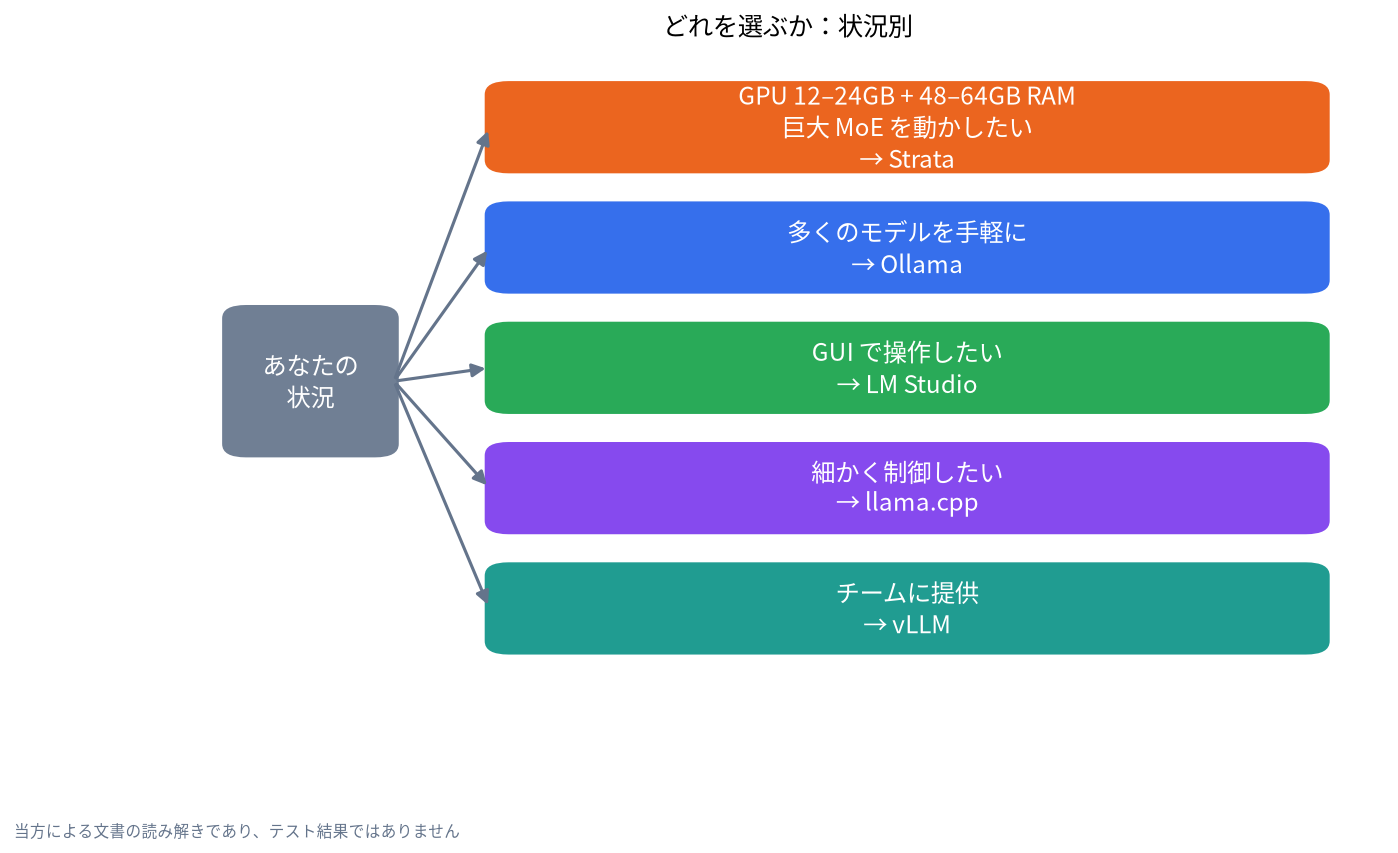
| あなたの状況 | まず使うもの | 理由 |
|---|---|---|
| 12〜24 GBのNVIDIAまたはAMDのGPU、RAM 48〜64 GBで、Qwen3.8-Flash-Nextを動かしたい | Strata | そのモデルとそのメモリ配置のために作られている |
| 多くのモデルをさっと試したい、Open WebUIにつなぎたい | Ollama | 導入が最も簡単でエコシステムが最大。Ollamaインストールガイドを参照 |
| 入力よりクリックが好き | LM Studio | GUIのモデルブラウザ。LM Studioチュートリアルを参照 |
| フラグ、量子化、ビルドを細かく制御したい | llama.cpp | 最もハードウェアに近い |
| 1台のGPUサーバーでチームに提供する | vLLM | 同時リクエスト向けに作られている |
| 統合メモリの大きなMacがある | まずOllamaかLM Studio | どちらもApple SiliconでMLXを使う。StrataもmacOS 15以降に対応 |
二つ使うことを妨げるものはありません。日常のモデルにはOllamaを残し、大きなモデルを一つ動かすときだけStrataを足す人が多いでしょう。ただし、どちらも同じVRAMとRAMを使いたがる点は忘れないでください。具体的な手順はOllamaと並べてStrataを動かすインストールガイドに、メモリの数字はハードウェア要件の記事にあります。
よくある組み合わせ
この節は文書をもとにした私たちの整理で、プロジェクトの推奨ではなく、私たち自身のテストも経ていません。
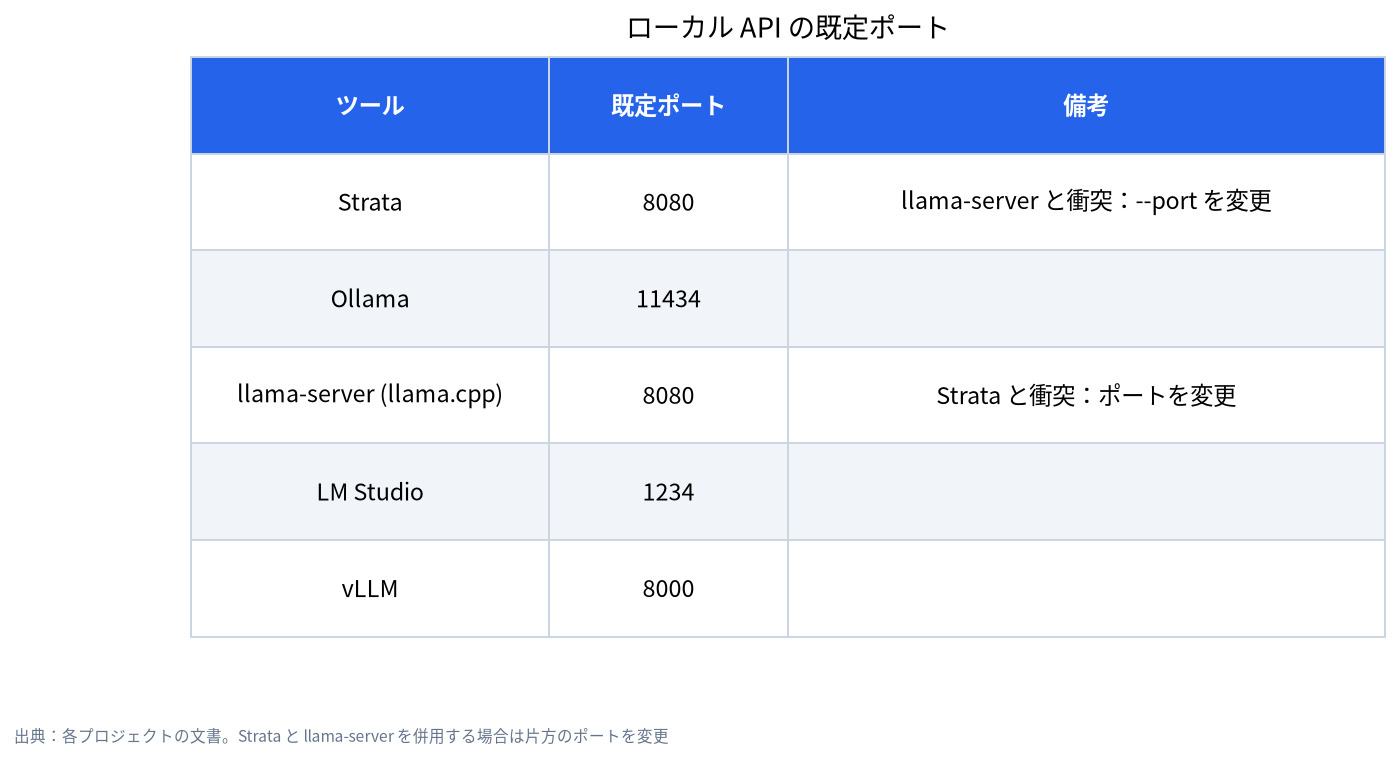
- OllamaとStrata。 日常の小さなモデルとOpen WebUIはOllamaに任せ、Qwen3.8-Flash-Nextが必要なときだけStrataを起動します。ポートは衝突しませんが、Strataを起動する前にOllamaのモデルをアンロードしておく必要があります。
- LM StudioとStrata。 GUIが好きなら、LM Studioで多くのモデルを探して試し、大きなモデルだけStrataで動かします。LM Studioの既定ポートは1234なので、これもStrataとは衝突しません。
- llama.cppとStrata。 同じモデルで比べたい人は、交互に動かすこともできますが、
llama-serverとStrataはどちらも既定で8080を使うので、片方のポートを変える必要があります。また、同じ量子化、コンテキスト、バージョンで比べなければ意味がありません。
RAMが16 GBしかなく、グラフィックボードも12 GBに届かないなら、この件には時間をかけないことをおすすめします。Strataの強みは大きなRAMがあってこそで、もっと小さなモデルにしてOllamaを使い続けるほうが現実的なことが多いからです。
ライセンス、データ、費用
エンジンはオープンソース(MITまたはApache-2.0)ですが、モデルの重みには別のライセンスがあります。Qwen3.8-Flash-NextはQwen Community License 1.0なので、商用利用を考えるなら読んでください。Strataの文書はテレメトリもアカウントもないとしています。Ollamaはリリースノートによれば、ローカルモデルをサインインなしで動かせるほか、任意のクラウドモデルと有料プランも提供しています。LM Studioの規約は家庭と仕事での利用を認めていますが、再配布やサービスとしてのホスティングは認めていません。最新の規約は必ずご自身で確認してください。費用の面では、これらのツール自体は無料で、実際にかかるのはハードウェアです。Strataには大きなRAMと12 GB以上のカードが、vLLMにはモデル全体が入るGPUメモリが必要で、予算の考え方がまったく違います。
私たちがやったこと、やらなかったこと
2026-11-04に、各プロジェクトのリポジトリ、リリースノート、ドキュメント、そして上でリンクした第三者の報告を読みました。この記事のために5つのツールのどれもインストールしておらず、速度も一つも測っていません。一人のユーザーの主張に基づく箇所は、そう明記しました。
よくある質問(FAQ)
StrataはOllamaより速いですか?
答えられません。公開されている比較の多くは異なるモデルを使っているので、この問いには答えていません。テスターの報告では、Strataは12 GBのカードで125B MoEモデルを毎秒数十トークンで動かせますが、それはOllamaで9Bモデルを動かすのとは別の仕事です。
OllamaでQwen3.8-Flash-Nextは動きますか?
2026-11-04時点で、OllamaのライブラリにはApple Silicon向けの105 GBのMLXタグがありました。NVIDIA GPU向けでドキュメントに載っている手順は見つけられず、テストもしていないので、お使いのプラットフォームについてはライブラリのページを確認してください。
初心者にはどれがおすすめですか?
OllamaかLM Studioです。どちらも数分でインストールでき、ガイドも最も多くあります。特定の非常に大きなモデルが欲しくなったら、あとからStrataを足してください。
Strataはllama.cppの上に作られていますか?
ドキュメントはllama.cppの土台であるテンソルライブラリggmlをサードパーティ部品として挙げていますが、Strataは独自のスケジューリングを持つ別のC++エンジンです。llama.cppのフォークとは説明されていません。
チームに提供するならどれがよいですか?
モデル全体を載せられるだけのGPUメモリがあるなら、vLLMです。Strataの既定では並列リクエスト数がカードに合わせて決まる(12 GBのGPUでは1)ので、12 GBのカードはチームではなく一人向けです。
Strataを試すのにOllamaをアンインストールする必要はありますか?
ありません。既定のポートも、モデルのフォルダも別です。ただし、同じGPUに二つの大きなモデルを同時に載せないでください。
ご相談ください
お使いのGPUと予算にどのツールが合うかわからない方は、コミュニティに参加するか、GPU、RAM、用途を添えてadmin@microaione.comまでメールをください。この用途で組み上げてテストしたマシンが欲しい場合は、マシンとソリューションのガイドをご覧ください。