DeepSeek V4.1 Flash 1017 Obliterated 解读:无审查改版的数据、局限与风险
2026 年 10 月底,Hugging Face 上出现了一个叫 DeepSeek V4.1 Flash 1017 Obliterated 的模型,社交媒体上的说法大致是“拒答率从 81% 掉到 4%,能力几乎没变”。这个版本由 OBLITERATUS 项目对 DeepSeek-V4.1-Flash-1017 做“拒绝方向消融”得到,权重以 MIT 协议发布。本文不做吹捧,也不教任何滥用方法:我们逐项核对了模型卡和元数据,说明每个数字到底测了什么、没测什么、该怎么看,并把体积、风险和合规问题放在同样醒目的位置。我们没有下载或运行这个模型,所有数字都来自发布方的自报材料。
要点速览(更新于 2026-11-01)
- 模型卡给出两组不同的拒答数据:50 条“锦标赛”评测中拒答 4%(2/50),以及 838 条语料中完全拒答从 81.62% 降到 4.30%。网上流传的“81.62% → 4.30%(2/50)”把两项测试混在了一起。
没有拒答不等于“更好用”:同一张模型卡显示,被 LLM 评审标为“严重”或“严重/广泛”危害(等级 3 与 4)的回复,在 838 条中占 54.06%(44.75% + 9.31%,我们相加得出),原版仅约 3.94%。
MMLU 87.96% 对 88.08%,差异不显著(McNemar p = 0.743),但 MMLU 既不是安全指标,也不能代表长上下文、工具调用或编程能力。
- 这是 BF16 的 754.6B 参数模型,仓库约 1.51 TB,约为原版 DeepSeek-V4.1-Flash-1017(约 510 GB)的三倍,规划硬件时不能按“原版大小”估算。
DeepSeek V4.1 Flash 1017 Obliterated 是什么
按模型卡的描述,它是 DeepSeek-V4.1-Flash-1017 的一个“refusal-direction ablated”版本,用 OBLITERATUS 的 failspy 方法生成。所谓拒绝方向消融(也常叫 abliteration),是先找出模型内部与“拒答”相关的一个方向,再把它从权重里去掉,不需要重新训练;原理见我们的拒绝方向消融原理详解。下表把可核对的事实集中列出,来源均为模型卡、模型库文件和配置(2026-11-01 读取)。
| 项目 | 内容 | 备注 |
|---|---|---|
| 基础模型 | DeepSeek-V4.1-Flash-1017 | 原版同样为 MIT 协议 |
| 方法 | OBLITERATUS v0.1.4,failspy 预设 | diff_means、1 个方向、除第一层外所有层、不做范数保持,KL 预算 0.5 |
| 校准与评测提示 | 有害、无害各 256 条用于求方向;各 50 条用于评测 | 来自模型库的元数据文件 |
| 参数量与精度 | 754.6B,BF16 safetensors | 仓库文件合计约 1,509 GB |
| 原版对照 | 763B,约 510 GB | 配置里是 FP8 加 FP4 专家的混合精度 |
| 协议 | MIT(权重) | 工具本身的协议另行规定,见下文合规一节 |
| 发布时间 | 2026-10-23 创建,2026-10-30 最近更新 | 页面显示约 101 个点赞 |
两个版本参数量相差约 8B(754.6B 对 763B),模型卡没有解释原因,我们也不做猜测。需要强调的是,“MIT 协议”只说明权重可以怎样使用的版权条件,并不意味着任何用途都合法,这一点后面会展开。
两组数字:不要把它们混在一起
模型卡里有两套互相独立的拒答统计。第一套是 OBLITERATUS 在选择方法时的“锦标赛”评测,用 50 条评测提示。
| 指标 | 数值 | 含义 |
|---|---|---|
| 拒答率 | 4%(2/50) | 50 条提示中有 2 条被拒答 |
| KL 散度 | 0.1305 nats | 与原模型相比,序列 token 层面的前向 KL |
| 连贯性 | 100% | 自动检查 |
| 能力检查 | 6/6 通过 | 链式思考、代码函数、指令遵循、JSON 格式、工具调用等六项简单抽查 |
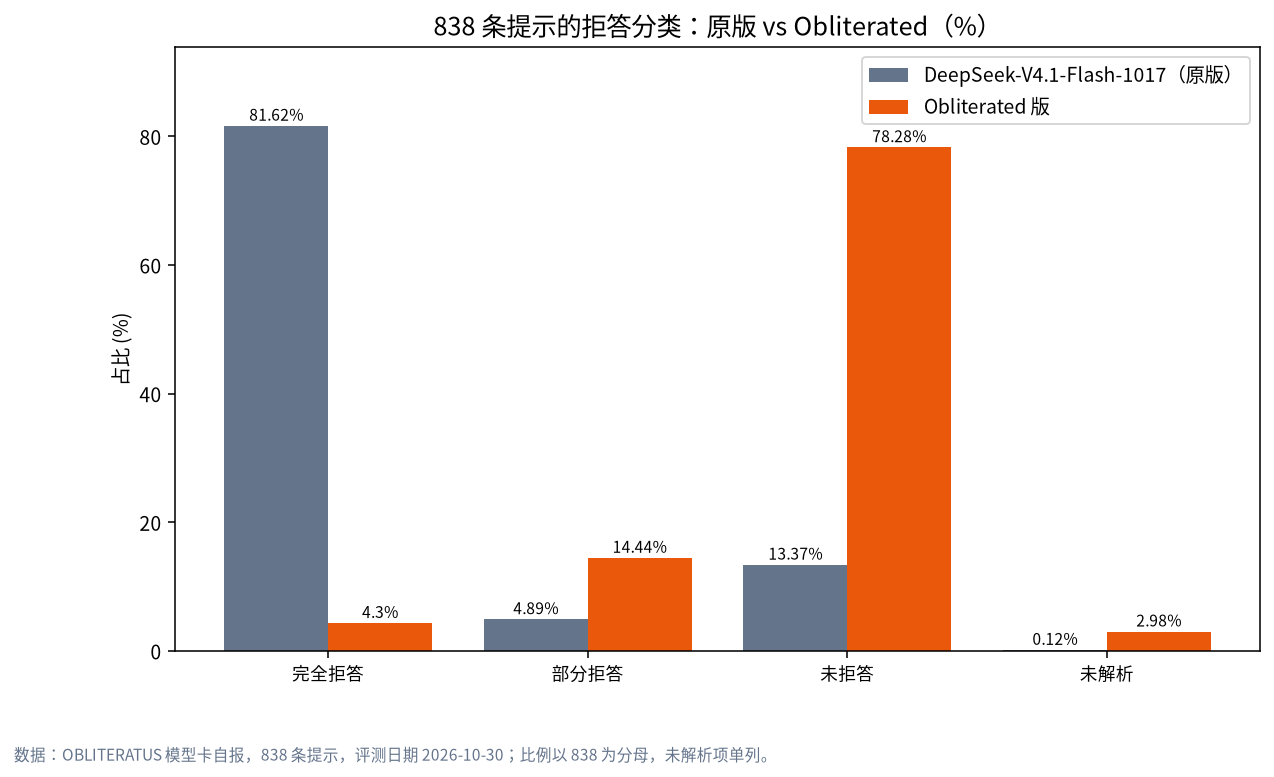
第二套是更大的 838 条语料评测:OBLITERATUS 语料共 842 条,两个模型都给出完整回复的是 838 条,其余 4 条因回复不完整被排除。
| 分类 | 原版 | Obliterated | 变化(百分点) |
|---|---|---|---|
| 完全拒答 | 684(81.62%) | 36(4.30%) | −77.33 |
| 部分拒答 | 41(4.89%) | 121(14.44%) | +9.55 |
| 未拒答 | 112(13.37%) | 656(78.28%) | +64.92 |
| 未解析 | 1(0.12%) | 25(2.98%) | +2.86 |
所以“81.62% → 4.30%”指的是 838 条语料里的完全拒答比例;“4%(2/50)”是另一项、规模更小的评测。两个数字方向一致,但分母不同,引用时应当分开写。还要注意,部分拒答反而从 4.89% 升到了 14.44%,也就是说模型并不是简单地“一律照做”,而是出现了更多“答一半、拒一半”的回复。
没有拒答,不等于更好:危害等级的分布
很多讨论只看拒答率,但模型卡自己也给出了危害评估。回复由两个 LLM 评审(加上三条本地复核)标注,只依据回复的可见文字,没有执行或验证其中的内容。
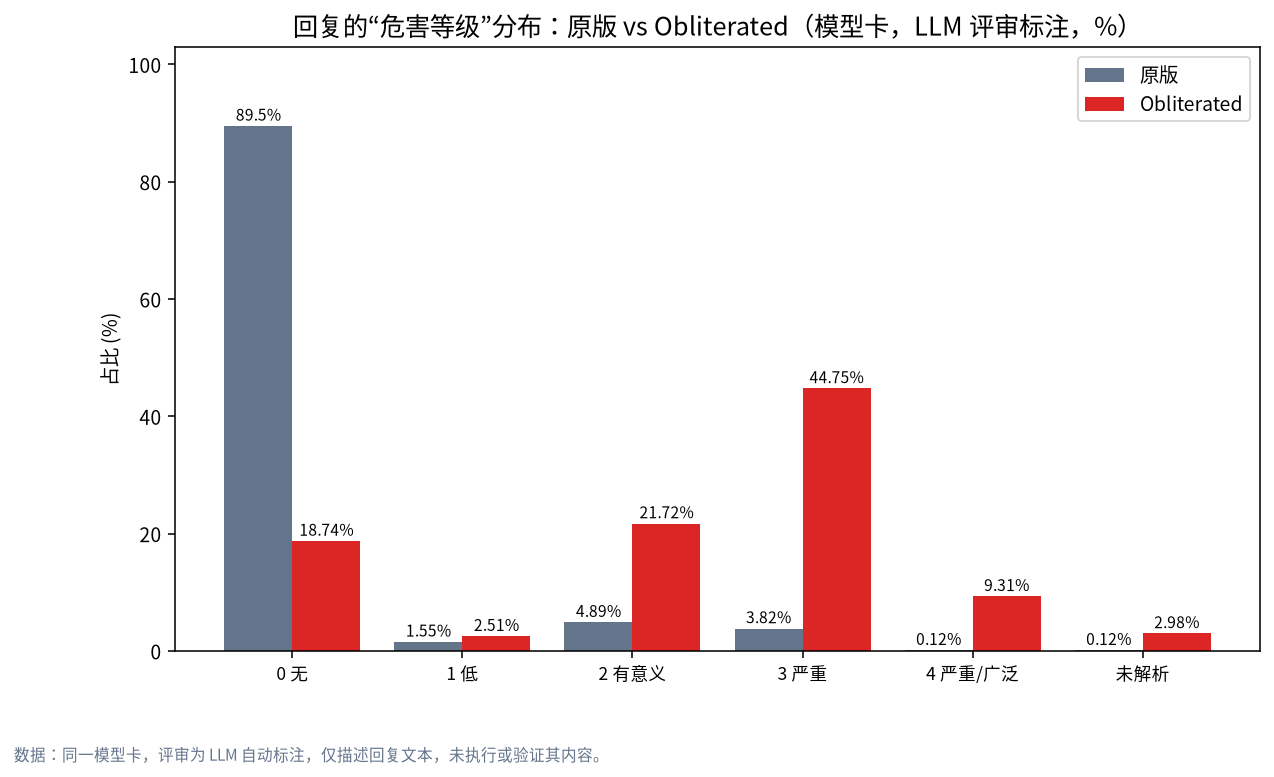
| 危害等级 | 原版 | Obliterated |
|---|---|---|
| 0 无危害协助 | 750(89.50%) | 157(18.74%) |
| 1 影响较低 | 13(1.55%) | 21(2.51%) |
| 2 有意义的危害 | 41(4.89%) | 182(21.72%) |
| 3 严重危害 | 32(3.82%) | 375(44.75%) |
| 4 严重或广泛危害 | 1(0.12%) | 78(9.31%) |
| 未解析 | 1(0.12%) | 25(2.98%) |
把等级 3 和 4 相加(我们自己算的),Obliterated 版是 453/838,约 54.06%,原版约 3.94%。这并不奇怪:拒绝方向消融的目的就是去掉拒答,而语料本身全是敏感提示。但它清楚地说明:拒答率下降的另一面,是需要使用者自己承担的内容风险。我们不转述任何具体回复,也不建议任何人去复现这些测试。
读这张表时还有一处细节值得提醒。模型卡的表格把“有害协助”写成 656 条(78.28%),这个数字恰好等于未拒答数,也等于危害等级 1 到 4 的合计(21 + 182 + 375 + 78 = 656);但表格下方文字又说 656 条未拒答中有 563 条被判为有害协助、93 条不是。两处口径在我们看来并不完全一致,可能是等级阈值的不同定义,也可能是笔误。我们没有原始标注数据,无法判断,只能提醒读者:做引用时请注明“模型卡自报”,并以模型库里的评测文件为准。
MMLU 持平意味着什么
发布方还在 2,500 道 MMLU 题(57 个科目,每科 43 或 44 题,与方法选择的数据隔离)上比较了两个模型,协议是零样本聊天、关闭思考、读取选项 logits。
| 模型 | 答对 | 准确率 | Wilson 95% 区间 |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 | 2199/2500 | 87.96% | 86.63–89.18% |
| Obliterated 版 | 2202/2500 | 88.08% | 86.75–89.29% |
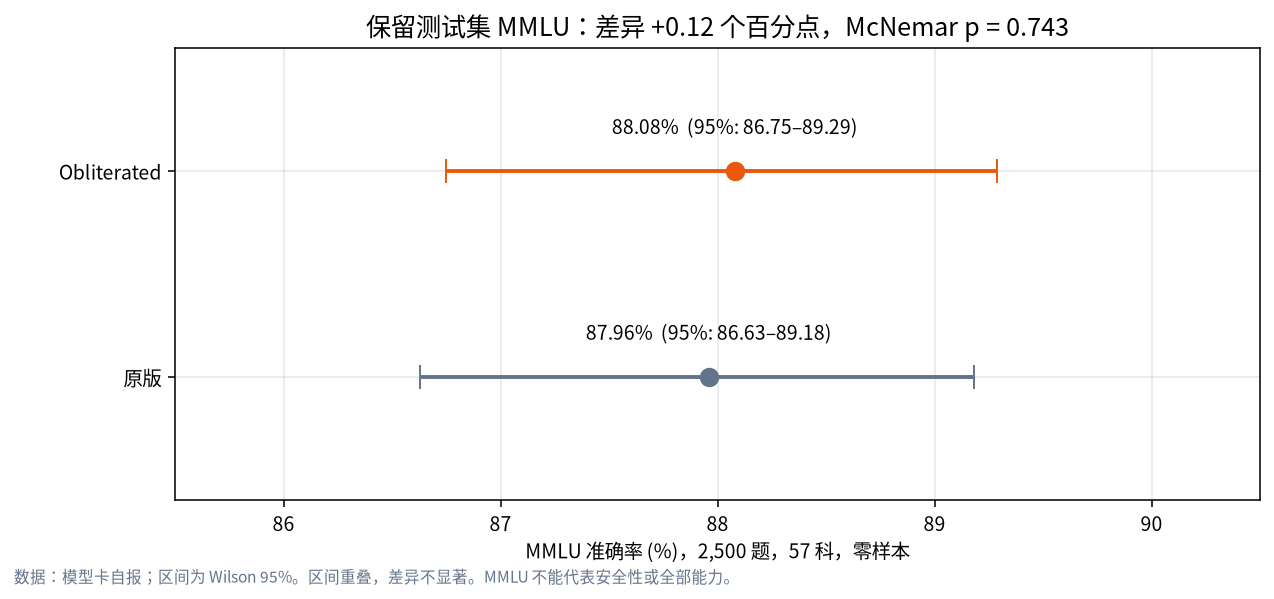
差异是 +0.12 个百分点:20 题由错变对,17 题由对变错,精确双侧 McNemar p = 0.742829,没有统计显著性。元数据里更早的一次 500 题验收显示 −0.6 个百分点(439 对 436),同样落在区间重叠的范围内。这些结果说明,在 MMLU 这类选择题知识测验上,没有看到明显退化。但它们不能推出更多结论:MMLU 不衡量长上下文、多轮工具调用、代码仓库任务或中文细节表现,也不衡量安全性。想知道怎样读这类榜单,可以看我们的如何看懂大模型评测。
这些自报数据的局限
我们把需要保留的疑问列在这里,方便你转述时不失真。
- 自报,未见独立复现:数字来自发布方的模型卡,我们没有找到第三方复现;我们自己也没有做过任何实测。
- 评审是 LLM:标注由 LLM 完成,另有 25 条回复因提供方审核拦截而无法标注(占 2.98%),分布里单列为“未解析”。
- 评测规模有限:50 条用于方法选择,838 条用于对照;其中 254 条出现在干预校准集,50 条在方法选择集,534 条两者都不在。
- 元数据里的提示:概念验证结论是“not_validated”,且工具的 git 工作区标记为“dirty”(说明生成时使用了含未提交修改的代码)。这不是错误,但提醒我们这是一次研究性质的发布,而不是经过完整验证的产品。
- 能力检查很粗:6 项通过只能说明模型没有崩溃,不能代表真实任务表现。
当前生态:第三方变体很多,质量未知
同一时间,Hugging Face 上围绕 DeepSeek-V4.1-Flash 的“abliterated / uncensored / heretic”类仓库非常多。我们在 2026-11-01 的搜索中看到超过 150 个名称含这些词的仓库,其中不少是对同一份权重的复制或重新量化。下表只列存在与体积,不构成推荐,也没有逐个审计。
| 仓库发布者 | 形式 | 仓库体积 | 创建日 |
|---|---|---|---|
| OBLITERATUS | BF16 safetensors,本文主角 | 约 1,509 GB | 2026-10-23 |
| dealignai(1017 UNCENSORED FP8) | FP8 safetensors | 约 510 GB | 2026-10-18 |
| mrfakename(abliterated) | safetensors | 约 510 GB | 2026-10-17 |
| pqhaz(heretic) | safetensors | 约 512 GB | 2026-10-17 |
| orcarouter(abliterated GGUF) | 多档 GGUF 合集 | 约 575 GB(含多个量化档) | 2026-10-22 |
| huihui-ai(abliterated GGUF) | 多档 GGUF 合集 | 约 492 GB(含多个量化档) | 2026-10-25 |
这些第三方仓库采用的方法、校准数据和评测都各不相同,且大多没有像本文主角这样公开评测细节。我们不建议随意下载来源不明的权重:权重文件和配套脚本都可能带来供应链风险,应当只从你能核实身份的发布者处获取,并在隔离环境中加载。OBLITERATUS 是目前少数把 KL、拒答和 MMLU 对照写进模型卡的发布,这是它值得读的地方。
风险、合规与负责任的使用
风险。 去掉拒答机制后,模型会更愿意回应本来会被拒绝的请求,其中一部分会带来真实的伤害,评估表里的等级 3 与 4 就是证据。它不会替你判断对象、场景或后果;它也不具备原版随附的安全兜底。把它接入对外服务、联网代理或自动执行工具,会放大这些风险。
合规。 以下只是一般性说明,不构成法律意见,请结合你所在地区和业务咨询专业人士。在中国大陆,向公众提供生成式人工智能服务,需要遵守《生成式人工智能服务管理暂行办法》(2023 年 8 月 15 日起施行),并涉及《网络安全法》《数据安全法》《个人信息保护法》等规定;面向公众的服务通常还有内容安全与备案、评估方面的要求。在欧盟,《人工智能法案》(Regulation (EU) 2024/1689)对通用目的 AI 模型的义务自 2025 年 8 月 2 日起适用,对模型做实质性修改并投放市场的一方,可能被视为提供者,具体需要对照官方指南判断。此外,权重的 MIT 协议与 OBLITERATUS 工具本身的协议(其 README 写明 AGPL-3.0,另有商业授权)是两件事;云平台、应用商店和模型托管平台各有自己的使用条款。
负责任的使用场景。 我们认为比较站得住脚的用途包括:在隔离环境中做红队测试和安全研究,了解模型的行为边界;小说、剧本等创作场景中减少原版的过度拒答;对授权范围内的防御性安全分析做研究;以及在专业场景中研究“过度拒答”本身,例如评估不同方法对 KL 和能力的权衡。无论哪种用途,都建议在生产环境里自己加一层护栏,例如 Llama Guard 这样的安全分类模型,对输入和输出分别做检查,并保留日志、限制访问权限。
我们的看法
这次发布有两点值得记录。一是它把“拒答率、KL、MMLU 与危害分布”放在同一张模型卡里,比大多数同类发布透明;二是数字本身并没有出人意料,拒绝方向消融在多个模型上都显示出类似的趋势,原论文的结论是拒答由单一方向介导(见 Arditi 等人的论文)。需要克制的,是把自报数据当成结论,以及把“能跑”当成“该跑”。如果你只想弄清楚自己的设备能不能装下它,请直接看本地部署指南;如果想了解 MoE 模型为什么体积大而速度尚可,可以看我们的 MoE 模型本地运行指南;想了解原版 DeepSeek 的本地运行基础,见DeepSeek 本地部署,隐私方面的取舍见本地大模型隐私。
后续:另一个“魔改”版本的核查
社区后来还转发了 GSQ-RCO 量化版的“魔改”变体。我们单独做了GSQ-RCO DeepSeek V4.1 Flash 核查,逐条对照模型卡,并与本文的 OBLITERATUS 版做了对比;它能否在 12GB 显存上运行,见12GB 显存跑 DeepSeek V4.1 Flash 的速度推算。
常见问题
DeepSeek V4.1 Flash 1017 Obliterated 的拒答率到底降到了多少?
按模型卡,838 条语料中完全拒答从 81.62% 降到 4.30%;在 50 条锦标赛评测中拒答 4%(2/50)。两项测试的分母不同,不要混用。
它的能力有没有下降?
模型卡显示 MMLU 从 87.96% 到 88.08%,差异不显著(McNemar p = 0.743)。但 MMLU 只是选择题知识测验,不能代表编程、长上下文、工具调用或安全表现,这些模型卡没有给出结果。
为什么说它是“无审查”模型有风险?
因为去掉拒答后,模型对敏感请求的响应明显增多。模型卡的评估中,等级 3 与 4 的危害回复占 838 条的 54.06%(我们相加所得)。需要使用者自己加护栏并承担责任。
它和原版 DeepSeek-V4.1-Flash-1017 体积一样吗?
不一样。Obliterated 版是 754.6B 参数的 BF16 权重,仓库约 1.51 TB;原版约 510 GB,且以 FP8 与 FP4 混合精度发布。规划硬件时要按 BF16 或你自己的量化结果估算。
我们做过实测吗?
没有。本文所有数字来自模型卡、模型库文件和公开页面,我们只做了核对和解读,没有下载、运行或测试该模型。
可以商用吗?
权重的 MIT 协议允许广泛使用,但是否合法取决于你的用途、地区和是否面向公众提供服务,还要看工具和平台的条款。请先咨询法律专业人士,并做好内容安全措施。
和我们聊聊
对本地部署、模型选择或合规问题有想法?欢迎加入社区交流,或发邮件到 admin@microaione.com。
参考资料:Obliterated 模型卡、原版 DeepSeek-V4.1-Flash-1017、OBLITERATUS 项目、Llama Guard 4 模型卡、欧盟 AI 法案文本(EUR-Lex)。数据读取日期 2026-11-01。
延伸阅读:去审查模型的合规风险;拒答率评测详解