Strataの必要スペック:RAM・VRAM・SSDの目安と構成例
更新日 2026-11-04。 私たちはStrataを自分では動かしていません。以下の要件はすべてプロジェクトの文書か名前を挙げたテスターによるもので、速度もすべてテスターの数値です。
Strataの必要スペックが注目される理由は、「12 GBのグラフィックボードで1,250億パラメータのモデル」が、重みが実際にどこにあるかを知るまでは不可能に聞こえることにあります。正直にまとめると、GPUは全体の費用の中でいちばん小さな部分です。モデルの大半はシステムRAMに、一部はSSDにあり、GPUはいちばんよく使うエキスパートのキャッシュを持ちます。この記事では、文書とテスターの報告を、PCの計画に使える数字に変え、構成の段階を示し、私たちが推測しない部分も明記します。このツールをまだ知らない方は、先にStrataとは何かをお読みください。
Strataの必要スペック:結論
| 部品 | 現実的な下限 | 余裕のある構成 |
|---|---|---|
| GPU | 12 GBのNVIDIA RTX 20〜50シリーズ(古いカードはCUDA 12エンジン)。AMD、Intel Arc、Apple Siliconは別のガイド | 16〜24 GB、または2枚 |
| RAM | 小さい2サイズで約48 GB | すべてのサイズで64 GB。長いコンテキストならさらに多く |
| SSD | 空き約80 GB、NVMeが望ましい | 1 TB。複数のサイズを置いておける |
| CPU | 比較的新しいx86-64。エンジンにはAVX2とAVX-512のコード経路がある | テスターによればAVX-512が効く |
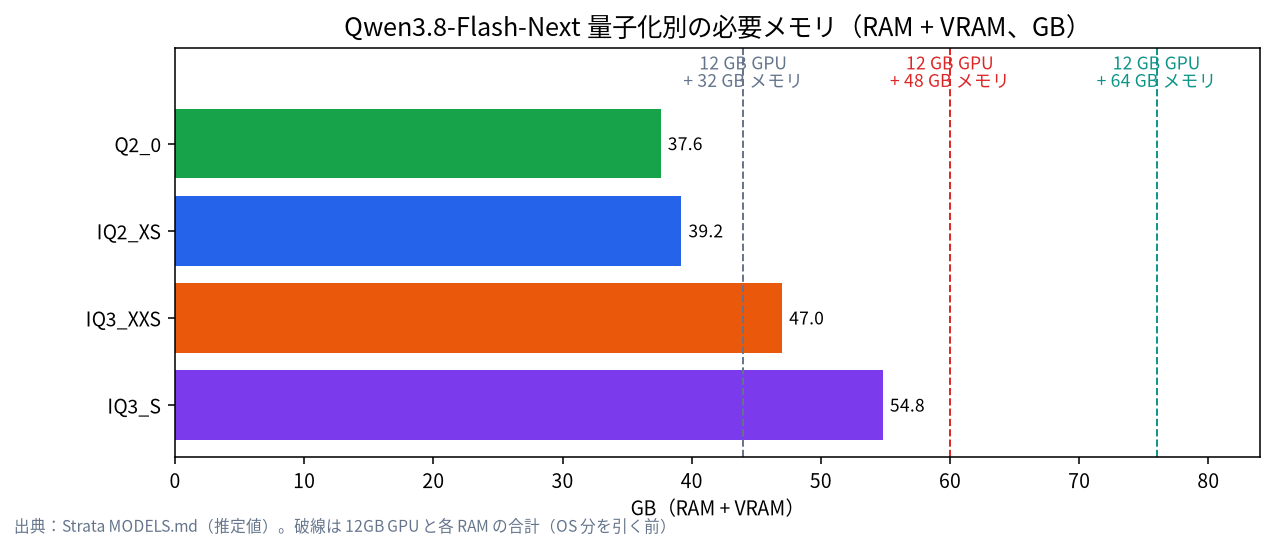
プロジェクトのモデルページは、重みをRAMとVRAMの合計で示しています。Q2_0は37.6 GB、IQ2_XSは39.2、IQ3_XXSは47.0、IQ3_Sは54.8です。OS用の余裕を残すよう書かれており、数値は見積もりだとされています。AkitaOnRailsのレビュアーは、プロジェクトが示す最低条件はRAMとVRAMの合計で32 GBで、これで動くのは最も圧縮されたバージョンだけであり、彼のテストで高得点だったIQ3_Sには約64 GBのRAMが必要だったと書いています。
各部品の役割
GPUとVRAM。 プロジェクトのHOW_IT_WORKS文書によれば、カードにはアテンション層、ルーター、共有エキスパート、KVキャッシュ、そして残りのVRAMを埋めるエキスパートキャッシュが載り、追加の1 GBごとに約700個のエキスパートが置けます。キャッシュが大きいほど、より多くのトークンがGPUで計算されます。PC Watchは、12 GBのカードでIQ2_XSのとき約3,031個のエキスパートとヒット率72%、IQ3_Sでは1,104個と56%だったと測定しています。並列リクエスト数もVRAMに応じて決まり、12 GBで1、20 GBで2、24 GBで3、32 GB以上で4です。
RAM。 24,576個のエキスパートすべてが固定されたメモリに置かれ、GPUにないものはCPUが計算します。RAMの容量がどのサイズを動かせるかを決め、RAMの速度とCPUの命令セットが、ミスしたときの速さを決めます。PC WatchはDDR4の帯域と、検証したCPUにAVX-512がないことを速度が上がらない要因として挙げ、別の日本のテスターもAVX-512のないCPUについて同じことを述べています。
SSD。 28.8 GBのn-gram表がディスクにあり、1トークンで読むのはそのうちの数行です。RAMが足りないときは、任意のモードでエキスパートをディスクからストリーミングしますが、文書によれば動くものの、かなり遅くなります。RAM 30 GBのノートPCで、arm1.ruのレビュアーは、1.3時間のテスト実行でSSDから約6.9 TBが読み込まれたと測りました(平均で約1.4 GB/秒)。
CPU。 見出しになるスペックではありませんが、キャッシュミスのたびに実際に働きます。エンジンには、AVX-512のあるCPUとないCPUのために別々のコード経路があります。
構成の段階とテスターの報告
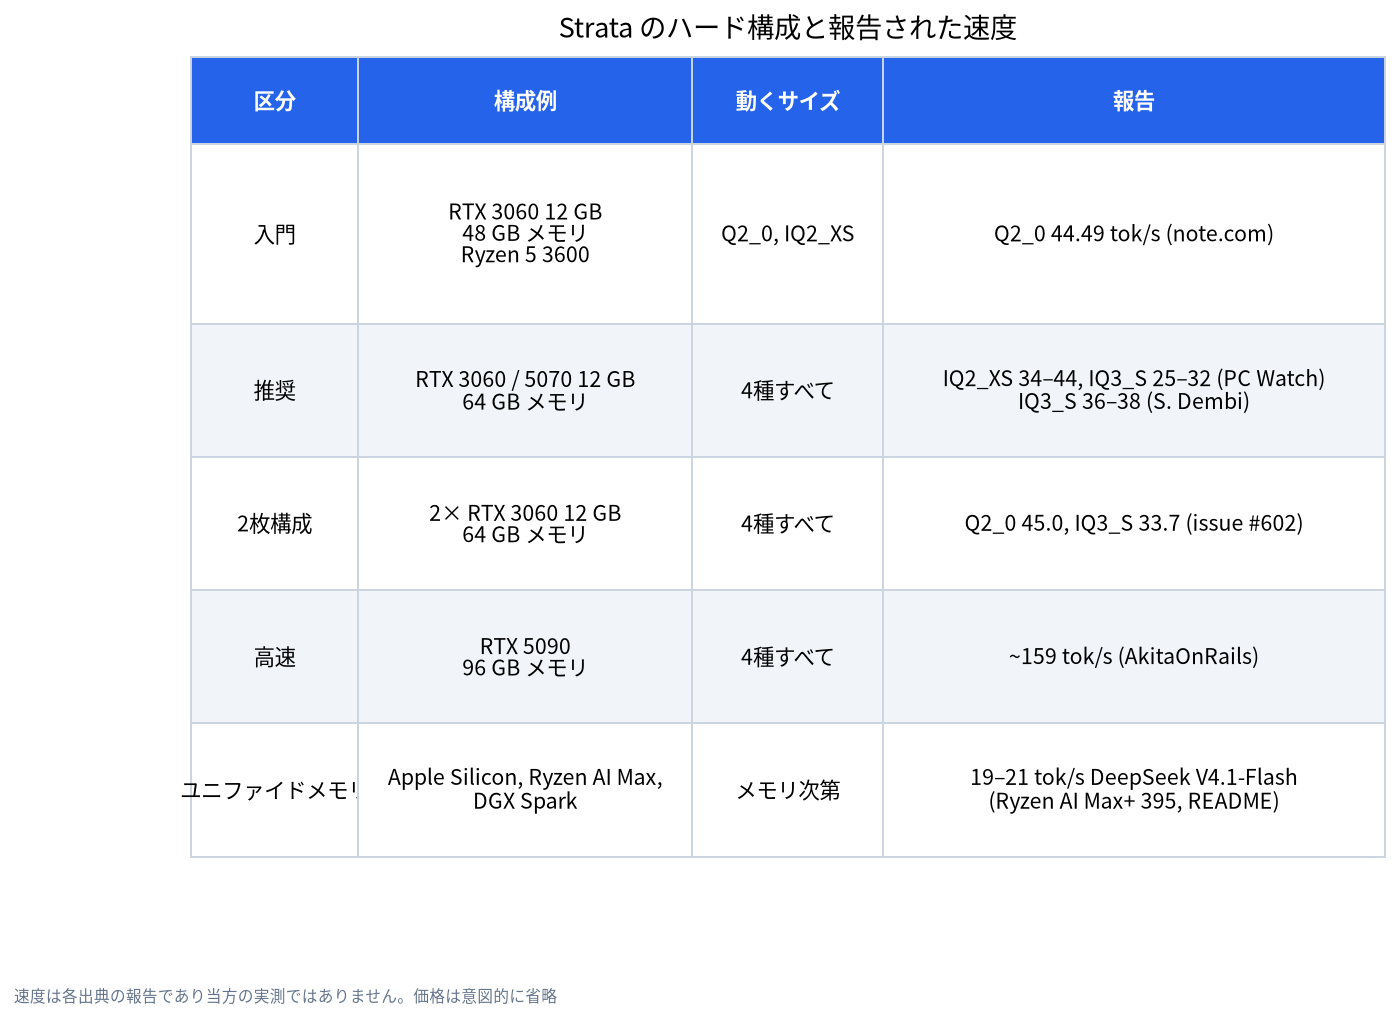
| 段階 | 部品の例 | 収まるサイズ | 出典の報告 |
|---|---|---|---|
| 入門 | RTX 3060 12 GB、RAM 48 GB、Ryzen 5 3600 | Q2_0、IQ2_XS | Q2_0で生成44.49 tok/s、プリフィル326.68 tok/s(note.com) |
| 推奨 | RTX 3060またはRTX 5070 12 GB、RAM 64 GB | 4種類すべて | IQ2_XS 34〜44、IQ3_S 25〜32 tok/s(PC Watch)。RAM約50 GiBでIQ3_S 36〜38 tok/s(Dembi) |
| 2枚 | RTX 3060 12 GB×2、RAM 64 GB | 4種類すべて | Q2_0 45.0、IQ3_S 33.7 tok/s(プロジェクトのissue #602)。複数GPUは層で分割し、NVLinkは不要 |
| 高速 | RTX 5090、RAM 96 GB、強力なCPU | 4種類すべて | 約159 tok/s、作者自身のベンチマークで91点(AkitaOnRails) |
| 統合メモリ | Apple Silicon(macOS 15以降)、Ryzen AI Max、DGX Spark | メモリ容量しだい | プロジェクト自身のREADMEは、Ryzen AI Max+ 395(128 GB)でのDeepSeek V4.1-Flashのコード生成を19〜21 tok/sと報告 |
この表に価格は意図的に載せていません。GPUとメモリの価格は週ごとに変わり、上の出典にも私たちが確認できる日付つきの価格はありませんでした。出発点には、日付つきの価格を載せた私たちのガイドのほうが向いています。入門構成、24GB GPU構成、中古GPUの買い方、LLM向けの安いGPUです。
ディスクとSSDの計画
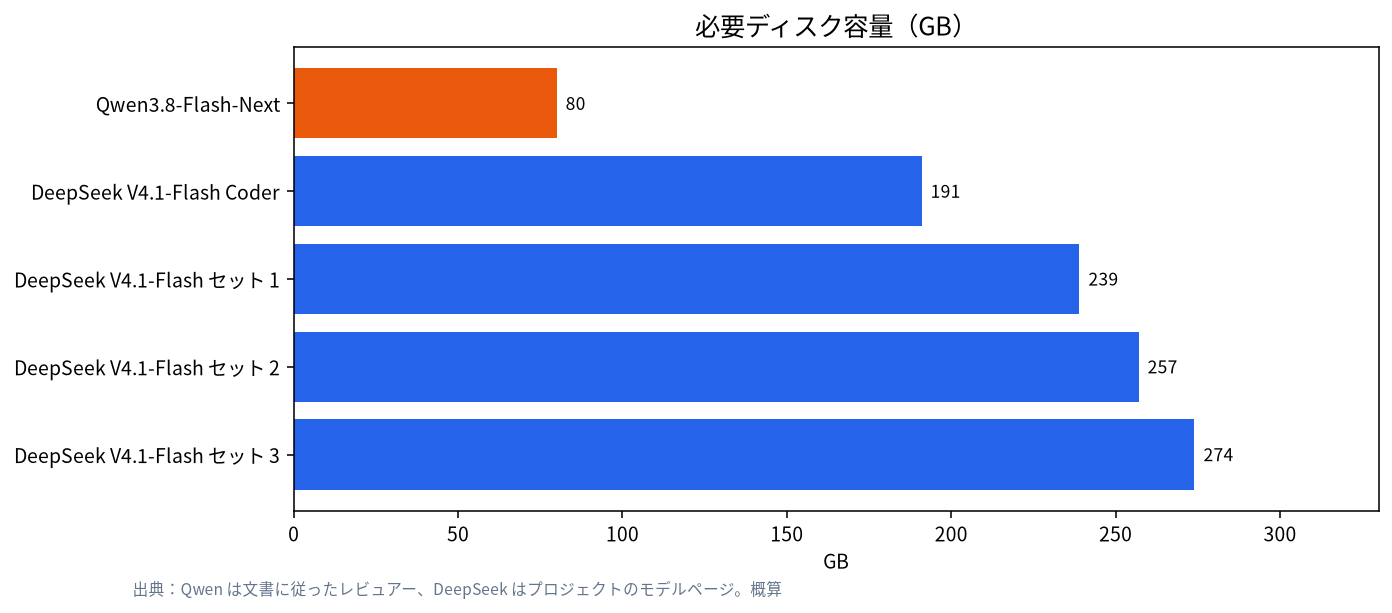
Qwen3.8-Flash-Nextには、約80 GBの空きを見込んでください。主な理由は、ダウンロードに量子化されたエキスパート、補助ファイル、n-gram表が含まれるからです。DeepSeek V4.1-Flashはセットにより191〜274 GBが必要で、そのケースは12GB VRAMでのDeepSeek V4.1 Flashの記事で扱いました。読み込みでSSDが摩耗することはありませんが、ディスクが忙しいと他のすべてが遅くなるので、可能なら、システムディスクではないNVMeにStrataのフォルダーを置いてください。
ノートPC、WSL2、統合メモリ
ノートPCは厄介なケースです。arm1.ruのレビュアーは、RTX 5080ノートPC用GPUとRAM 30 GBで125Bモデルを動かし、動くには動いたものの、メモリが逼迫していたと報告しています。Strataは約21 GBのRAMと4〜5 GBのスワップを使いました。RAM 32 GBは、計画というより無理をしている状態だと私たちは考えます。WindowsのWSL2でも動作し、コミュニティの索引にはRTX 5060 Tiの例がありますが、文書によれば、Windowsのグラフィックスドライバーでは、複数GPUの実行時に固定されるエキスパートメモリは一部だけです。Strix Haloのような統合メモリのマシンでは、グラフィックメモリとRAMが同じプールなので、上の表で別々だったVRAMとRAMの数字は、128 GBという一つの数字に置き換わります。
プロジェクトのベンチマーク索引にあるその他の結果
リポジトリには、ユーザーが投稿した実行結果のコミュニティベンチマーク索引があります。これらは自己申告で、バージョン(v0.1.40〜v0.1.43)もプロンプトの長さも異なり、私たちはどれも再現していません。順位ではなく、おおよその範囲の感触として見てください。
| ハードウェア(投稿のまま) | サイズ | 生成、tok/s |
|---|---|---|
| RX 9070 16 GB、Ryzen 7 5800X3D、RAM 64 GB | IQ3_XXS | 57.9〜58.7 |
| RTX 5060 Ti 16 GB(WSL2)、Ryzen 7 3700X、RAM 128 GB | IQ3_S | 47.7〜48.2 |
| Tesla P40 24 GB×2、Xeon E5-2699 v3、RAM 125 GB | IQ3_S | 35.0 |
| Tesla V100 32 GB、Threadripper 2990WX、RAM 96 GB | UD-IQ4_XS | 約28〜33 |
| Strix Haloのノート、統合メモリ128 GB、70 W | UD-IQ4_XS | 42〜59(プロンプトの長さによる) |
目を引く点が二つあります。索引の16 GBのカードは、近いサイズで、上の12 GBの数字より高い速度を報告していて、エキスパートキャッシュの設計と合いますが、CPUとバージョンは異なります。また、古い24 GBのワークステーション用カードでも、RAMが大きければ実用的な速度で動きます。どちらも下のアップグレード順と一致しますが、一件ずつの投稿なので、保証として読まないでください。
自分のマシンを見積もる
VRAMとRAMを足して、そこからモデルのサイズを引くと、残りがOS、ブラウザ、KVキャッシュ、その他のための余裕になります。以下はプロジェクトの数字を使った単純な計算で、測定ではありません。
| 構成(VRAM+RAM) | 合計 | IQ2_XS(39.2 GB)の余裕 | IQ3_S(54.8 GB)の余裕 |
|---|---|---|---|
| 12 GB+32 GB | 44 GB | 約4.8 GB、かなりきつい | 収まらない |
| 12 GB+48 GB | 60 GB | 約20.8 GB | 約5.2 GB、かなりきつい |
| 12 GB+64 GB | 76 GB | 約36.8 GB | 約21.2 GB |
余裕が小さいほど、arm1.ruのノートPCのようにスワップしやすくなり、速度が落ちます。「ぎりぎり足りる」マシンで最大のサイズを狙わず、一つ小さいサイズにして、長いコンテキストと日常の利用のための余裕を残すことをおすすめします。同じ計算は、どのメモリを買うかにも使えます。先に動かしたいサイズを決めて逆算し、買ってから足りるか祈るのは避けましょう。メモリの価格は確認していないので、予算の提案はここではしません。購入当日の価格で判断し、保証のある店を優先してください。
アップグレードの順番:私たちの文書の読み方
これはプロジェクトが設計をどう説明しているかからの私たちの推論で、測定した順位ではありません。
- RAMを64 GBに。 エキスパートはすべてそこにあるので、どのサイズが動かせるかを決めます。多くの場合、最も費用対効果の高い一歩です。
- VRAMを増やす。 1 GBごとに約700個のエキスパートがキャッシュされ、ヒット率が上がればCPUの計算が減ります。
- AVX-512のCPUと速いメモリ。 二人のテスターによれば、ミスしたときの処理に効きます。
- NVMeストレージ。 ディスクからエキスパートをストリーミングせざるを得ないときに、最も効きます。
この背景にあるメモリのトレードオフは、RAMとVRAM、CPUオフロードのガイドとGPUのVRAMガイドをご覧ください。
カスタム構成が向いているとき
部品選びが難しい部分です。12 GBか24 GBのカードに合わせ、RAMスロットの数、NVMeドライブ、電源、冷却を揃える必要があります。自分でやりたくない場合は、深圳にある私たちのチームがローカルLLM用のマシンを組み立ててテストしており、マシンとソリューションのガイドでその仕組みを説明しています。動かしたいモデル、予算、騒音の条件を教えていただければ、日付つきの価格で部品表を提案します。私たちはどのマシンでもStrataのベンチマークをしていないので、上の数字を当てにせず、検討中の具体的な構成でテストするよう依頼してください。電源と発熱は電源と冷却のガイドで扱っています。
私たちがやったこと、やらなかったこと
2026-11-04に、プロジェクトのMODELS、HOW_IT_WORKS、複数GPUの文書と、上でリンクしたテスターの報告を読みました。マシンは組んでおらず、ベンチマークも取っておらず、価格も示していません。数字が一人の人によるものである場合は、その名前を挙げました。
よくある質問(FAQ)
8 GBのGPUでStrataを動かせますか?
公式の経路は12 GB以上を推奨しています。プロジェクトのコミュニティ索引には、Quadro RTX 4000 8 GBを2枚、RAM 96 GBで、非常に長いプロンプトでIQ2_XSを動かして生成18〜23トークン/秒という例がありますが、それは2枚のカードと大量のRAMの話で、私たちは確認していません。
RAM 32 GBで足りますか?
きついです。重みだけでRAMとVRAMの合計37.6〜54.8 GBが必要なので、12 GBのVRAMと32 GBのRAMでは、OSの分を引く前の紙の上でも、最小のサイズがかろうじて収まる程度です。プロジェクトのコーディング向けのバージョンは約32 GBのRAMと記載されています。標準のサイズでは、48 GBが現実的な下限で、64 GBなら余裕があります。
RAMの速度は重要ですか?
重要です。GPUにないエキスパートをCPUが計算するからです。テスターはDDR4の帯域とAVX-512がないことを要因に挙げていますが、対照実験はありません。
NVMeのSSDは必要ですか?
標準の経路で主に必要なのは容量で、約80 GBです。RAMが足りなくてStrataがディスクからエキスパートをストリーミングする場合は、NVMeがずっと重要になります。
AMD、Intel、Macでも使えますか?
プロジェクトは、対応するAMD Radeonカード、LinuxのIntel Arc、macOS 15以降のApple Silicon、Ryzen AI Max、DGX Sparkを挙げ、それぞれに別のガイドがあります。お使いのカードについては、インストールガイドを確認してください。
小さなGPUを2枚のほうが、大きな1枚より良いですか?
あるテスターはRTX 3060を2枚でQ2_0が毎秒45.0トークンと測り、他のテスターの単体カードの数字も40台なので、このサイズでは利点がはっきりしません。大きなサイズならもっと効くかもしれませんが、対照実験は見つかりませんでした。
ご相談ください
GPU、RAM、予算を軸にPCを組む計画ですか? コミュニティに参加するか、admin@microaione.comまで今ある構成を添えてメールをください。