大模型越狱简史:从 2022 年的提示注入到 2025 年的宪法分类器,攻防如何一步步演变
读一遍大模型越狱简史,最大的收获不是记住几个攻击名字,而是看清一个规律:每当模型多了一项能力,攻击面就多一块;每当攻击被公开,防御就往“分层”再走一步。从 2022 年人们发现提示词可以被覆盖,到 2025 年厂商用分类器把已知的通用攻击大幅挡住,只用了大约三年。这篇文章按时间线梳理关键节点,每个节点只讲它说明了什么、改变了什么,不贴任何可以直接使用的攻击文本,也不教怎么绕过。如果你还不清楚什么是越狱,先读 大模型越狱是什么;所有相关文章见 大模型越狱与安全专题。
要点速览(更新于 2026-11-04)
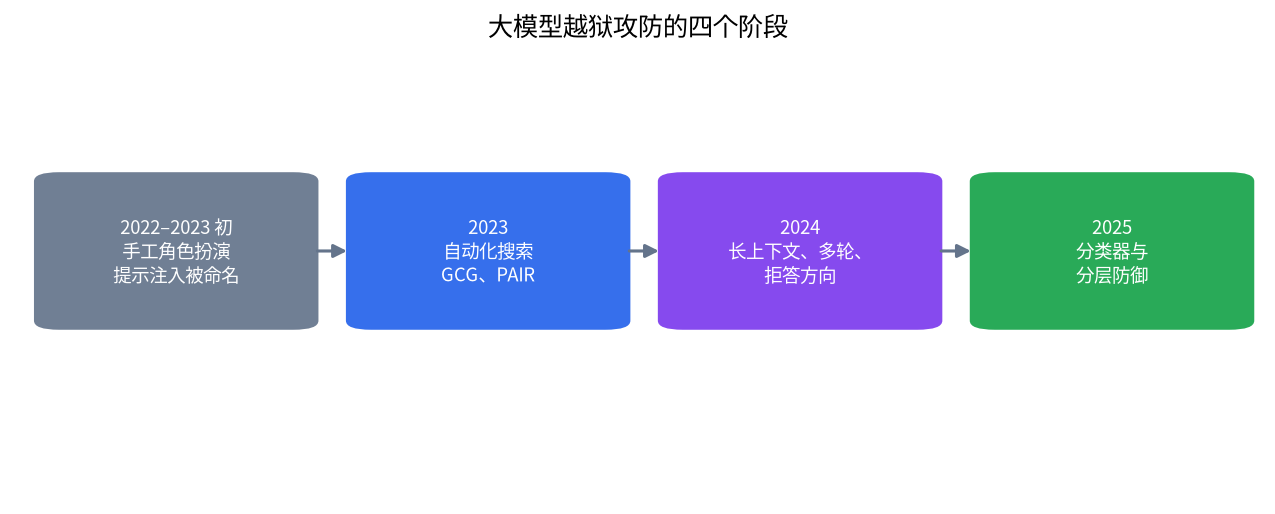
- 2022 年 9 月“提示注入”被命名,2023 年初手工的角色扮演类提示在社区流行,这是第一阶段。
2023 年 7 月,Wei 等人归纳出安全训练失败的两种原因;同月 GCG 展示了自动搜索攻击,第二阶段开始。
2024 年出现利用长上下文的 many-shot、利用多轮对话的 Crescendo,以及研究者发现“拒答”在模型内部可以对应一个方向。
2025 年 1 月,Anthropic 的宪法分类器把测试中的越狱成功率从 86% 压到 4.4%,防御从“只靠训练”变成“训练加分类器加监控”。
贯穿全程的教训:攻击会自动化、会随能力扩展,防御必须分层并持续测试。
阶段一(2022 到 2023 年初):提示注入与手工角色扮演
2022 年,聊天模型刚进入公众视野,人们很快发现一件事:模型分不清“开发者写的指令”和“用户输入的文字”,后者可以覆盖前者。2022 年 9 月,开发者 Simon Willison 把这类问题称为提示注入(prompt injection);同年 11 月,Perez 与 Ribeiro 的论文《Ignore Previous Prompt》对这类攻击做了系统的实验研究。
2023 年初,社区里出现了大量手工编写的角色扮演类提示:让模型扮演一个“不受限制的另一个自己”,用设定来压过安全训练。其中最出名的是一类被称为 DAN(Do Anything Now)的提示,随后不断出现各种变体。这一阶段的特点是:
- 靠人工试出来,传播靠论坛和社交媒体;
- 寿命很短:厂商发现后通过更新训练和过滤让其失效,然后又出现新变体,形成“打地鼠”式的循环;
- 研究价值:它们让研究者看到,安全训练在“换一种说法或设定”面前并不牢固。2023 年 8 月,Shen 等人发表《Do Anything Now》论文,收集并分析了社区里真实流传的越狱提示,让这个现象有了数据基础。
这一阶段还有一个容易混淆的点:提示注入和越狱不是一回事。前者的目标是让模型无视开发者的指令,后者的目标是让模型无视安全规则;两者经常同时出现,防御重点却不同。
阶段二(2023 年):从经验归纳到自动化搜索
2023 年 7 月,Wei 等人发表《Jailbroken: How Does LLM Safety Training Fail?》,归纳了安全训练失败的两种模式:目标冲突(模型既要听话又要安全,两者可以被对立起来)和泛化不匹配(安全训练覆盖的分布比模型能力覆盖的分布窄)。这篇论文第一次给“为什么会被越狱”提供了框架,后来的很多研究都沿用它的视角。
同月,Zou 等人发表了 GCG(Greedy Coordinate Gradient)攻击,展示了一件让业界警觉的事:攻击文本可以由算法自动搜索出来,不再需要人想,而且在开放权重模型上搜出的结果,有一部分可以迁移到闭源模型上。这改变了威胁模型:攻击者的成本从“人的创造力”变成“算力”。不过这类自动生成的文本通常看起来像乱码,可以被困惑度过滤等手段部分发现,这也是后来防御研究的一个出发点。
2023 年 10 月,Chao 等人发表 PAIR:让一个“攻击者模型”和一个“目标模型”对话,攻击者根据反馈不断改写,论文摘要称通常只需要不到二十次查询。它说明攻击可以做到黑盒、语义化、低成本。
这一阶段防御侧也有重要进展:2023 年 12 月 Meta 发布 Llama Guard,把“安全判断”做成一个独立的、可部署的开源分类模型(部署见 Llama Guard 本地部署教程)。
阶段三(2024 年):长上下文、多轮对话与“拒答方向”
2024 年,模型的上下文窗口和对话能力大幅增强,新能力带来了新攻击面:
- many-shot(多样本): 2024 年 4 月,Anthropic 披露,利用很长的上下文窗口,在对话里堆入大量示例,可以逐步改变模型的行为,其有效性随示例数量呈幂律增长。它说明窗口越长,需要防的面越大。
- Crescendo(渐进式多轮): 2024 年 4 月,Microsoft 的研究者提出,通过一系列看似无害、逐步升级的对话轮次引导模型,每一步单独看都不违规。它说明只检查单条消息是不够的,要看整个对话。
- Skeleton Key: 2024 年 6 月 26 日,Microsoft 披露这一类“让模型自行放宽安全准则”的技术,并给出了缓解建议,包括输入输出过滤和滥用监控。
- HarmBench: 2024 年 2 月,标准化的评测框架发布,让不同攻击和防御第一次可以在同一条件下比较。
- 拒答方向: 2024 年 6 月,Arditi 等人发现拒答行为在多个模型的内部表示中对应着一个方向,抹掉它就能显著削弱拒答。这是对权重的修改,而不是对输入的操纵,也是后来社区里“去审查”模型的理论基础,我们在 拒答方向消融详解 里讲过原理与风险。同月,Zou 等人提出的 circuit breakers 尝试在内部表示层面直接打断有害生成。
2024 年的主题是:攻击从输入的措辞,扩展到上下文、对话结构和权重本身。
阶段四(2024 年底到 2025 年):规模化、分类器与分层防御
2024 年 12 月,Hughes 等人发表 Best-of-N:对同一个请求反复做随机的小改动(大小写、打乱、噪声等),每次独立尝试,成功率随尝试次数呈幂律上升,论文称在 10,000 次增强采样下对部分前沿模型达到较高成功率。这个结果说明一个朴素但重要的道理:如果单次成功率不是零,足够多的尝试就会成功。
2025 年 1 月,Anthropic 发布宪法分类器(Constitutional Classifiers):用一份书面的“宪法”生成大量合成数据,训练输入和输出分类器。其自测中,越狱成功率从 86% 降到 4.4%,同时在真实对话上只带来约 0.38% 的额外拒答和约 23.7% 的额外推理开销(均为厂商自报,仅在其测试条件下成立);他们还公开邀请红队挑战。这标志着防御思路从“主要靠训练”转到了“训练加分类器加监控”,原理见 越狱防御怎么做。
2025 年下半年,开源社区的护栏模型也跟进,例如 Qwen3Guard 和 gpt-oss-safeguard,让本地部署者也能搭出类似的分层结构。
大模型越狱简史:关键事件时间线
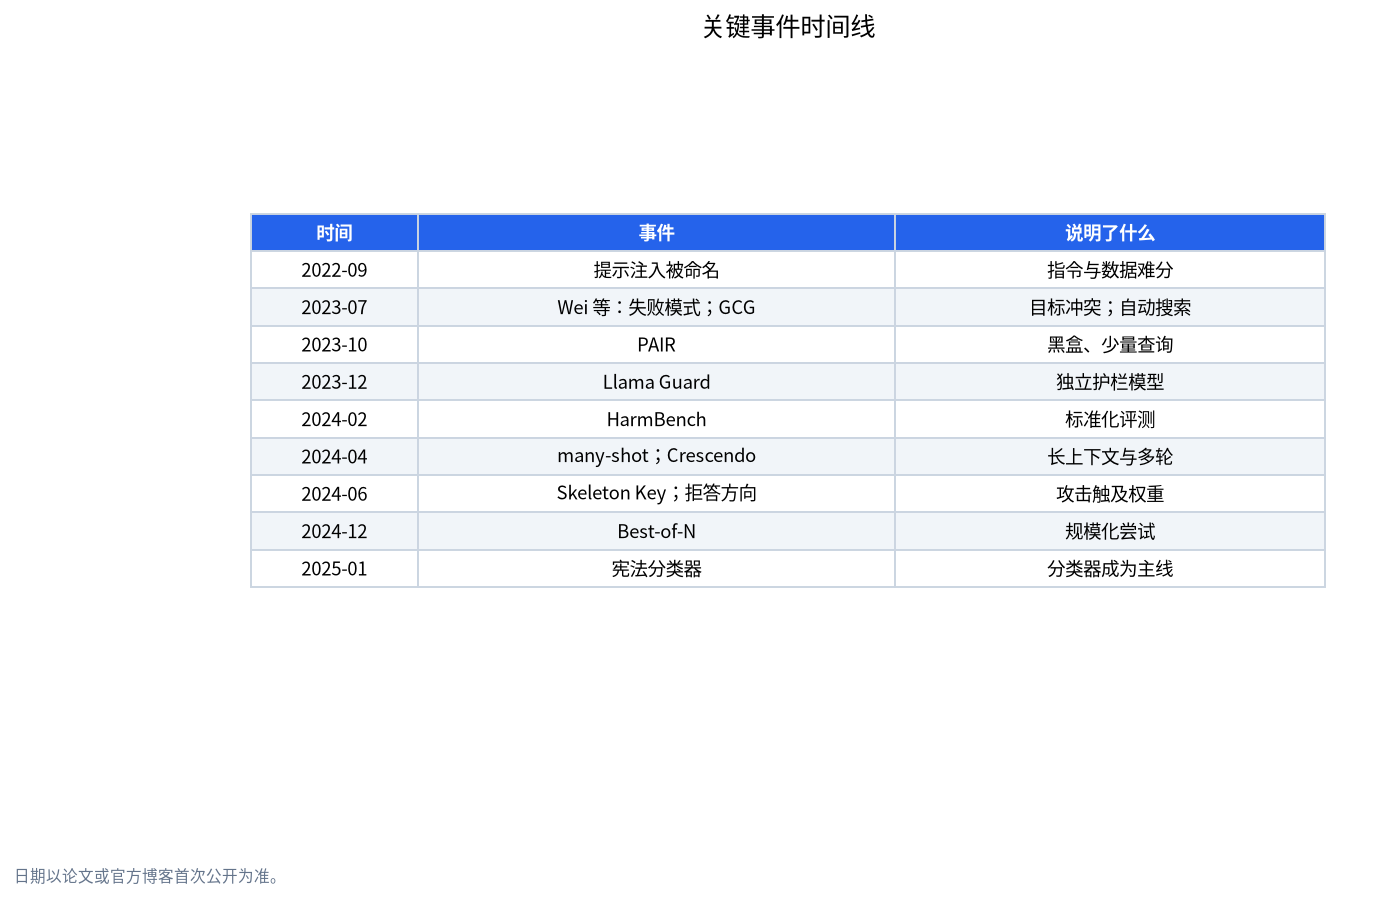
| 时间 | 事件 | 说明了什么 |
|---|---|---|
| 2022 年 9 月 | “提示注入”被命名 | 模型分不清指令与数据 |
| 2022 年 11 月 | Perez 与 Ribeiro 的论文 | 提示注入有了实验研究 |
| 2023 年 7 月 | Wei 等人的失败模式归纳 | 目标冲突与泛化不匹配 |
| 2023 年 7 月 | GCG | 攻击可以自动搜索,并可迁移 |
| 2023 年 10 月 | PAIR | 黑盒、语义化、少量查询 |
| 2023 年 12 月 | Llama Guard | 独立的开源护栏模型 |
| 2024 年 2 月 | HarmBench | 标准化评测 |
| 2024 年 4 月 | many-shot 与 Crescendo | 长上下文与多轮对话成为新攻击面 |
| 2024 年 6 月 | Skeleton Key、拒答方向、circuit breakers | 攻击扩展到权重,防御深入内部表示 |
| 2024 年 12 月 | Best-of-N | 规模化尝试 |
| 2025 年 1 月 | 宪法分类器 | 分类器成为主流防线 |
一个算例:为什么“单次测试”低估风险
Best-of-N 的结果可以用一个简单算式理解:如果某个请求每次独立尝试的成功率是 p,尝试 n 次至少成功一次的概率是 1 − (1 − p)^n。假设 p = 0.1%:
- n = 1:0.1%
- n = 10:约 1.0%
- n = 100:约 9.5%
- n = 1,000:约 63.2%
- n = 10,000:约 99.995%
| 尝试次数 n | 单次 0.01% | 单次 0.1% | 单次 1% |
|---|---|---|---|
| 1 | 0.01% | 0.1% | 1% |
| 100 | 约 1.0% | 约 9.5% | 约 63.4% |
| 1,000 | 约 9.5% | 约 63.2% | 约 99.996% |
| 10,000 | 约 63.2% | 约 99.995% | 约 100% |
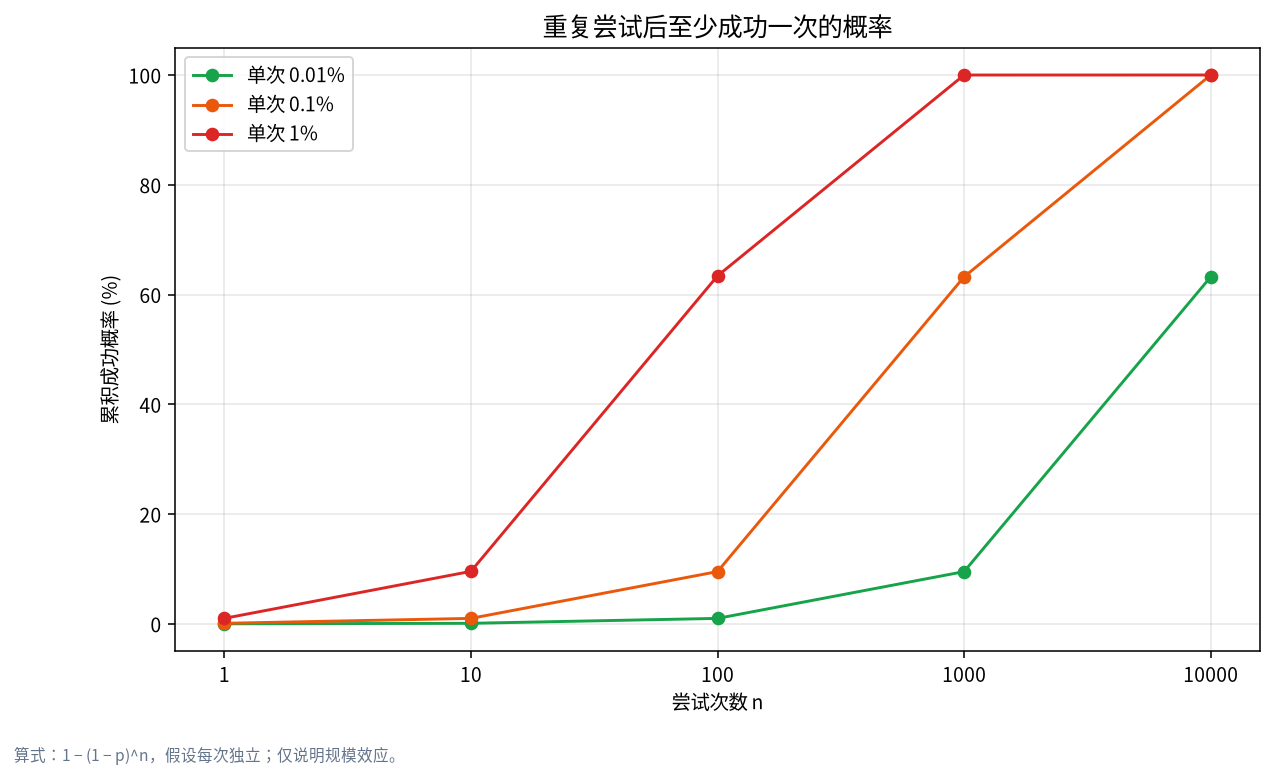
这是假设每次尝试相互独立的理想算式,真实情况并不完全独立,但它说明了两件事:第一,只测一次说“没被攻破”几乎没有意义,评估要看大量采样下的整体比率;第二,速率限制、滥用监控和账号封禁之所以重要,是因为它们直接限制了 n。
演变中的几条规律
- 新能力带来新攻击面: 长上下文带来 many-shot,多轮对话带来 Crescendo,工具调用带来注入,开放权重带来权重编辑。
- 攻击自动化: 从人工试错到算法搜索再到模型对模型,成本不断下降,所以防御也必须自动化、持续化。
- 打补丁不够: 厂商每封一个具体提示,社区就会出现新变体,因此防御从“堵具体写法”转向“在更深的层面判断意图”。
- 开放权重无法回收补丁: 一旦权重被修改或二次训练,原厂的防线就不再起作用,需要部署者自行加护栏(见 Qwen 本地部署需要破甲吗)。
- 评估标准化: 从各说各话到 HarmBench 等基准,让攻防第一次可以比较,但基准也会过时。
- 传闻要核查: 每当有“某某模型被一句话攻破”的消息,要先找到论文或可复现的评测;我们对几个流传的案例做过核查,例如 GSQ 与 RCO 说法核查 和 Mythos 泄露传闻核查。
对普通用户和开发者意味着什么
- 普通用户: 看到“一句话越狱”的内容要谨慎,多数已经失效,且可能涉及违规或安全风险;使用任何第三方改过的权重前,先看来源和校验。
- 开发者: 不要把安全完全押在模型自带的拒答上;给应用加输入输出审核、限制权限、做速率限制和日志,并定期做红队测试(见 本地模型红队测试入门)。
- 研究者: 复现实验时遵守负责任披露的规范,在隔离环境使用公开基准,不公开可直接使用的攻击文本。
常见问题 FAQ
第一个“越狱”是什么时候出现的?
没有统一的“第一个”。2022 年 9 月提示注入被命名,2023 年初社区的角色扮演类提示流行开来,一般被视为越狱受到广泛关注的起点。
GCG 为什么重要?
它第一次证明攻击文本可以由算法自动搜索,而且部分结果能迁移到别的模型,使攻击成本从人力变成算力。
现在的模型还能被越狱吗?
可以。2025 年的结果显示,分类器能显著降低已知通用攻击的成功率,但没有哪个团队声称做到了百分之百。
为什么厂商不直接公开所有攻击细节?
负责任披露要求先让防御方有时间修复,同时不提供可直接使用的攻击文本;论文通常给出方法和评测,而不是即用的提示。
开源模型比闭源模型更容易被越狱吗?
开放权重模型可以被修改或二次训练,原厂的防线无法回收,所以风险模式不同,但并不是说闭源模型就不会被越狱。
想继续了解,应该读什么?
按顺序读 大模型越狱是什么、越狱防御怎么做,再看 红队测试入门。
和我们聊聊
如果你在做模型安全评估,或者想核查某条关于“越狱”的传闻,欢迎到社区留言,或邮件 admin@microaione.com。更多文章见大模型越狱与安全专题。
参考资料:Perez 与 Ribeiro(arXiv 2211.09527)、Wei 等人(arXiv 2307.02483)、GCG(arXiv 2307.15043)、Crescendo(arXiv 2404.01833)、Best-of-N(arXiv 2412.03556)、宪法分类器(arXiv 2501.18837)。日期以论文或官方博客首次公开为准,读取于 2026-11-04,北京时间。