Eleven v4 Turbo 评测:最好的 TTS?对比 Qwen-Audio、Gemini TTS 与本地 Fish Drama 3
Eleven v4 Turbo 是 ElevenLabs 的实时语音合成模型。按 Artificial Analysis 语音竞技场(2026-11-01 读取),它以 Elo 1336 排在第 1。但榜单上有一个重要的细节:它与排第 2 的 Eleven v4(1334)的置信区间重叠,统计上是平手,而不是明确领先。再者,这个第一名的价格是每 100 万字符约 40 美元,排在后面的几个模型有的只要它的一半不到。本文把榜单、价格、延迟和本地替代放在一起,重点回答:如果你做的是本地语音助手或有声内容,什么时候值得付 ElevenLabs 的钱,什么时候应该用能下载的模型。
核实说明:榜单与价格读取自 Artificial Analysis 语音竞技场(2026-11-01);ElevenLabs 模型能力、延迟与字符限制读取自其官方文档的模型页;Fish Audio Drama 3 的参数与延迟读取自 Hugging Face 上的模型卡(数据为官方在 H200 上测得)。我们没有自己合成或听评过音频,没有主观音质评价;成本是我们的算术。ElevenLabs 自家的订阅价格没有在本文核实,价格均取自榜单列出的每 100 万字符价。
要点速览(更新于 2026-11-01)
- 榜单:Eleven v4 Turbo 1336(±16),Eleven v4 1334(±15),两者统计上持平;Qwen-Audio-3.1-TTS-Plus 1305,Sonic 3.6 为 1296。
价格:Eleven v4 Turbo 约 40 美元每 100 万字符,v4 约 80 美元;Gemini 3.8 Flash TTS 约 16.5 美元,Fish Drama 3 约 15 美元,Kokoro 82M 约 0.65 美元。
本地:开放权重里最强的是 Fish Audio Drama 3(Elo 1278,35B MoE、每 token 激活 3B);官方在一块 H200 上单路首包延迟 p50 为 88.9 毫秒。
先看结论:并列第一,但不是最便宜
| 排名 | 模型 | Elo | 每 100 万字符(美元) | 备注 |
|---|---|---|---|---|
| 1 | Eleven v4 Turbo | 1336(±16) | 40 | 2026 年 9 月,实时型 |
| 2 | Eleven v4 | 1334(±15) | 80 | 与 v4 Turbo 在置信区间内 |
| 3 | Qwen-Audio-3.1-TTS-Plus | 1305 | 19.3 | — |
| 4 | Sonic 3.6 | 1296 | 49 | — |
| 5 | Gemini 3.8 Flash TTS | 1283 | 16.5 | — |
| 6 | Fish Audio Drama 3 | 1278 | 15 | 开放权重中最高 |
| 9 | Lightning V3.1 Pro | 1266 | — | — |
| 23 | Eleven v3 | 1188 | 100 | 上一代 |
| 62 | Kokoro 82M v1.0 | 1062 | 0.65 | 榜上最便宜 |
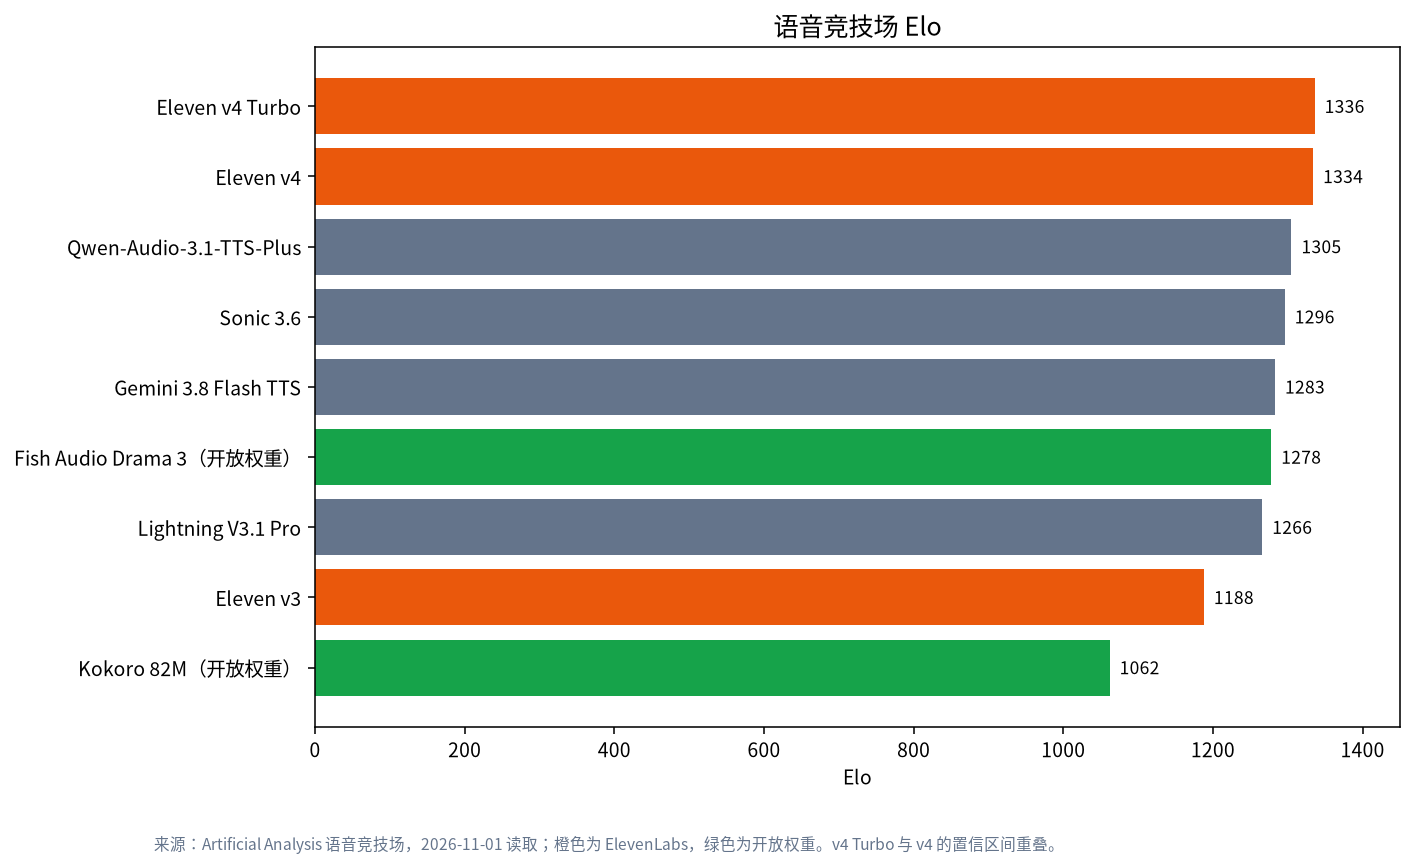
这里有三个值得注意的点。第一,v4 Turbo 与 v4 只差 2 分,而误差是 ±15 到 ±16,所以二者在偏好上等价;但 v4 Turbo 价格是 v4 的一半,且按官方文档是”最具表现力的实时模型”,中位延迟约 100 毫秒(不含应用与网络延迟)。第二,榜单的价格是 Artificial Analysis 列出的数字,具体计费以 ElevenLabs 的订阅为准。第三,前六名的 Elo 跨度是 58 分,不算大:按标准 Elo 换算(我们的假设),v4 Turbo 对 Fish Drama 3 的单次偏好约 58%,对 Qwen-Audio-3.1-TTS-Plus 约 54%,对 Kokoro 约 83%。
ElevenLabs 官方文档里的 v4 Turbo
读取官方模型页后的要点:Eleven v4 Turbo 面向实时合成,中位延迟约 100 毫秒,支持 90 多种语言,支持高保真声音克隆和用于精细控制的音频标签,通过 Text to Dialogue WebSocket 使用。作为对照,Eleven v4 的单次请求上限为 10,000 字符,更适合有声书与角色配音;Flash v2.5 延迟约 100 毫秒、支持 32 种语言,单次可达 40,000 字符,API 价格低 50%。文档还说,Flash v2.5 默认关闭文本规范化(数字、日期、电话),企业用户可开启,所以做电话号码播报时要特别注意。
成本:一个语音智能体与一本有声书
用榜单价格做两个算例(我们的算术,不含订阅差异与重试)。
算例一:语音智能体。 ElevenLabs 文档的压测示例假设每次 TTS 调用约 150 字符。假设每通电话 10 轮、每月 10,000 通电话,总计 1,500 万字符:
| 方案 | 每 100 万字符 | 月成本(1,500 万字符) |
|---|---|---|
| Eleven v4 Turbo | 40 美元 | 约 600 美元 |
| Gemini 3.8 Flash TTS | 16.5 美元 | 约 247.5 美元 |
| Fish Audio Drama 3(榜单价) | 15 美元 | 约 225 美元 |
| Kokoro 82M(榜单价) | 0.65 美元 | 约 9.75 美元 |
算例二:50 万字符的有声书。
| 方案 | 费用 |
|---|---|
| Eleven v4 | 约 40 美元 |
| Eleven v4 Turbo | 约 20 美元 |
| Qwen-Audio-3.1-TTS-Plus | 约 9.65 美元 |
| Fish Audio Drama 3(榜单价) | 约 7.5 美元 |
| Kokoro 82M(榜单价) | 约 0.33 美元 |
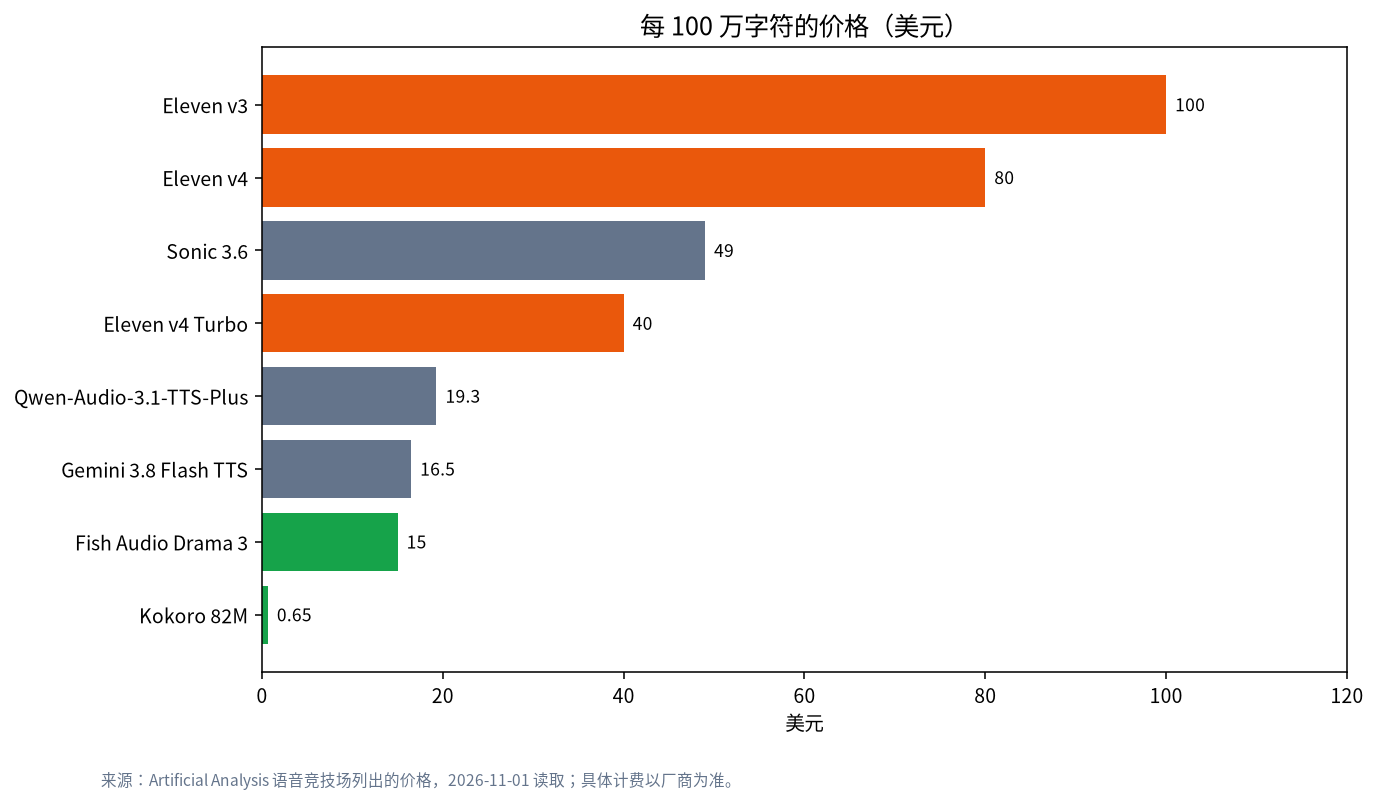
结论:做一次性的有声内容,成本差异不大,直接选质量;做持续运行的语音智能体,价格会按月累积,质量与价格之间要做取舍。
本地能用什么:Fish Audio Drama 3 与 Kokoro
| 模型 | 规模与特点 | 实测数据 | 说明 |
|---|---|---|---|
| Fish Audio Drama 3 | 35B 参数 MoE,每 token 激活 3B;专家为 FP8,其余为 bf16;一段文本最多 16 个角色;支持声音克隆与自然语言控制 | 官方在一块 H200 上:单路首包延迟 p50 88.9 毫秒,实时因子 0.131;16 路并发 p50 为 210.1 毫秒;64 路 p50 为 450.9 毫秒、p95 为 1,020.1 毫秒 | Fish Audio Community License,商用条款请自行阅读;模型卡未给出最低显存,不要自行假设 |
| Kokoro 82M v1.0 | 8200 万参数的小模型 | 榜单 Elo 1062,每 100 万字符约 0.65 美元(榜单价) | 体积很小,但与榜首差 274 分 |
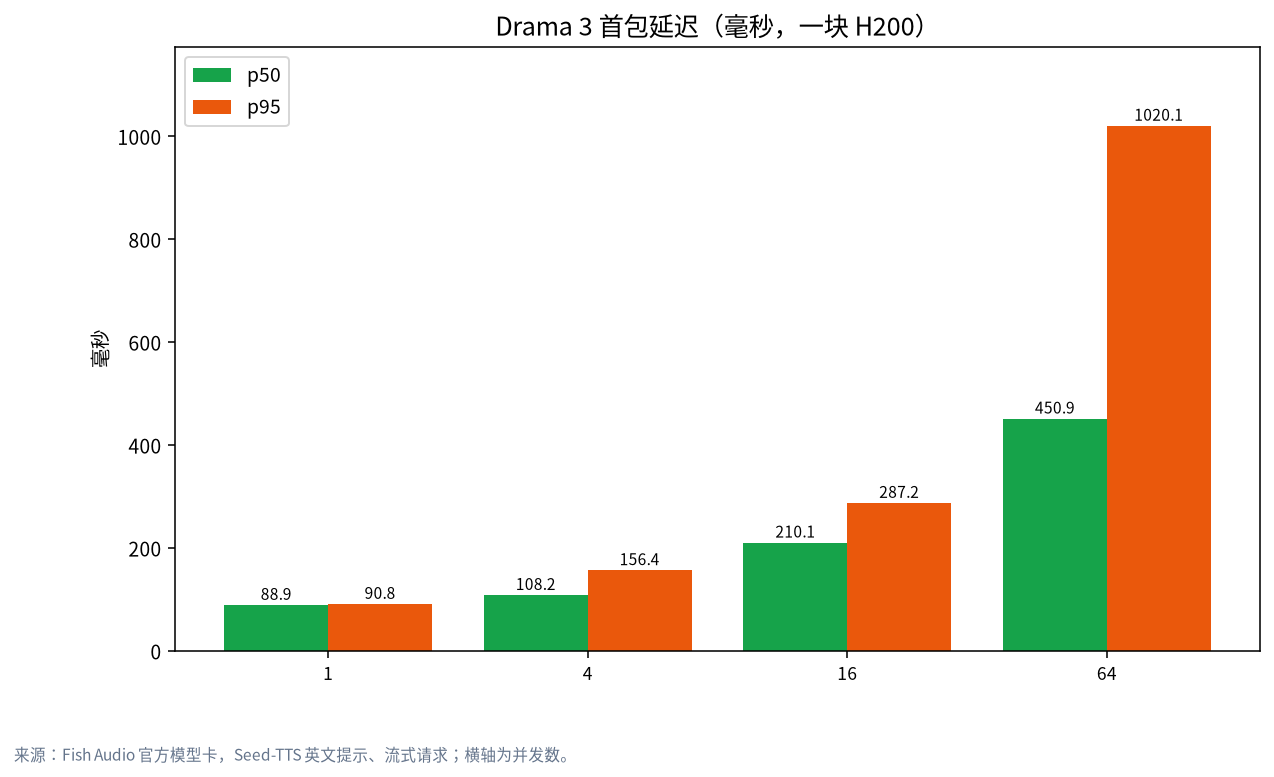
Drama 3 的模型卡说明,它在 SGLang-Omni 与 vLLM-Omni 上都支持,并且用第二块 GPU 放声码器时,256 路并发的吞吐提高约 72%,中位首包延迟降低 37%。这些都是 H200 级别的数据:如果你只有消费级显卡,我们没有找到 Drama 3 在消费级显卡上的官方数据,所以不下结论。想看这类服务的部署,可参考 vLLM 与 SGLang 入门、本地模型 API 服务器;硬件见 RTX PRO 6000 工作站。如果文本含有隐私内容,本地合成的好处见本地 AI 与隐私。
榜单怎么读:竞技场、置信区间与”听感”
Speech Arena 的做法是让听者对同一段文本的两个合成结果做盲选,再据此计算 Elo。读这类榜单要记住两件事。首先,榜单测的是整体偏好,而不是某个具体指标:它不会告诉你一个模型读电话号码是否出错、中文多音字是否读对、长文本是否会漂移。其次,置信区间决定了名次是否可靠:v4 Turbo 为 ±16,v4 为 ±15,两个区间完全重叠,所以把它们的先后顺序当成事实是不严谨的。如果你想进一步了解如何阅读评测榜单,可以看怎么读模型评测榜单。
实时语音智能体的延迟预算
做语音智能体时,用户感受到的”响应速度”是几个环节叠加的结果:语音识别把话转成文字,大语言模型生成回复,语音合成把回复读出来,再加上网络传输。TTS 的首包延迟只是其中一环,所以厂商公布的”约 100 毫秒”并不等于用户听到声音的时间。ElevenLabs 文档也特别说明,这个数字是中位值且不含应用与网络延迟。实践中,如果你的大语言模型本身要几百毫秒才吐出第一个词,那么把 TTS 从 100 毫秒优化到 50 毫秒的收益有限;更有效的做法是让 LLM 流式输出,并让 TTS 一句一句地合成,这样第一句话在模型还在生成后半句时就已经开始播放。
另外,并发限制决定了你能同时服务多少路:ElevenLabs 文档列出了各订阅档位的并发上限,并给出经验法则,并发上限为 5 时大约能支撑 100 路左右的同时在线语音广播,原因是音频生成速度远快于播放速度。我们建议在上线前,用文档里”模拟用户而不是模拟请求”的压测思路,自己跑一遍。
按场景选择
| 场景 | 建议 | 理由 |
|---|---|---|
| 实时语音客服或助手 | Eleven v4 Turbo,或更便宜的 Gemini 3.8 Flash TTS | 前者榜单第一且延迟约 100 毫秒;后者价格不到一半,榜单第 5 |
| 有声书与角色配音 | Eleven v4 或 Qwen-Audio-3.1-TTS-Plus | v4 单次上限 10,000 字符;后者价格约为 v4 的四分之一 |
| 多人广播剧 | Fish Audio Drama 3 | 一段文本最多 16 个角色,可本地部署 |
| 数据不能出本机 | Fish Audio Drama 3 或 Kokoro 82M | 开放权重 |
| 极致低成本的提示音 | Kokoro 82M | 榜单价格约 0.65 美元每 100 万字符,但与榜首差 274 分 |
本地部署的现实考虑
开放权重不等于便宜。Drama 3 是 35B 参数的 MoE,官方数据来自 H200,这意味着要自己跑,需要的是服务器级显卡而不是游戏卡;而且为了让首包延迟稳定,官方还建议在高并发时把声码器放到第二块 GPU 上。算成本时要把显卡租金、电费和运维时间都算进去:如果你每月的合成量只有几百万字符,榜单上每 100 万字符 15 美元的价格意味着总账单不到一百美元,自建几乎不可能划算;自建的理由应当是数据留存、定制声音和离线运行,而不是省钱。
自己复现:TTS 对比的测试方法
我们没有听评过这些模型,下面是你可以直接执行的流程。
- 准备 30 段文本:10 段中文新闻、10 段英文对话、5 段带数字与日期(电话号码、金额)、5 段情绪化台词。
- 统一输出格式:同样的采样率与音量归一。
- 可懂度:用同一个语音识别模型转写合成音频,计算字错误率;这不依赖主观判断。
- 盲听偏好:打乱顺序,请 5 位听者成对挑选,统计胜率。
- 延迟:记录首包延迟(从发出请求到收到第一段音频),在你的真实并发下取 p50 与 p95。
- 数字与专名:单独统计电话号码、日期、品牌名的读错率。
- 算成本:云端按字符计,本地按 GPU 租金或折旧加电费除以合成的字符数。
您好,您的订单 20261101-0087 已发货,预计 11 月 3 日下午送达,
金额 1,299.50 元。如需修改地址,请在两小时内回复“修改”。
[laughs] Thanks for your patience, and have a great day!
常见错误
- 把”榜首”读成”明显领先”:v4 Turbo 与 v4 只差 2 分,置信区间重叠。
- 用榜单价格当作账单:具体计费以厂商订阅为准。
- 忽视数字与日期的规范化:Flash v2.5 默认不规范化,电话号码可能读错。
- 拿 H200 的延迟推断消费级显卡:Drama 3 的数据只对应 H200。
- 只听英文样例:如果你的用户说中文,一定要用中文文本盲听。
相关阅读
常见问题:Eleven v4 Turbo
Eleven v4 Turbo 是最好的 TTS 吗?
在 Artificial Analysis 语音竞技场它以 1336 排第 1,但与 Eleven v4(1334)置信区间重叠,统计上平手。
Eleven v4 Turbo 多少钱?
榜单列出每 100 万字符约 40 美元;Eleven v4 约 80 美元。具体计费以 ElevenLabs 为准。
延迟是多少?
ElevenLabs 文档称中位延迟约 100 毫秒,不含应用与网络延迟。
有能本地运行的 TTS 吗?
有。榜单上开放权重最强的是 Fish Audio Drama 3(1278),官方在 H200 上测得单路首包延迟 p50 为 88.9 毫秒;也有体积很小的 Kokoro 82M(1062)。
Drama 3 能商用吗?
它使用 Fish Audio Community License,具体商用条款需阅读许可证文件,本文不作结论。
哪个性价比最高?
Qwen-Audio-3.1-TTS-Plus(1305,约 19.3 美元)与 Gemini 3.8 Flash TTS(1283,约 16.5 美元)是榜单上”接近第一而便宜得多”的选项。
和我们聊聊
在为产品选语音合成方案?欢迎到社区交流,或者发邮件到 admin@microaione.com。
参考资料:Artificial Analysis 语音竞技场、ElevenLabs 官方文档:模型、Hugging Face:fishaudio/drama-3。