企业大模型内容安全清单:护栏、日志与审计怎么做(对照 GB/T 45654)
公司把大模型部署到内网之后,常见的下一个问题是:员工或客户用它的时候,万一生成了不该生成的内容、泄露了不该泄露的资料,怎么办?这就是大模型内容安全要解决的事:在模型前后加上检查(护栏),把每次请求记录下来(日志),并能事后复盘(审计)。这篇文章对照中国国家标准 GB/T 45654-2025《网络安全技术 生成式人工智能服务安全基本要求》的条款,给企业一份可落地的清单:五层控制、护栏模型怎么选、日志记什么、怎么做内部验收。本文不是法律意见;我们没有对任何产品做实测,护栏模型的数据都来自各自的论文摘要。资料读取日期 2026-11-04。
要点速览(更新于 2026-11-04)
- GB/T 45654-2025 的重点面向具有舆论属性或社会动员能力的生成式 AI 服务,用于支撑备案管理与检测评估;它是推荐性标准,内部使用的企业可以把它当作参考框架,而不是自动适用的法定义务。
五层控制:用途与范围、输入检测、模型层、输出检查、日志审计与应急;标准正文 5.3、5.2、6.5、6.7 等条款都能找到对应要求。
护栏模型(Llama Guard、ShieldGemma、Granite Guardian、Qwen3Guard 等)能对提示与回答做分类,但它们是概率性的,要与最小权限和人工复核配合。
标准附录 B 给了内部验收可借鉴的数字:关键词库不少于 10000 个、测试题库不少于 2000 题、生成内容合格率不低于 90%(抽检不少于 1000 条)、应拒答题拒答率不低于 95%。
日志既是审计依据,本身也含个人信息和商业秘密:要最小化记录、控制访问、定期清理。
GB/T 45654 管谁,对企业意味着什么
标准的“范围”一章写明:它规定了生成式 AI 服务在训练数据安全、模型安全、安全措施等方面的要求,适用于服务提供者开展相关活动,也为主管部门和第三方评估机构提供参考。“引言”说明它重点面向具有舆论属性或者社会动员能力的服务,用于支撑备案管理、检测评估。附录 A(资料性)列出 5 大类共 31 种安全风险,附录 B(资料性)给出安全评估参考方法。
对企业而言可以这样理解:如果你向公众提供生成式 AI 服务,需要对照合规要求;如果只是公司内网自用,这份标准不一定直接适用,但它的条款是一份现成的、有数字的检查框架。适用性的判断要结合《生成式人工智能服务管理暂行办法》等法规,见去审查模型的合规风险,必要时咨询律师。
大模型内容安全的五层控制:把标准条款落到企业部署上
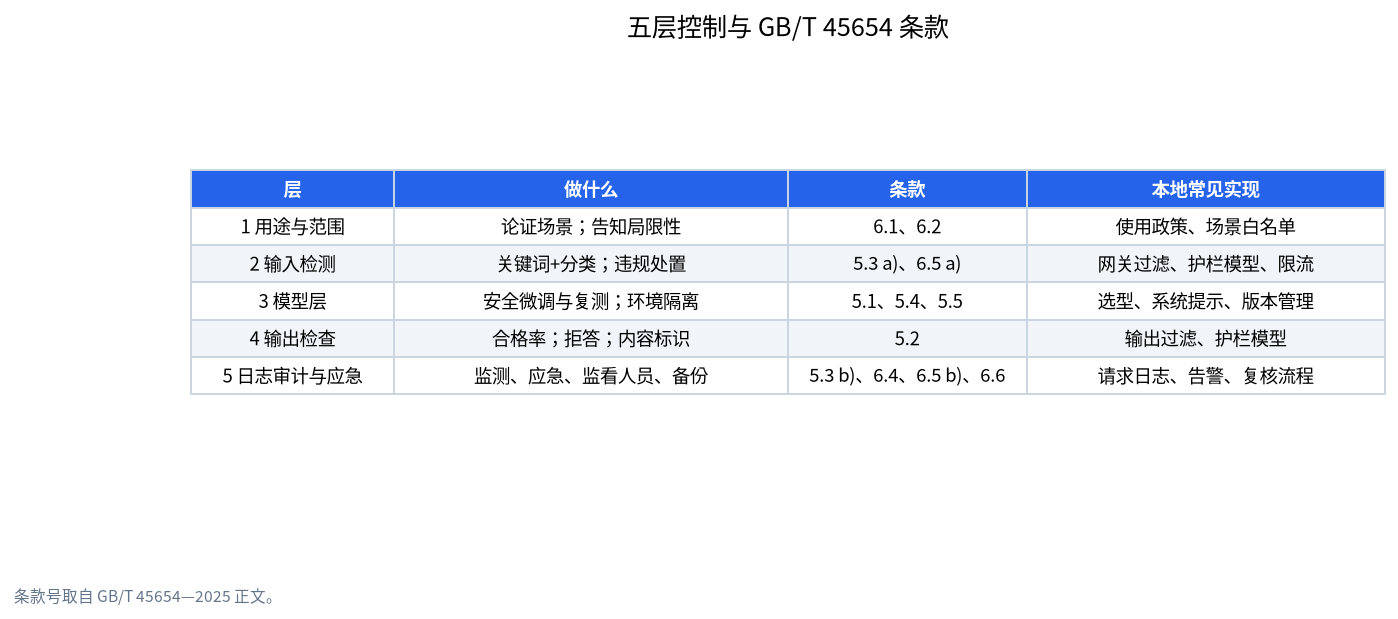
| 层 | 要做什么 | 对应标准条款(正文) | 本地常见实现 |
|---|---|---|---|
| 1 用途与范围 | 论证在哪些场景用、不用;重要场合加强保护;告知局限性 | 6.1、6.2 | 使用政策、场景白名单、界面提示 |
| 2 输入检测 | 对输入做关键词与分类检测;多次违规的处置规则 | 5.3 a)、6.5 a) | 网关层过滤、护栏模型、限流与暂停账号 |
| 3 模型层 | 安全微调与复测;开发框架安全审计;后门检测;训练与推理环境隔离 | 5.1、5.4、5.5 | 选型、系统提示、微调、版本管理 |
| 4 输出检查 | 合格率、拒答(明显有害的拒绝,其他应回答)、内容标识 | 5.2 | 输出过滤、护栏模型、水印与标识 |
| 5 日志审计与应急 | 监测测评、应急处置、监看人员、投诉渠道、备份恢复 | 5.3 b)、6.4、6.5 b)、6.6 | 请求日志、告警、复核流程、备份 |
标准还有一条与本地部署特别相关:6.7 端侧模型服务要求具备端侧安全模块,利用关键词库等技术对生成内容做安全审核,收集并留存安全日志,支持在联网时上传或在本地导出,并定期更新关键词库。
要强调的一点:5.3 a) 明确要求“对模型输入内容持续监测,防范恶意输入攻击,例如注入攻击、数据窃取、对抗攻击等”。提示词注入的原理和防护见提示词注入与越狱的区别。
护栏模型怎么选
护栏模型是专门做“安全分类”的小模型,可以放在主模型前后检查提示与回答。以下信息均来自各论文摘要,我们没有做实测:
| 护栏模型 | 摘要里的要点 | 备注 |
|---|---|---|
| Llama Guard(Meta) | 基于 Llama2-7b 指令微调的输入输出防护模型,带一套安全风险分类,可做提示分类与回答分类 | 第一代;后续版本请查官方仓库 PurpleLlama |
| ShieldGemma(Google) | 基于 Gemma2 的内容审核模型套件,覆盖色情、危险内容、骚扰、仇恨言论,报告在公开基准上 AU-PRC 比 Llama Guard 高 10.8% | 数字为作者自报 |
| Granite Guardian(IBM) | 覆盖社会偏见、脏话、暴力、越狱以及 RAG 的上下文相关性、有据性等风险 | 对 RAG 场景有专门维度 |
| Qwen3Guard(阿里) | 提供三类判断(安全、有争议、不安全);Stream 版本可在生成过程中逐 token 监测;0.6B、4B、8B 三种尺寸,支持 119 种语言与方言,Apache 2.0 许可 | 摘要称在中英文及多语言基准上表现领先(作者自报) |
选型时注意三点:一是你的语言,中文业务要看中文评测;二是你的风险分类,通用分类与你的行业规则不一定一致,要用自己的题库验证;三是许可证,除 Qwen3Guard 摘要明确写了 Apache 2.0 外,其他请自行核对。
显存算例(我们的公式估算,不是实测):8B 参数的护栏模型按 FP16 约需 16 GB,按 4 位量化约 8×10⁹×0.5 字节≈4 GB,再加上运行开销大约 4–5 GB;0.6B 的模型 FP16 约 1.2 GB。也就是说,在已经为主模型占用大部分显存的服务器上,小尺寸护栏模型更容易同机部署,而 8B 级的护栏模型往往需要单独的显卡或放在 CPU/另一台机器上。显存估算方法见显存计算器指南。
日志与审计:记什么、怎么管
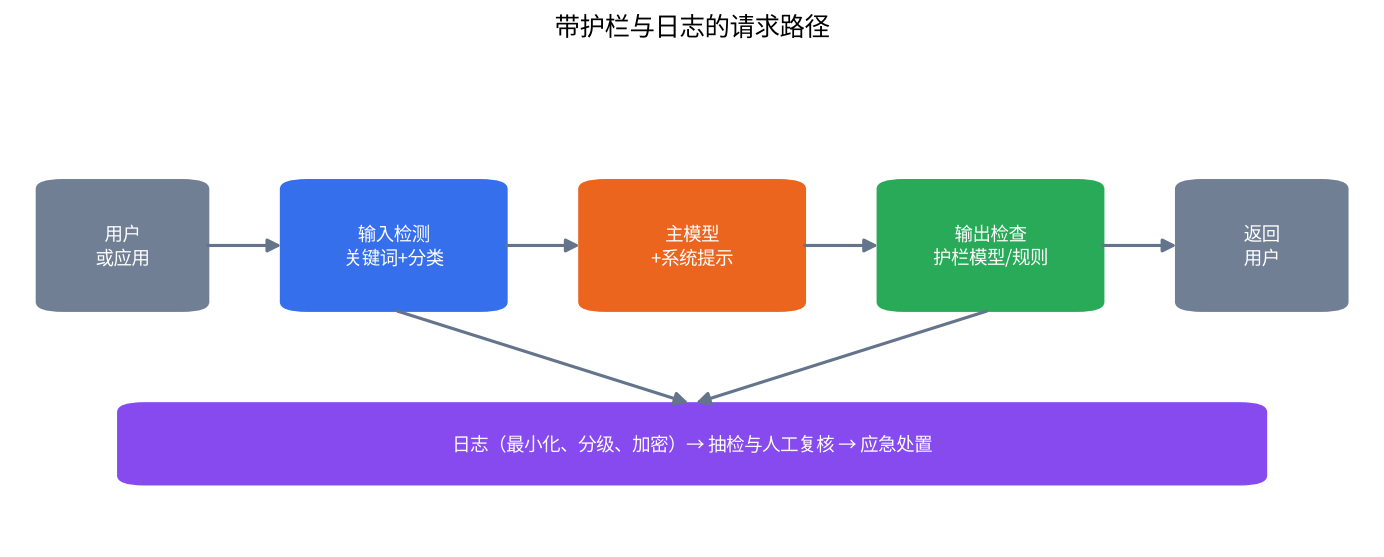
日志是审计和应急的基础,标准在 5.3 b) 和 6.5 b) 里要求建立常态化监测测评手段与应急措施,并设置监看人员。建议的最小字段:
- 时间、用户或应用标识(可用代号而非姓名)、请求来源;
- 模型名称与版本、系统提示版本、采样参数;
- 输入与输出的摘要或全文(按敏感程度分级)、护栏判定结果与命中的规则;
- 工具调用与检索到的文档标识(RAG 与 Agent 场景);
- 人工复核的结论与处置记录。
日志本身是敏感数据:它包含员工的提问和模型的回答,可能有个人信息和商业秘密。所以要最小化记录(能记摘要就不记全文)、分级授权访问、加密存放、定期清理,保留期限按法规与内部制度确定,我们不给具体期限。
容量算例(假设数字,不是实测):50 位员工,每人每天 40 次请求,每条日志含输入输出约 6 KB,一天约 50×40×6 KB=12 MB,一年约 4.4 GB,普通磁盘完全放得下;真正的成本在于有人定期去看——标准要求监看人员数量与服务规模匹配,小团队可以由安全负责人每周抽查固定数量的记录。
内部验收:借用附录 B 的数字
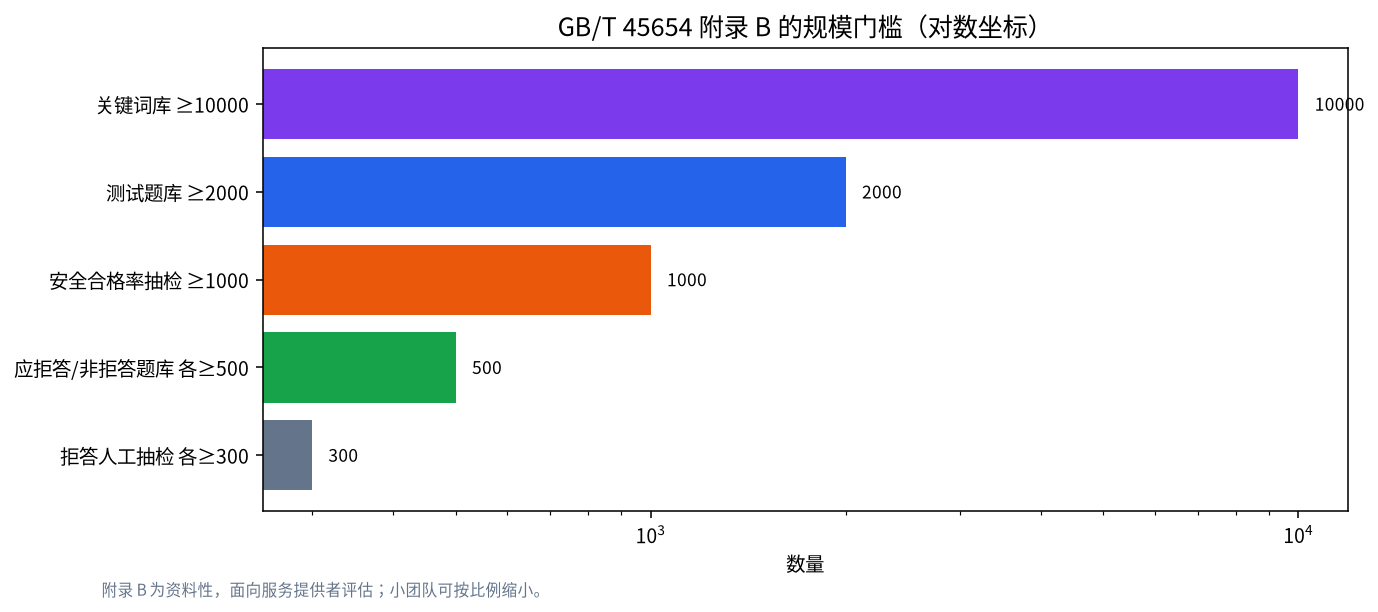
附录 B 是面向服务提供者的评估参考方法,小团队不必照搬规模,但可以借用它的结构和数字:
| 项目 | 附录 B 的参考值 | 小团队内部自测的思路 |
|---|---|---|
| 关键词库 | 总规模不少于 10000 个;每周至少更新一次 | 从行业词表起步,设专人维护与更新频率 |
| 生成内容测试题库 | 不少于 2000 题;每月至少更新一次 | 按自己的业务风险缩小规模,但要覆盖全部使用语言 |
| 应拒答与非拒答题库 | 各不少于 500 题;每月至少更新 | 同时建“应拒答”和“不应拒答”两套,防止过度拒答 |
| 生成内容合格率 | 抽检不少于 1000 条,合格率不低于 90% | 抽检数量尽量多,并记录判定方法 |
| 拒答率 | 应拒答题不低于 95%,非拒答题不高于 5%;各抽检不少于 300 条 | 见拒答率评测 |
统计提醒:1000 条抽检观测到恰好 90.0% 合格,Wilson 95% 区间约为 88.0%–91.7%,下限低于 90%;观测到 92% 时区间约为 90.2%–93.5%。所以自测时应留出余量,不要刚好卡着线,这是我们的换算,不是标准的内容。标准中的“合格”是指样本不包含附录 A 的 31 种安全风险。
企业上线前检查清单
范围与制度
– [ ] 写明服务对象、使用场景和禁用场景,并向使用者说明局限性。
– [ ] 指定负责人与监看人员,设置反馈或投诉渠道。
技术控制
– [ ] 输入检测:关键词加分类模型,对反复违规的账号有暂停规则。
– [ ] 防提示词注入:RAG 与 Agent 按最小权限、只读、人工确认设计。
– [ ] 输出检查:护栏模型或规则,对高风险场景(医疗、金融、心理咨询等)加严。
– [ ] 开放接口时做认证与限流,见本地 API 服务器。
– [ ] 训练与推理环境、测试与生产环境隔离,有备份与恢复策略。
日志与审计
– [ ] 日志字段、保留期限、访问权限和清理机制成文。
– [ ] 定期抽检并留痕;模型或提示更新后重新评估。
数据与隐私
– [ ] 评估是否会把用户输入用于训练;如是,应有授权并提供关闭方式。
– [ ] 数据不出内网的做法见企业私有部署与本地大模型与隐私。
多人共享一台服务器的做法见小团队共享大模型;知识库场景见本地 RAG。
我们怎么核对,没做什么
标准条款、数字与范围来自 GB/T 45654-2025 的正文与附录;护栏模型的描述来自 arXiv 上各论文的摘要;显存与日志容量是我们的公式估算,区间是按标准公式的换算。我们没有对任何护栏模型或软件做实测,不评价任何产品的拦截效果,也没有评估任何企业的合规状态,本文不构成法律意见。
常见问题
企业内部使用大模型,必须符合 GB/T 45654 吗?
这是推荐性标准,重点面向有舆论属性或社会动员能力的服务,用于备案和评估。内部自用是否适用,要看具体情形和相关法规,请咨询法务;但它可以作为参考框架。
护栏模型能保证安全吗?
不能保证。护栏模型是概率性的分类器,会漏判也会误判,要与最小权限、输出校验和人工复核配合。
一定要用护栏模型吗?
不一定。小规模场景可以先用关键词加规则,并保留日志与抽检;风险较高或语言复杂时再引入护栏模型。
日志要保存多久?
保留期限取决于法规和企业制度,我们没有给出统一数字;同时要注意日志本身含敏感信息,应最小化并控制访问。
中文业务该选哪个护栏模型?
要用自己的中文题库实测。Qwen3Guard 的摘要称支持中英文等 119 种语言与方言,但这是作者自报,不能代替你的验证。
怎样做内部验收?
建立“应拒答”和“不应拒答”两套题库、一套安全合格率题库,按固定数量抽检,记录判定方法,并在模型或提示更新后重测。
需要企业内容安全方案?
我们可以帮你梳理使用场景、选型护栏、设计日志与验收流程。请到解决方案咨询页留言,或发邮件到 admin@microaione.com。如果需要上门或远程部署,见远程安装服务。
同专题阅读:越狱防御如何分层工作、Llama Guard 本地护栏教程;全部文章见大模型越狱与安全专题。
参考资料:GB/T 45654-2025《网络安全技术 生成式人工智能服务安全基本要求》;Llama Guard(arXiv)、ShieldGemma(arXiv)、Granite Guardian(arXiv)、Qwen3Guard 技术报告(arXiv)、Meta PurpleLlama(GitHub)、OWASP LLM Top 10、NIST AI RMF。读取日期 2026-11-04。