外接显卡能跑大模型吗?eGPU 给笔记本扩显存的真实效果(雷电与 OCuLink 对比)
笔记本显存小,想跑大一点的模型,很多人会想到外接显卡坞。外接显卡能跑大模型吗? 答案是:能,而且对大模型推理来说,eGPU 的损失比玩游戏小得多,前提是模型能整个放进外接显卡的显存里。这篇文章把原因讲清楚:连接线的带宽到底是多少、模型载入要花多久、什么时候连接线会变成瓶颈,以及 Mac 用户、预算有限的人有哪些更合适的选择。文中所有速度与时间都是按规格和公式换算的理论值,我们没有实测过任何显卡坞。关于笔记本本身的选择,可以先看本地大模型笔记本选购,二手显卡的风险见二手显卡选购指南。
要点速览(更新于 2026-11-04)
- 解码速度由“权重所在内存的带宽”决定。模型全部放在外接显卡的显存里时,每生成一个词几乎不需要经过连接线,速度接近同一张显卡装在台式机里。
连接线影响的主要是模型载入:规格要求雷电 4 至少提供 32Gbps(约 4GB/s)PCIe 数据速率,雷电 3 至少 16Gbps(约 2GB/s);OCuLink 为 PCIe 4.0 x4,理论约 7.9GB/s。
32B Q4_K_M(约 19.6GB)载入的理论时间:雷电 3 约 9.8 秒,雷电 4 约 4.9 秒,OCuLink 约 2.5 秒;实际常被硬盘读速限制。
如果模型放不进显存,eGPU 就帮不上多少忙,这时更应考虑更大显存的显卡。
Apple 芯片的 Mac 官方不支持 eGPU 的图形加速;2026 年有报道称第三方驱动可在 Apple 芯片上做 AI 计算,条件苛刻,我们没有验证。
外接显卡能跑大模型吗:关键看数据走不走连接线
笔记本接 eGPU,数据路径是:笔记本主机 → 连接线(雷电或 OCuLink)→ 显卡坞里的显卡。要判断会不会成为瓶颈,只要问:生成每个词的时候,有多少数据要经过连接线?
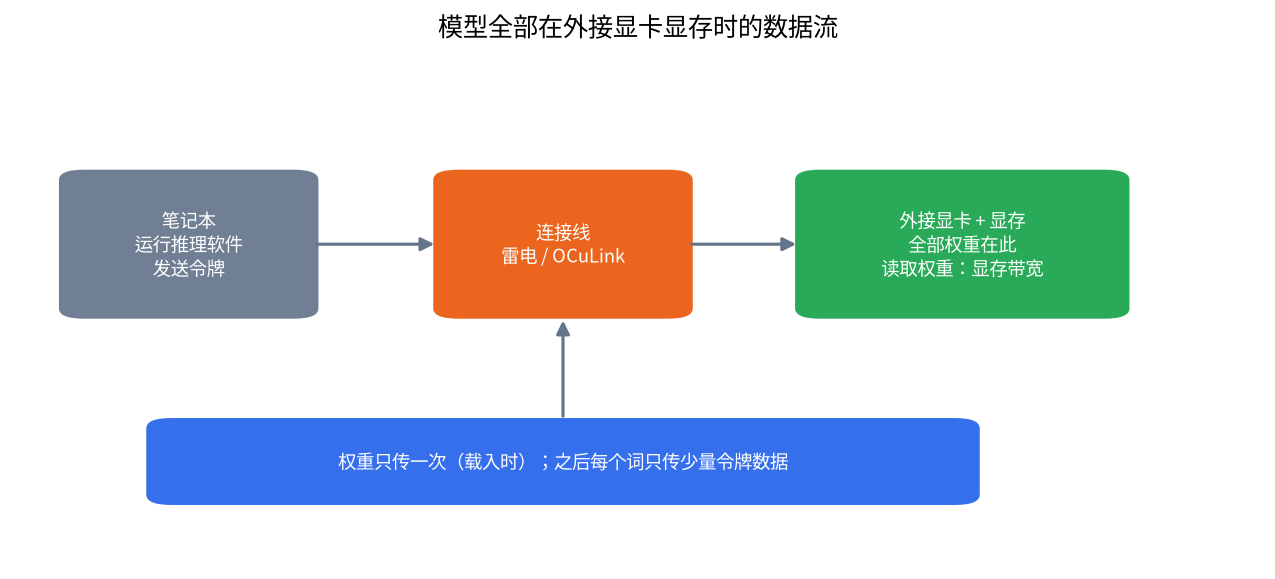
如果模型权重已经全部放在外接显卡的显存里,生成每个词时,权重的读取发生在显卡和它自己的显存之间(例如 RTX 3090 的 936.2GB/s、RTX 3060 12GB 的 360GB/s),连接线只需要传输很少的数据,比如输入的令牌和输出的令牌。这与游戏不同,游戏要持续传输大量纹理、画面数据,所以 eGPU 玩游戏的损失更明显。大模型推理的“重活”留在显卡内部,这是 eGPU 对大模型友好的根本原因。速度上限的算法见大模型为什么需要GPU而不是CPU:上限 ≈ 显存带宽 ÷ 模型大小。
举个算例:8B Q4_K_M 约 4.9GB,放进外接的 RTX 3060 12GB,理论上限约 360 ÷ 4.9 ≈ 73.5 token/s;同一台笔记本如果只用 DDR5 双通道内存(89.6GB/s),上限约 18.3 token/s。差距主要来自显存带宽,而不是连接线。这是公式推算,不是我们的实测。
连接方式的带宽:雷电 3、雷电 4、OCuLink 对比
| 连接方式 | 规格带宽 | 换算(GB/s) | 说明 |
|---|---|---|---|
| 雷电 3 | 链路 40Gbps,规格要求的最低 PCIe 数据速率 16Gbps | 约 2(最低要求) | 不同机型用 2 或 4 条 PCIe 通道,实际可能更高 |
| 雷电 4 | 链路 40Gbps,规格要求最低 PCIe 数据速率 32Gbps | 约 4(最低要求) | Intel 的雷电 4 规格提高了对 PCIe 带宽的最低要求 |
| OCuLink(PCIe 4.0 x4) | 16GT/s × 4 通道,理论约 64Gbps | 约 7.9 | PCI-SIG 规格;无雷电的供电与热插拔,通常需要主板或机身提供接口 |
| 台式机 PCIe 4.0 x16 | 16GT/s × 16 通道 | 约 31.5 | 对照用 |
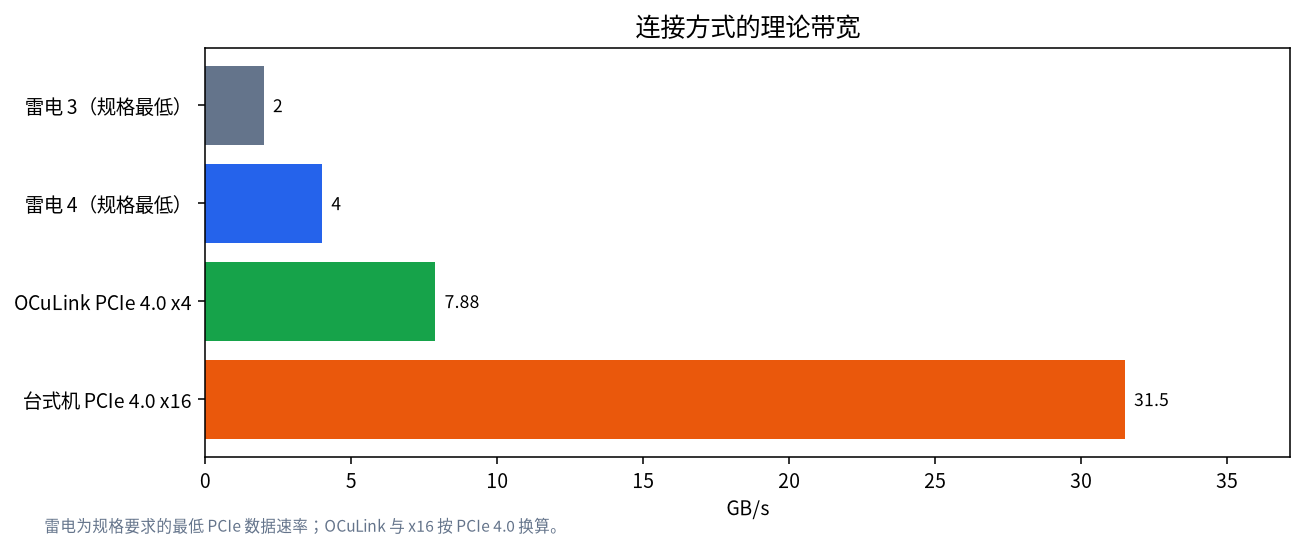
注意:雷电的数字是“规格要求的最低值”,不是上限,我们没有测量具体机型的实际吞吐。另一个差别是:雷电线只有一根,插拔方便,能同时给笔记本充电的坞也有;OCuLink 带宽高,但接口多见于迷你主机和少数机型,需要另外的供电,也不支持热插拔,要在关机状态下连接(不同产品不同,请以产品说明为准)。
模型载入要多久:理论时间对比
载入时间是连接线真正“看得见”的地方。公式:载入秒数 ≈ 模型文件大小 ÷ 连接带宽。以 32B Q4_K_M 约 19.6GB(按 llama.cpp 量化文档的位数换算)为例:
| 连接方式 | 带宽(GB/s) | 理论载入时间 |
|---|---|---|
| 雷电 3(最低要求) | 2 | 约 9.8 秒 |
| 雷电 4(最低要求) | 4 | 约 4.9 秒 |
| OCuLink PCIe 4.0 x4 | 7.88 | 约 2.5 秒 |
| 台式机 PCIe 4.0 x16 | 31.5 | 约 0.6 秒 |
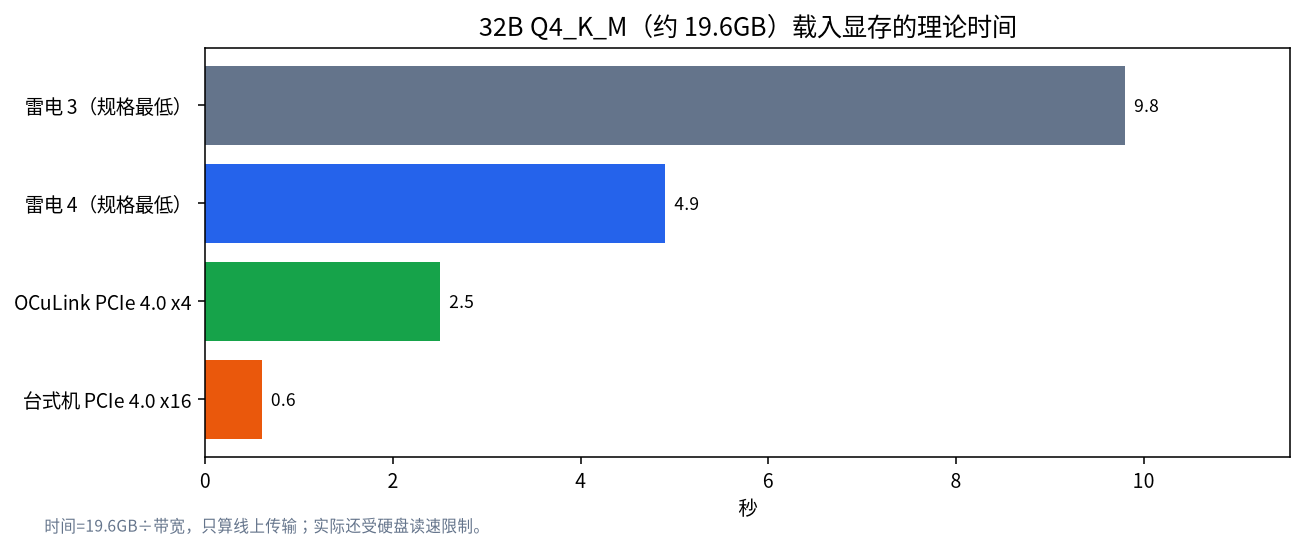
这些数字很短,原因是我们只算了“线上传输”。真实载入还要读硬盘:如果你的固态硬盘实际读速是 3GB/s(这是示例假设),那么无论连接多快,19.6GB 至少要 6.5 秒。所以对大多数用户来说,用雷电 4 的 eGPU 载入一次模型也就十来秒到半分钟,每次切换模型才会感觉到,聊天过程中毫无影响。
什么时候 eGPU 不划算
| 情况 | 为什么不划算 | 更好的做法 |
|---|---|---|
| 模型放不进外接显卡的显存 | 超出的层要放到笔记本内存由 CPU 计算,速度被内存带宽拖慢,eGPU 的优势被抵消(算例见内存与显存卸载) | 买更大显存的卡,或换小一点的模型 |
| 预算只够买一个坞加一张入门卡 | 显卡坞外壳、电源要额外付钱,总价常接近一台小主机 | 对比大内存迷你主机 |
| 机器没有雷电 4、USB4 或 OCuLink 接口 | 没有高速接口就没法用 | 先确认接口再买 |
| 想多卡并联做大模型 | 经连接线做多卡通信会成为瓶颈 | 用台式机主板的 PCIe 插槽 |
| 需要频繁移动 | 坞和显卡体积大、需要外接电源 | 用远程使用方案,见下文 |
显卡坞自带电源的功率要覆盖显卡的整卡功耗再加余量,例如 RTX 3090 整卡 350W。我们没有取得可靠的坞价格,所以不做价格比较,购买前请核对:坞是否支持你的显卡尺寸、供电接口与散热。
买前检查与买后验收
买之前先确认五件事:第一,笔记本有没有雷电 4、USB4 或 OCuLink 接口,并查清楚接口的 PCIe 通道数;第二,显卡坞能不能装下你的显卡(长度、厚度、供电接口);第三,坞的电源功率不低于显卡整卡功耗再加约 100W 的余量;第四,系统是否有对应显卡的驱动,Windows 与 Linux 的情况不同,购买前看产品的兼容列表;第五,模型能否整个放进这张显卡的显存,用显存计算器指南算一遍。
买来之后用三步验收:第一步,用 nvidia-smi 查看显卡是否被识别,并在 nvidia-smi -q 的 PCIe 部分核对当前链路宽度与速率,确认没有降到比预期更低的档位;第二步,载入同一个模型,记录载入时间,与本文的理论时间对比,差距很大时先检查硬盘与线缆;第三步,实际生成一段回答,把速度和“带宽 ÷ 模型大小”算出的上限对比,达到上限的五到七成就算正常,明显低于这个范围,就要检查模型是否部分落到了内存、驱动是否正确。这里的“五到七成”是我们的经验性目标,不是官方指标,也没有在 eGPU 上验证过。
更实际的替代方案
- 台式机或旧主机当“模型服务器”:把显卡放在台式机里,笔记本通过局域网调用它。笔记本不用接线,也能随时用,方法见把本地模型变成 API 服务器。
- 大内存迷你主机或统一内存机器:大模型更看重容量与带宽,统一内存机型是一条路,见大内存迷你主机。
- 直接买带独显的笔记本:显存固定,但稳定、便携,见本地大模型笔记本选购。
- 二手显卡装台式机:同样的钱,显卡装进台式机比装进坞更划算,见二手显卡选购指南。
Mac 能不能用 eGPU 跑大模型
Apple 官方的外接显卡支持文档说明,eGPU 需要搭载 Thunderbolt 3 的 Intel 芯片 Mac;搭载 Apple 芯片的 Mac 使用内置 GPU,不支持 eGPU 的图形加速。2026 年 4 月,AppleInsider 报道称 Apple 签署了 Tiny Corp 的第三方驱动,AMD RDNA3 及以上、NVIDIA Ampere 及以上的显卡可通过 USB4 或雷电的显卡坞在 Apple 芯片的 Mac 上做 AI 计算,但外接显示器画面没有加速,NVIDIA 卡还需要 Docker Desktop,步骤繁琐。这条信息我们没有自己验证,也不清楚 Ollama、LM Studio 等主流工具是否支持。Mac 用户通常更适合直接选统一内存大的机型,见Mac 跑本地大模型。
我们怎么核对,没做什么
雷电 3 与 4 的最低 PCIe 数据速率来自 Thunderbolt 官方资料;OCuLink 为 PCI-SIG 的 PCIe 4.0 规格,带宽按 16GT/s 与 128b/130b 编码换算;显卡带宽来自 NVIDIA 规格;文件大小用 llama.cpp 量化文档的每权重位数(Q4_K_M 约 4.89 位)换算;Mac 部分来自 Apple 支持文档与 AppleInsider 报道。我们没有购买显卡坞,也没有测量任何雷电或 OCuLink 设备的实际速度,所有速度与载入时间均为理论值。
常见问题
外接显卡能跑大模型吗?
能。模型全部放进外接显卡的显存时,生成速度主要由显卡自己的显存带宽决定,连接线主要影响模型载入。放不进显存时,效果会明显变差。
雷电 4 会不会成为瓶颈?
对放进显存的模型,推理时连接线传输的数据很少,通常不是瓶颈。它主要影响载入速度,比如 19.6GB 的模型理论上约需 5 秒。
OCuLink 比雷电好吗?
OCuLink 的带宽更高(PCIe 4.0 x4 约 7.9GB/s),载入更快,但通常需要机器带有 OCuLink 接口和另外的供电,使用也不如雷电方便。
笔记本的核显加外接显卡能一起用吗?
通常推理软件会选择其中一块设备运行模型;把层分给显卡和内存的混合方式会被较慢的部分拖慢,不建议为此买坞。
Mac 可以用 eGPU 跑大模型吗?
官方不支持 Apple 芯片 Mac 用 eGPU 做图形加速。2026 年有第三方驱动用于 AI 计算的报道,条件苛刻,我们没有验证。
预算有限,eGPU 是最划算的吗?
不一定。显卡坞和电源是额外成本,二手显卡装进台式机或迷你主机常常更划算。先确定要跑的模型大小,再决定买什么。
想算一下你的笔记本配什么?
欢迎到社区交流,或发邮件到 admin@microaione.com,告诉我们笔记本型号、接口(雷电 4、USB4、OCuLink)和想跑的模型,我们帮你判断 eGPU 是否值得。
参考资料:Thunderbolt 4 技术说明、PCI-SIG OCuLink 规格、Apple 支持:在 Mac 上使用外接显卡、AppleInsider:Apple 芯片 Mac 上的 eGPU 驱动报道、llama.cpp 量化文档。读取日期 2026-11-04。