腾讯混元 Hy4 发布 48 小时事实核查:哪些说法能核对,哪些只是自报
2026-11-04,腾讯混元团队发布了最新一代大语言模型 Hy4:参数量 770B,据第一财经报道,权重将“近期”开源。新模型一发布,社区里立刻出现各种说法:“最强开源模型”“幻觉率降了六成”“能本地跑了”。这篇文章只做一件事:把腾讯混元 Hy4的公开说法逐条列出来,标明来源,区分“可以核对的”“只是自报的”和“目前还核对不了的”,并估算它如果真的开源,本地运行大概需要多少内存。
核对说明:本文的信息来自第一财经、IT之家、同花顺财经的报道,以及 Hugging Face 上 Hy4-preview(预览版)的模型卡,查阅日期为 2026-11-04。我们没有实测过 Hy4,也没有拿到 Hy4 正式版的权重;文中的内存数字都是按参数量推算的估算值,不是实测。基准分数多为腾讯自报,我们没有独立复现。这类事件会快速变化,请以官方最新页面为准。
要点速览(更新于 2026-11-04)
- 发布:腾讯混元 Hy4,参数量 770B;第一财经报道称,权重将于“近期”开源,目前未见正式版权重。
腾讯自己的说法:Hy4 是“最强的开源模型之一”,但与顶尖闭源模型仍存在较大差距;这是腾讯自述,不是第三方评测。
可以核对的是预览版 Hy4-preview:模型卡写明 770B 总参数、49B 激活参数、1M 上下文、Apache 2.0 许可。
- 本地运行:按 FP8 估算权重约 780GB,按 4-bit 级别估算约 470GB,远超单张 24GB 显卡;这是估算值,没有实测。
腾讯混元 Hy4 发布了什么:先分清“预览版”和“正式版”
读这类新闻,第一步是分清你读到的是哪一个版本。
Hy4-preview(预览版):据其 Hugging Face 模型卡,这是一个混合专家(MoE)模型,总参数 770B,每个 token 激活 49B;骨干 78 层,其中第一层是普通前馈层,其余 77 层是 MoE 层,每层有 256 个路由专家和 1 个共享专家,每个 token 激活其中 8 个路由专家加共享专家;另有 1 个约 10B 参数的 MTP 层,用于推测解码。上下文长度 1M,许可证 Apache 2.0。模型卡还列出了 vLLM 和 SGLang 的部署示例,其中 vLLM 示例使用 --tensor-parallel-size 8。这些内容是模型卡自己写的,能点开页面核对。
Hy4(正式版):2026-11-04 发布。据第一财经报道,参数量 770B,提升了指令遵循、长文理解和长程智能体能力,下一代 Hy5 的参数量规模将进一步扩大。据 IT之家报道,正式版已可在腾讯云和 OpenRouter 使用,价格与预览版相同。但是,正式版的权重、系统卡和技术细节,在我们查阅时还没有看到,报道只说将于近期开源。
所以,目前“能核对”的硬信息,主要还是预览版的模型卡;正式版的大部分信息,是腾讯发布会和媒体转述。
腾讯自己怎么评价 Hy4:自报的部分
据第一财经报道,混元团队称 Hy4 是目前最强的开源模型之一,但与顶尖闭源模型仍存在较大差距。报道还提到,在 ProgramBench、FrontierCode2.0、Agents’ Last Exam v1.1 等多项基准测试中,Hy4 得分超过 DeepSeek-V4.1-Flash-1017,部分得分与 Kimi K3.1 Pro 接近,部分超过 GPT6.1 Sol,但多数基准分数仍低于 GPT6.1 Sol 和 Claude Opus 5.5。
据 IT之家报道,腾讯还给出了几组数字:
- 财经测试:在一个 579 个任务的内部财经测试中,Hy4 得分 3.04,DeepSeek-V4.1-Flash-1017 为 2.97,GLM-5.3 和 Kimi K3.1 Pro 均为 2.68。
- 幻觉率:在腾讯自建测试中,幻觉率从预览版的 15.76% 降到 5.45%(相对下降约 65.4%);“靠猜测导致的错误”从 23.1% 降到 5.6%。
- 游戏开发:相对预览版,GameDev 提升 19.1%,GameLogic 提升 9.8%。
这些数字有一个共同点:测试集、评分方法和打分人,都来自腾讯自己。这不等于数字是假的,但它们是自报,而不是独立复现。更稳妥的读法是:把它当作“腾讯想让你看到的最好角度”,等第三方评测出来后再对照。关于怎么读基准分数,可以看大模型基准怎么看。
预览版那次盲评,也要看清楚范围
预览版模型卡里写到:163 位腾讯内部专家对 203 个工程任务做盲评,Hy4 preview 以 2.99 分略高于 GLM 5.3 的 2.92 分和 Kimi K3 的 2.94 分。注意几点:评审是腾讯内部专家;任务是工程类任务;分差只有零点零几。它说明腾讯内部觉得预览版“不输”,但不能推出“全面更强”。
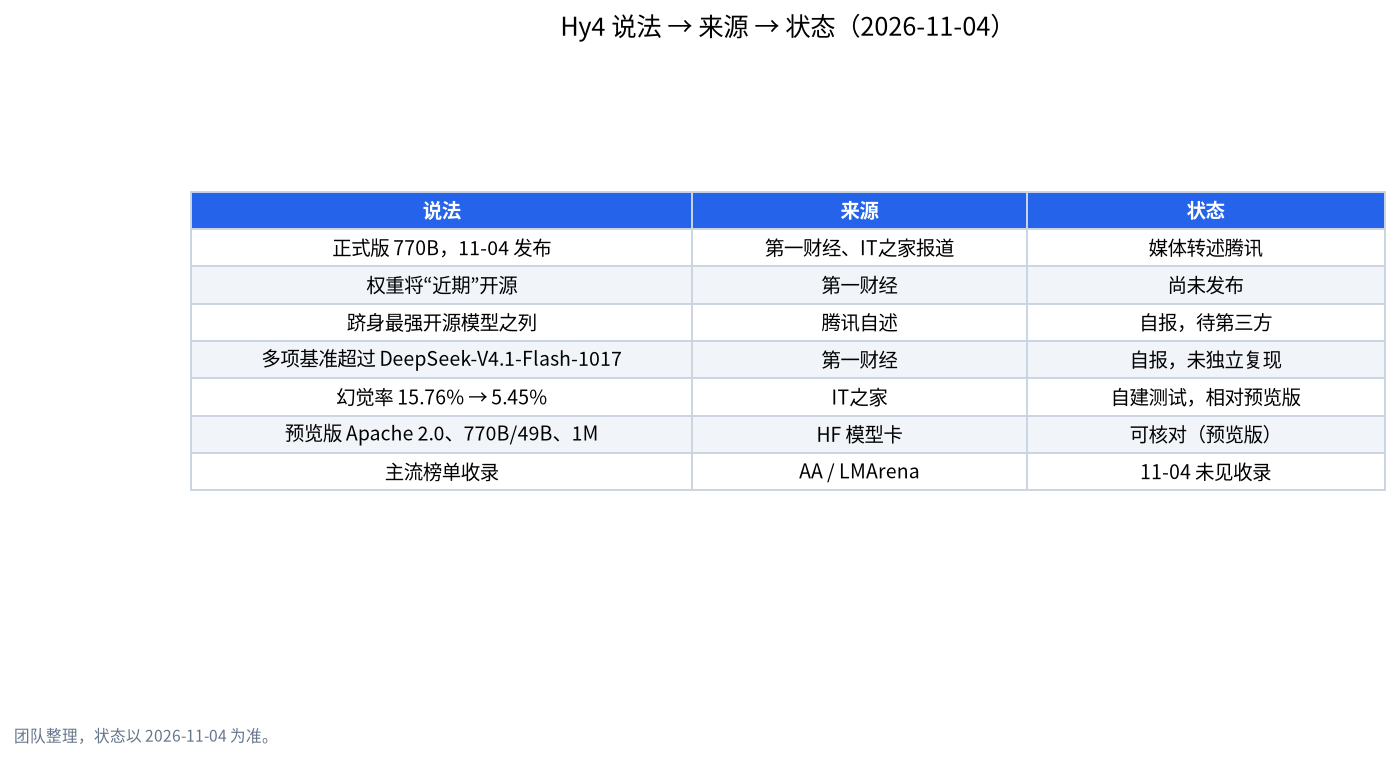
说法、来源、状态:一张表看清
| 说法 | 来源 | 状态(2026-11-04) |
|---|---|---|
| 正式版 770B,11 月 4 日发布 | 第一财经、IT之家报道 | 媒体转述腾讯,未见独立确认 |
| 权重将“近期”开源 | 第一财经 | 尚未发布,没有时间表 |
| 跻身最强开源模型之列 | 腾讯自述 | 自报,待第三方评测 |
| 多项基准超过 DeepSeek-V4.1-Flash-1017 | 第一财经 | 自报,未独立复现 |
| 幻觉率 15.76% → 5.45% | IT之家 | 自建测试,且只是相对预览版 |
| 预览版 Apache 2.0、770B/49B、1M 上下文 | Hugging Face 模型卡 | 可核对(仅预览版) |
| 被主流榜单收录 | Artificial Analysis、LMArena | 2026-11-04 查阅时未见 Hy4 正式版 |
最后一行需要说明:我们查阅 Artificial Analysis 的开放权重页面(2026-11-04)时,没有看到 Hy4 正式版;LMArena 我们手上的快照是 2026-10-27,只有上一代 Hy3(开源许可榜第 14 名、1454 分、Apache 2.0),更早于 Hy4 发布,所以没有 Hy4 数据。这只能说明“发布当天榜单上还没有”,不说明模型好坏,榜单通常会晚几天到几周才收录。
Hy4 本地部署:770B 到底要多少内存
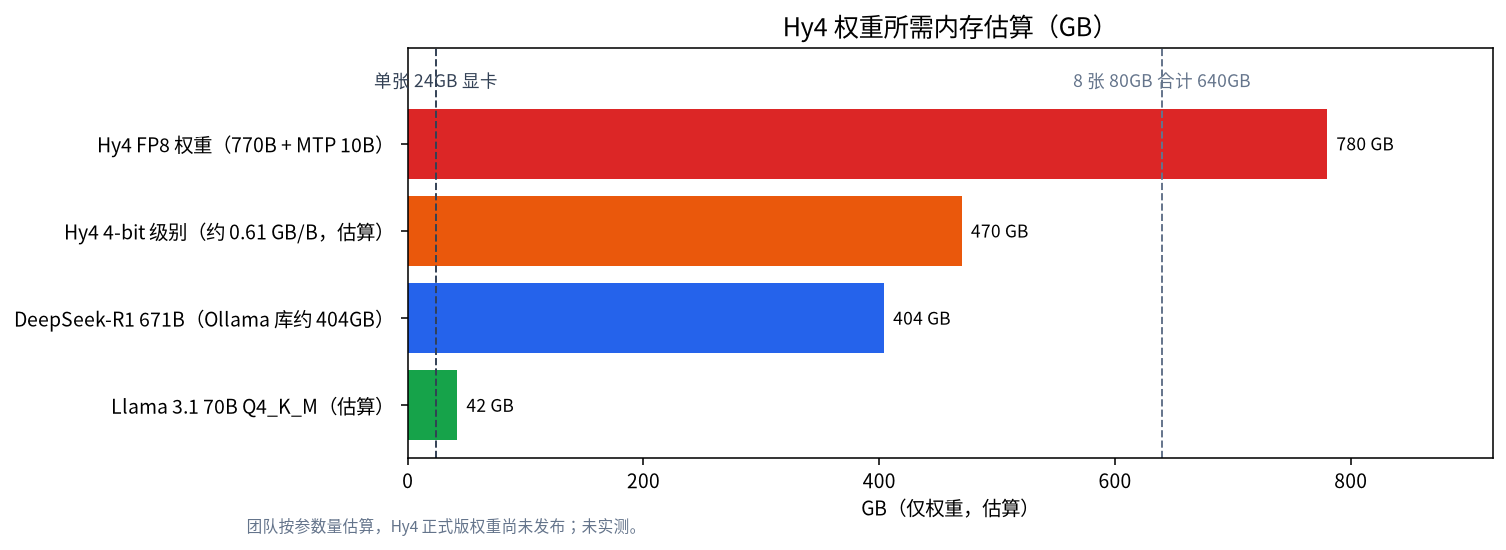
很多人关心的是:权重开源后,能不能在自己的机器上跑?先看一个粗略的推算(估算值,没有实测,正式版权重尚未发布):
- FP8 权重:770B 参数,每个参数约 1 字节,约 770GB,再加 MTP 层约 10GB,合计约 780GB。预览版在 Hugging Face 上就有 FP8 版本。
- 4-bit 级别:按我们此前常用的约 0.61GB/B 估算,770 × 0.61 ≈ 470GB(不含 MTP 层)。
- 对比:DeepSeek-R1 671B 在 Ollama 库里约 404GB;一个 70B 的 Q4_K_M 约 42GB;单张 24GB 显卡只有其中很小一部分。
| 项目 | 估算值 | 依据 |
|---|---|---|
| FP8 权重(含 MTP 层) | 约 780GB | 770B × 1 字节 + 约 10GB |
| 4-bit 级别权重 | 约 470GB | 770B × 约 0.61GB/B |
| 8 张 80GB 显卡合计 | 640GB | 8 × 80GB |
| DeepSeek-R1 671B | 约 404GB | Ollama 库标注 |
| 单张 24GB 显卡 | 24GB | 标称容量 |
几个直接结论:
- 8 张 80GB 显卡合计 640GB,放不下 FP8 的 780GB。预览版模型卡的 vLLM 示例使用张量并行 8,但我们读到的部分没有写明用什么卡;按算术,8 张 80GB 的卡装不下 FP8 权重,更不用说 KV 缓存和开销。
- 4-bit 级别约 470GB 也远超单机消费级配置。按容量算,至少需要约 4 台 128GB 统一内存的机器合计,而跨机器互联的速度我们没有测过,不能下结论。
- MoE 只激活 49B,但全部专家都要放进内存。激活参数少,影响的是速度,不是容量。如果权重全部放在高速内存里,生成速度的理论上限约等于带宽除以每个 token 读取的权重大小:按 4-bit 级别,49B 激活约 30GB,800GB/s 带宽的理论上限约 27 token/秒,400GB/s 约 13 token/秒。这只是理论上限,没有实测,实际会更低。更多关于 MoE 的内存逻辑,见混合专家模型本地运行。
对个人用户,更现实的结论是:Hy4 这个规模更适合企业机房或云 API,而不是家用电脑。预算有限的话,可以参考DeepSeek 本地部署成本里的同量级算法,或者看本地与云端 API 怎么选。想找适合家用的模型,见适合本地运行的大模型推荐。
48 小时核对清单:以后任何新模型都可以照用
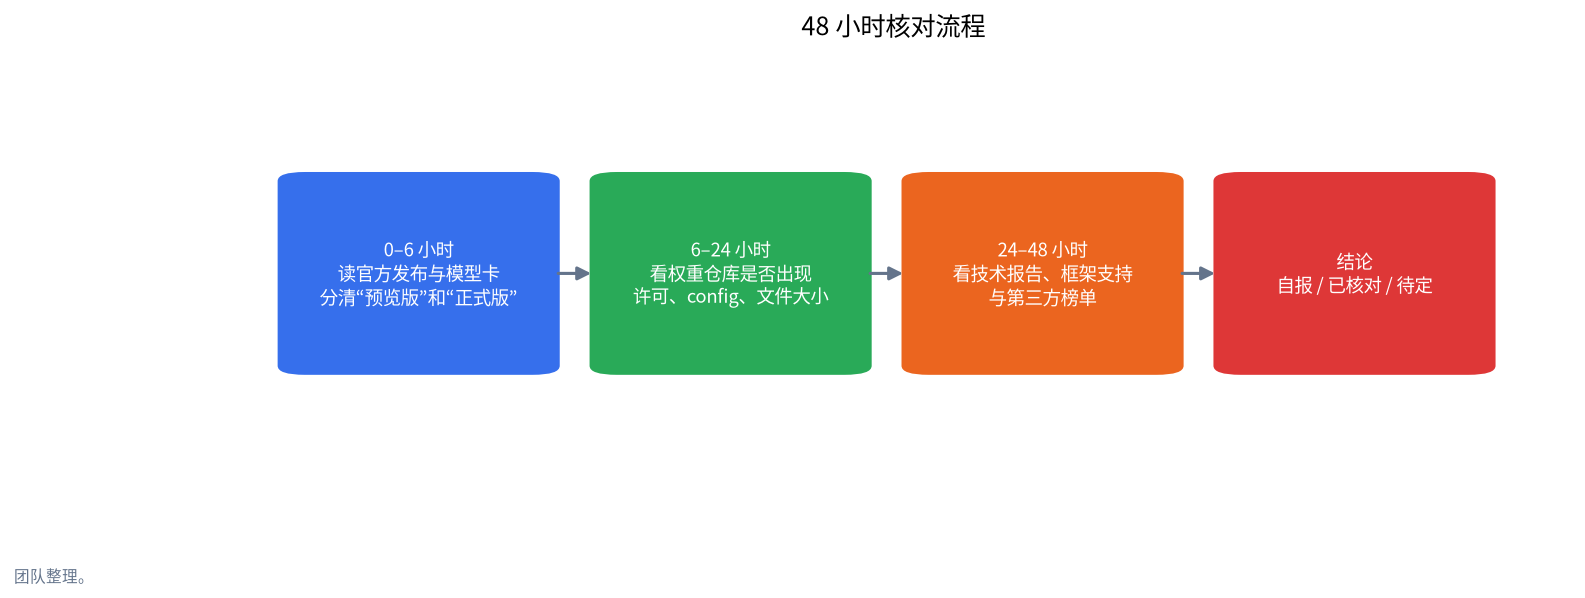
发布后 48 小时是谣言和夸大最多的时候。我们建议按下面的顺序核对,每一步都可以自己动手:
第 0 到 6 小时:读官方原文。 找到官方发布文章和模型卡,分清是“预览版”还是“正式版”,记下每个数字的出处。只在二手转述里出现的数字,标成“待核对”。
第 6 到 24 小时:看权重仓库。 在 Hugging Face、ModelScope 等平台看权重是否真的出现,许可证文件是什么,config.json 里的层数、隐藏维度是否和宣传的参数量对得上,文件总大小是否与参数量、精度对得上。比如 770B 的 FP8 权重,文件总和应在 770GB 左右。
第 24 到 48 小时:看技术报告、框架支持和第三方榜单。 有没有系统卡或技术报告;基准测试的设置(评测框架、采样次数、思考预算)是否写清;vLLM、SGLang 等推理框架是否合并支持;Artificial Analysis、LMArena 等第三方是否收录。第三方收录之前,所有对比分数都标成“自报”。
最后给出结论,只用三种标签:自报、已核对、待定。我们对 Hy4 目前的结论是:发布本身和预览版信息“已核对”;正式版权重“待定”;性能与幻觉率说法“自报”。如果你对某个“泄露”或“破解”类说法也想用同样的方法核对,可以看怎么核对模型泄露与破解说法。
读 Hy4 这类发布时容易犯的错
- 把“预览版”的信息当成“正式版”。 预览版的许可证、结构,不等于正式版。
- 把“自建测试”当作行业标准。 腾讯的 579 个任务财经测试、163 位内部专家盲评,都不是公开可复现的基准。
- 只看相对提升,不看绝对数字。 幻觉率“下降 65.4%”是相对预览版,而且是自建测试,不能理解为“只有 5.45% 的回答会出错”。
- 把“开源”理解成“能在家里跑”。 开源指的是权重公开和许可证允许,不等于你的设备装得下;770B 需要的内存是家用设备的几十倍。
- 提前买硬件。 在正式版权重出现、第三方评测出现之前,不要为 Hy4 采购硬件。
我们核对了什么,没做什么
我们核对了:第一财经、IT之家、同花顺财经的报道原文,Hy4-preview 的模型卡(参数、结构、许可证、盲评数据与部署示例),Artificial Analysis 开放权重页面与 LMArena 的快照。我们没有做:没有实测 Hy4 的任何版本,没有下载权重,没有复现任何基准,没有验证腾讯云或 OpenRouter 的实际价格。所有内存、速度数字都是按参数量和公式推算的估算值。如果后续官方发布了权重或系统卡,我们会更新状态表。
常见问题
腾讯混元 Hy4 是什么时候发布的?
2026-11-04,腾讯混元团队发布了最新一代大语言模型 Hy4,参数量 770B;其预览版 Hy4-preview 此前已在 Hugging Face 上开源。
Hy4 的权重已经开源了吗?
预览版 Hy4-preview 的权重已在 Hugging Face 等平台开源,许可证 Apache 2.0;正式版权重据第一财经报道将于“近期”开源,我们查阅时尚未看到。
Hy4 真的是最强的开源模型吗?
这是腾讯自己的说法,腾讯同时承认与顶尖闭源模型仍有较大差距;我们没有看到独立第三方评测,所以只能标为“自报,待核对”。
幻觉率降了 65.4% 可信吗?
这个数字来自腾讯自建测试,并且是相对预览版的下降,不能理解成绝对错误率;在没有公开可复现的测试集之前,只能作为参考。
个人电脑能本地运行 Hy4 吗?
按我们的估算,770B 的 FP8 权重约 780GB、4-bit 级别约 470GB,远超家用设备;这些是估算值,没有实测,更现实的方式是使用云 API。
发布后多久适合下结论?
至少等权重仓库、系统卡、框架支持和第三方榜单出现之后;在此之前,把所有对比分数标成“自报”更稳妥。
想一起核对?
欢迎到社区交流,或发邮件到 admin@microaione.com,告诉我们你想核对的模型说法和出处。我们的深圳团队会按“自报、已核对、待定”标注结论,并如实说明哪些没有实测。
参考资料:IT之家:腾讯混元 Hy4 发布报道、同花顺财经:Hy4 发布报道、第一财经:腾讯混元团队称 Hy4 跻身最强开源模型队列、Hugging Face:tencent/Hy4-preview 模型卡、Ollama 库:deepseek-r1。