Strataとは?ローカルLLMエンジンが急に話題になった理由とOllamaとの違い
更新日 2026-11-04。 この記事は公開情報を読み解いたものです。私たち自身はStrataをインストールしておらず、ベンチマークも取っていません。
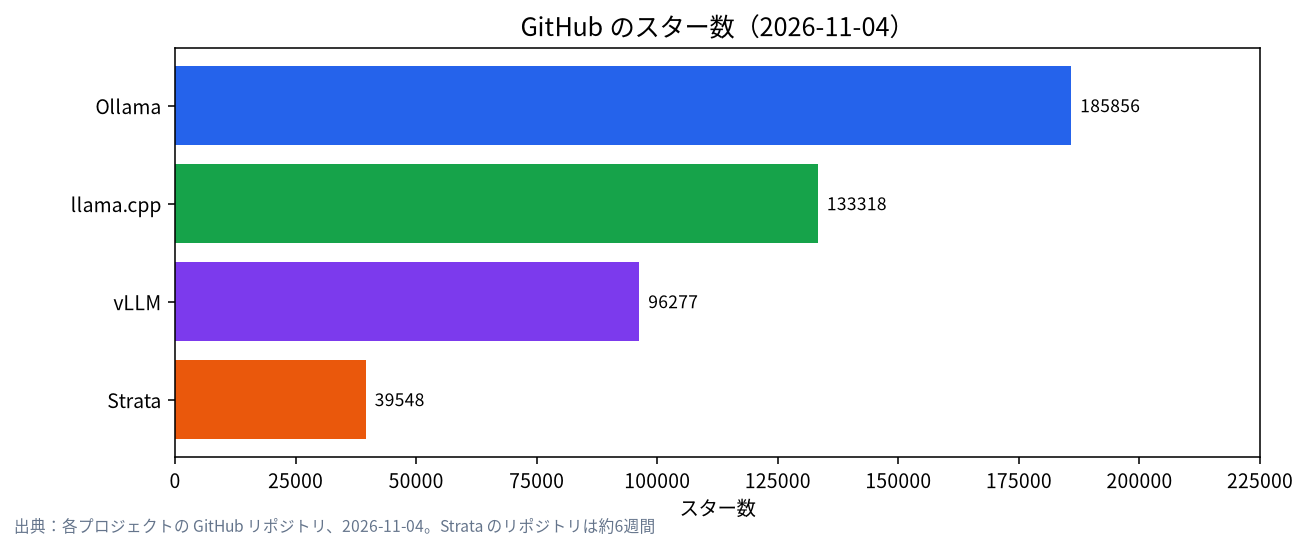
Strataとは、デスクトップアプリとターミナルツールの形で配布されているオープンソースの推論エンジンです。目指していることは一つで、1,250億パラメータのQwen3.8-Flash-Nextのような非常に大きなMoE(Mixture of Experts、混合エキスパート)モデルを、モデルをグラフィックボード、システムRAM、SSDに分けて置くことで、普通のゲーミングPCで動かすことです。リポジトリが作られてから約6週間で、GitHubのスターは約39,500に達し、ローカルLLMのフォーラムではほぼ必ずStrataの話題が出ています。この記事では、Strataとは何か、なぜこれほど速く広まったのか、独立したテスターが何を測ったのか、そして注意点はどこにあるのかを説明します。StrataはOllamaの代わりではなく、隣に置く別の選択肢です。比較はStrataとOllamaの比較記事にまとめました。
Strataとは?ひと言でいうと
StrataはMITライセンスでGitHubに公開されており、リポジトリは主にC++で書かれています。デスクトップアプリ(Windows、Linux AppImage、macOS)として入れることも、strata launchで起動するターミナルツールとして使うこともできます。モデルが動き出すと、OpenAI Chat Completions、Anthropic Messages、Responsesの各APIを自分のマシン上で提供するので、コーディングツールをそのままつなげます。ドキュメントはllama.cppの土台であるテンソルライブラリggmlをサードパーティ部品として挙げていますが、Strataを特徴づけるスケジューリングは独自のものです。
| 項目 | 2026-11-04時点の値 | 出典 |
|---|---|---|
| リポジトリ作成日 | 2026-09-24 | GitHub |
| スター数 / フォーク数 | 39,548 / 4,298 | GitHub |
| 最新リリース | v0.2.10(2026-11-02 UTC) | GitHubリリース |
| エンジンのライセンス | MIT | リポジトリ |
| モデルのライセンス | Qwen3.8-Flash-Nextの重みはQwen Community License 1.0で、MITではありません | プロジェクトの文書 |
| 既定のローカルアドレス | http://127.0.0.1:8080 |
インストールガイド |
| テレメトリ | プロジェクトによれば、なし。アカウントも不要 | 安全に関する文書 |
| 外部のセキュリティ監査 | 同じ文書によれば、まだ受けていない | 安全に関する文書 |
Strataが動かすモデル
MoEモデルには「エキスパート」と呼ばれる専門のサブネットワークが多数あり、1トークンごとにそのうちの数個だけを使います。Qwen3.8-Flash-Nextは総パラメータ数が約1,250億ですが、1トークンあたりに動くのは約60億です(1層あたり512エキスパート、合計24,576、ネイティブのコンテキストは262,144トークン)。1ステップで使う重みは全体の約5%にすぎず、Strataはこの性質を利用しています。
| モデル | 規模 | ドキュメントの記述 |
|---|---|---|
| Qwen3.8-Flash-Next | 総計125B、アクティブ約6B | 4種類の量子化があり、RAMとVRAMの合計で37.6 GB(Q2_0)、39.2 GB(IQ2_XS)、47.0 GB(IQ3_XXS)、54.8 GB(IQ3_S)が必要 |
| Qwen3.6-35B-A3B | 総計35B、アクティブ約3B | Unslothのパッケージで、RAMは32〜52 GB |
| DeepSeek V4.1-Flash | 非常に大きい | ダウンロード239〜274 GB、GPU 12 GB、RAM 46〜64 GB。詳しくは12GB VRAMでDeepSeek V4.1 Flash |
MoEモデルがなぜこうした性質を持つのかは、MoEモデルのローカル実行ガイドを参照してください。
Strataの仕組み:3つの層
Strata公式のHOW_IT_WORKS文書では、3つの層が説明されています。
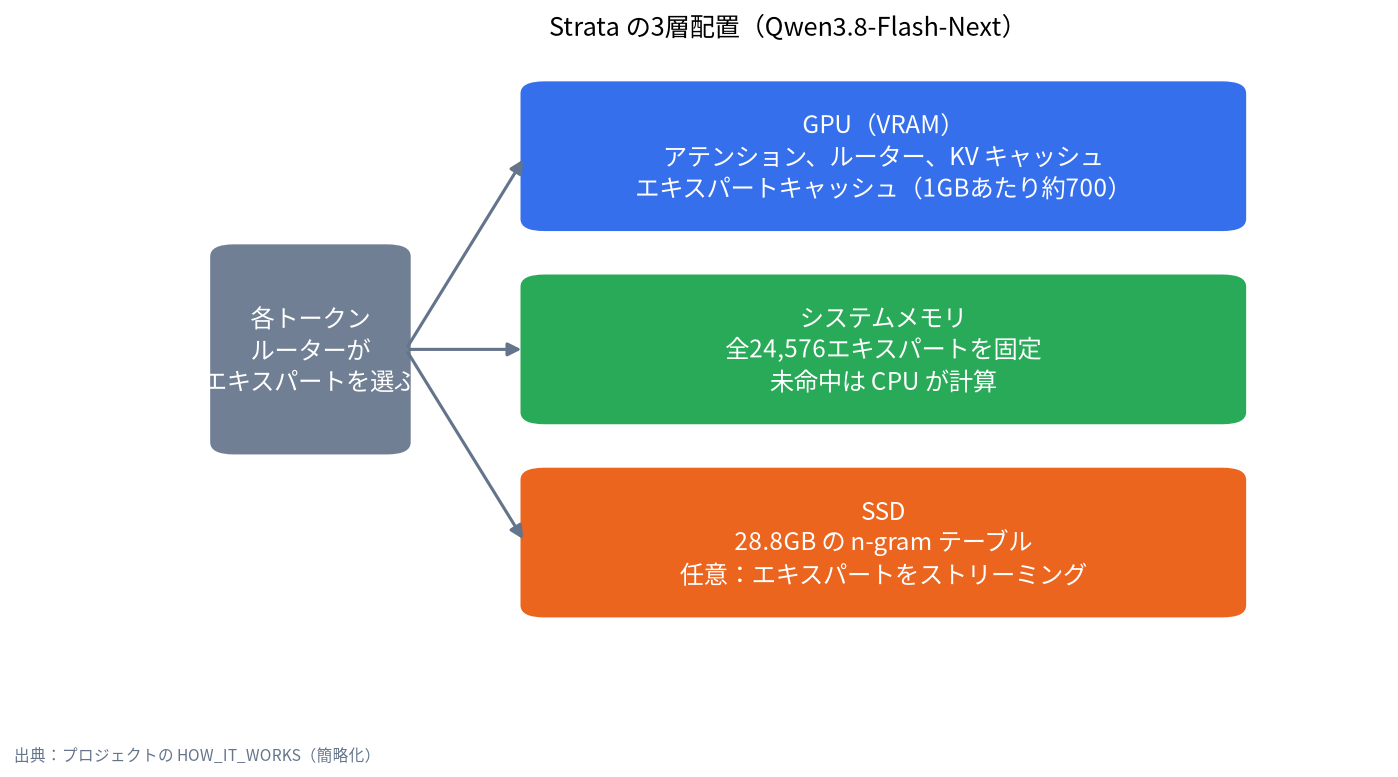
- GPU。 アテンション層、ルーター、共有エキスパート、出力ヘッド、マルチトークン予測(MTP)のドラフト層、KVキャッシュ、そして残りのVRAMを埋めるエキスパートキャッシュを置きます。ドキュメントによれば、VRAMが1 GB増えるごとに約700個のエキスパートを追加で置けます。
- RAM。 24,576個のエキスパートすべてをメモリに固定して置きます。ルーターがVRAMにないエキスパートを選ぶと、カードにコピーせず、CPUがその場で計算します。
- SSD。 28.8 GBのn-gram埋め込み表を置きます。1トークンで読むのはそのうちのごく一部の行だけです。RAMが足りないときは、任意の
--mmap-expertsモードでエキスパートをディスクからストリーミングできますが、動きはするものの、かなり遅くなります。
速度は、トークンが必要とするエキスパートがどれだけGPU上にすでにあるかで決まります。PC WatchのRTX 3060での検証では、IQ2_XSのファイルでカード上に約3,031個のエキスパートがあり、キャッシュヒット率は約72%、IQ3_Sでは約1,104個で56%だったと報告されています。プロジェクトの論文はMTPによる投機的デコードで1.6〜1.8倍の高速化が得られるとしていますが、これは作者自身の数字です。
Strataが話題になった理由
私たちが読んだ資料からは、いくつかの要因が重なったように見えます。
- ワンクリックのインストール。 WindowsのインストーラーとLinuxのAppImage、macOSのディスクイメージに加え、1行のターミナル用インストーラーがあります。お使いのGPU向けエンジンは初回起動時にダウンロードされます。
- 広めやすい見出し。 「12 GBのグラフィックボードで125Bモデル」は共有しやすい言葉です。ただし、大きめの量子化には実際には64 GBのRAMが必要になるという全体像は、見出しには入りません。
- タイミング。 Qwen3.8-Flash-Nextは、10月にすでに多くの人が話題にしていたモデルでした。
- コーディングエージェントへの対応。
strata connectは、Claude Code、Codex CLI、OpenCode、Hermes Agent、OpenClawなどの設定を書き出します。 - 速いリリースペース。 10月25日から11月2日までに6回リリースされました。
- Hacker Newsでの注目。 あるスレッドは私たちが読んだ時点で940ポイント、420コメントに達し、別のスレッドではローカルLLMの議論がStrataのリンクで埋まっているという不満も出ていました。メインのスレッドはこちら。
独立したテスターの報告
以下の数字はどれも私たちが測ったものではありません。ハードウェア、Strataのバージョン、量子化がそれぞれ異なるので、順位表ではなく、おおよその範囲として見てください。
| 出典 | ハードウェア | モデルと量子化 | 報告された結果 |
|---|---|---|---|
| Strataコミュニティベンチマーク(v0.1.41) | RTX 3060 12 GB、DDR4-3200 | Q2_0 / IQ2_XS / IQ3_XXS | 4,096トークンのプロンプトで生成42.9 / 45.5 / 26.2 tok/s |
| PC Watch(v0.1.38) | RTX 3060 12 GB、Core i9-12900、DDR4 64 GB | IQ2_XS、IQ3_S | 34〜44、25〜32 tok/s。5.9kトークンのプロンプトで最初のトークンまで約7秒、23kで約25秒 |
| note.com、usshi_it | RTX 3060 12 GB、Ryzen 5 3600、48 GB | Q2_0 | 生成44.49 tok/s、プリフィル326.68 tok/s、最初のトークンまで1.60秒 |
| Siddhant Dembi | ProxmoxのVM上のRTX 3060、RAM約50 GiB | IQ3_S | 約36〜38 tok/s。無限に考え続けないよう推論予算の設定が必要だった |
| AkitaOnRails | RTX 5090 | IQ3_S | 約159 tok/s、作者自身のコーディングベンチマークで91点 |
| arm1.ru | RTX 5080ノートPC、RAM 30 GB | Flash-Next と、llama.cppのQwen3.8-27B | コーディング品質は同程度。StrataはRAMを約21 GB使い、4〜5 GBがスワップに回り、1.3時間の実行でSSDから約6.9 TBを読み込んだ |
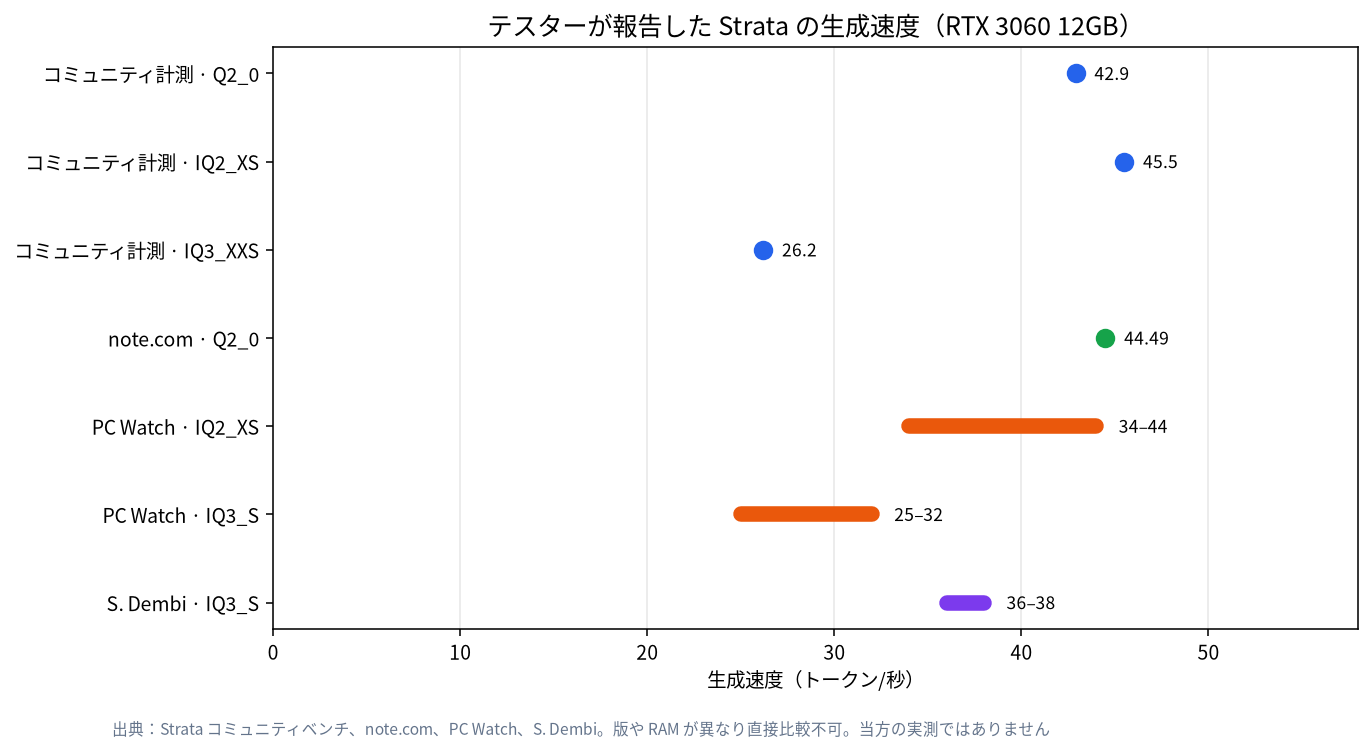
同じRTX 3060でも、量子化、バージョン、メモリによって約20〜45トークン/秒まで幅があります。「Strataはどれくらい速いのか」に一つの答えがないのはそのためです。
注意点と批判
- 2〜3ビットでの品質。 プロジェクトは、IQ3_Sが公開テストで完全なモデルと同等だとしていますが、これは作者の主張です。PC Watchは、IQ2_XSのコード生成がIQ3_Sより一段落ちると指摘しています。Hacker Newsには懐疑的なコメントもあり、同じ重みでllama.cppより誤差が大きかった視覚テストを報告したユーザーもいましたが、私たちは確認できていません。
- 12 GBカードでは長いプロンプトが遅い。 PC Watchは23kトークンのプロンプトで最初のトークンまで約25秒と測っており、ファイル全体を送るコーディングエージェントには厳しい数字です。
- メモリの圧迫。 arm1.ruのテストでは、RAM 30 GBのノートPCが実行中ずっとスワップし、SSDも使われ続けました。
- 若いプロジェクト。 リポジトリはまだ6週間で、リリースは2日おきに出ます。設定や速度はバージョンで変わりますし、Strata自身の文書も外部のセキュリティ監査を受けていないと述べています。
- パイプで実行するインストーラー。 1行のインストーラーは便利ですが、自分のユーザー権限で実行されるスクリプトです。先に中身を読むか、署名付きのアプリのインストーラーを使ってください。
- モデルのライセンス。 エンジンはMITですが、Qwenの重みはQwen Community Licenseです。商用利用の前に確認してください。
- 数字が一致しない箇所。 1,760億パラメータと書く記事もありますが、リポジトリでは125Bなので、ここでは125Bを使います。
StrataとOllamaを並べると
| Strata | Ollama | |
|---|---|---|
| 主な目的 | GPU、RAM、SSDを層に分け、特定の非常に大きなMoEモデルを小さなVRAMで動かす | 汎用のモデル管理ツール。多くの小〜中規模モデルを取得、実行、提供する |
| スター数(2026-11-04) | 39,548 | 185,856 |
| モデル | Qwen3.8-Flash-Next、Qwen3.6-35B-A3B、DeepSeek V4.1-Flash | 大きなライブラリ。ollama.com/libraryを参照 |
| 確認できた最新リリース | v0.2.10(11月2日) | v0.40.14(11月3日) |
| Qwen3.8-Flash-Next | Windows、Linux、macOSで動作 | ライブラリのページにはタグが125b-mlx(105 GB、Apple Silicon向け)の一つだけ。NVIDIA GPU向けのタグは見つからず、テストもしていません |
両者の重なりは、見出しが示すほど大きくありません。多くのモデルを一つのツールで扱いたいなら、今でもOllamaのほうが手軽です。12〜24 GBのカードでこのクラスのモデルを動かしたいなら、Strataがそのために作られています。llama.cppやLM Studioとの完全な比較は比較記事、導入手順はインストールガイド、必要なハードウェアはハードウェア要件の記事にあります。Ollama自体が初めての方は、まずOllamaインストールガイドをどうぞ。
私たちがやったこと、やらなかったこと
2026-11-04に、Strataのリポジトリの文書とリリースノート、Ollamaのリリースノートとライブラリのページ、そして上でリンクした第三者の報告を読みました。Strataはインストールしておらず、重みのダウンロードも、速度の測定もしていません。すべての数字には出典を付けています。
よくある質問(FAQ)
Strataとは、簡単にいうと何ですか?
Strataは無料のプログラムで、いちばん忙しい部分をグラフィックボードに、残りをRAMに、検索用の表をSSDに置くことで、普通のPCでも非常に大きなAIモデルを動かせるようにします。エンジンとチャットアプリであり、モデルそのものではありません。
Strataは無料でオープンソースですか?
エンジンはMITライセンスです。ダウンロードされるモデルには別のライセンスがあり、Qwen3.8-Flash-NextはQwen Community License 1.0です。
本当に12 GBのGPUで125Bモデルが動くのですか?
モデルの総パラメータは1,250億ですが、1トークンで動くのは約60億です。それでもStrataは、モデル用にRAMとVRAMの合計で約38〜55 GB、ディスクで約80 GBを必要とするので、12 GBのカードはGPU側の最低条件にすぎません。
StrataとOllamaを同じPCで使えますか?
使えます。Strataの既定ポートは8080、Ollamaは11434ですが、どちらも同じVRAMとRAMを使いたがるので、大きなモデルは一度に一つにしてください。インストールガイドで説明しています。
Strataのインストールは安全ですか?
プロジェクトはテレメトリもアカウントもなく、サーバーはローカルホストで待ち受けるとしていますが、外部のセキュリティ監査は受けていないとも述べています。まず機密データのないマシンで試し、公式のリポジトリからだけダウンロードしてください。
StrataはOllamaを置き換えますか?
置き換えません。解決する問題が違います。日常のモデルにはOllamaを残し、大きなMoEモデルを一つ動かすときだけStrataを足す人が多いでしょう。
ご相談ください
GPU、RAM、予算についての疑問は、コミュニティに参加するか、admin@microaione.comまでメールをください。一緒に考えます。調整済みのマシンを用意してほしい場合は、マシンとソリューションのガイドをご覧ください。