开源大模型有哪些:是什么、去哪下、和闭源差在哪
「开源大模型有哪些」是本地部署搜索里的高频词。先澄清术语:大模型是什么意思——通常指参数量很大、在海量文本上训练、能做通用语言任务的神经网络;口语里的“开源大模型”常常其实是开放权重(open weights):你可以下载参数用于本地推理,但训练数据与全部代码未必按 OSI 意义完全开源。理解这一点,才能正确阅读许可证,并选择下载网站。
核对说明:家族列表是科普示意,不是「国内开源大模型排名」的官方榜;排行请看评测站并读我们的榜单解读。下载以各平台模型卡为准。
要点速览(更新于 2026-11-05)
- 开源大模型是什么意思:多为开放权重 + 各异许可证,不等于可任意商用。
常见家族:Llama、Qwen、DeepSeek、Mistral、Gemma、ChatGLM 等(示例,会迭代)。
下载网站:Hugging Face、ModelScope、Ollama 库等;先核 LICENSE 与哈希。
- 小模型和大模型的区别:能力、显存、速度与部署成本的权衡,不是道德高低。
开源大模型有哪些:家族示意
开源大模型是什么意思
| 说法 | 常见含义 | 你要多问一句 |
|---|---|---|
| 开放权重 | 可下载参数 | 许可证允许什么用途? |
| 开源(严格) | 代码/数据/权重按开源定义发布 | 三个是否都开放? |
| 可商用 | 许可允许商业 | 是否有用户数/场景限制? |
| 免费下载 | 不收下载费 | 是否收集账号与遥测? |
把“能下到硬盘”写成“完全开源可商用”,是最常见的误解。
开源大模型有哪些(家族示意)
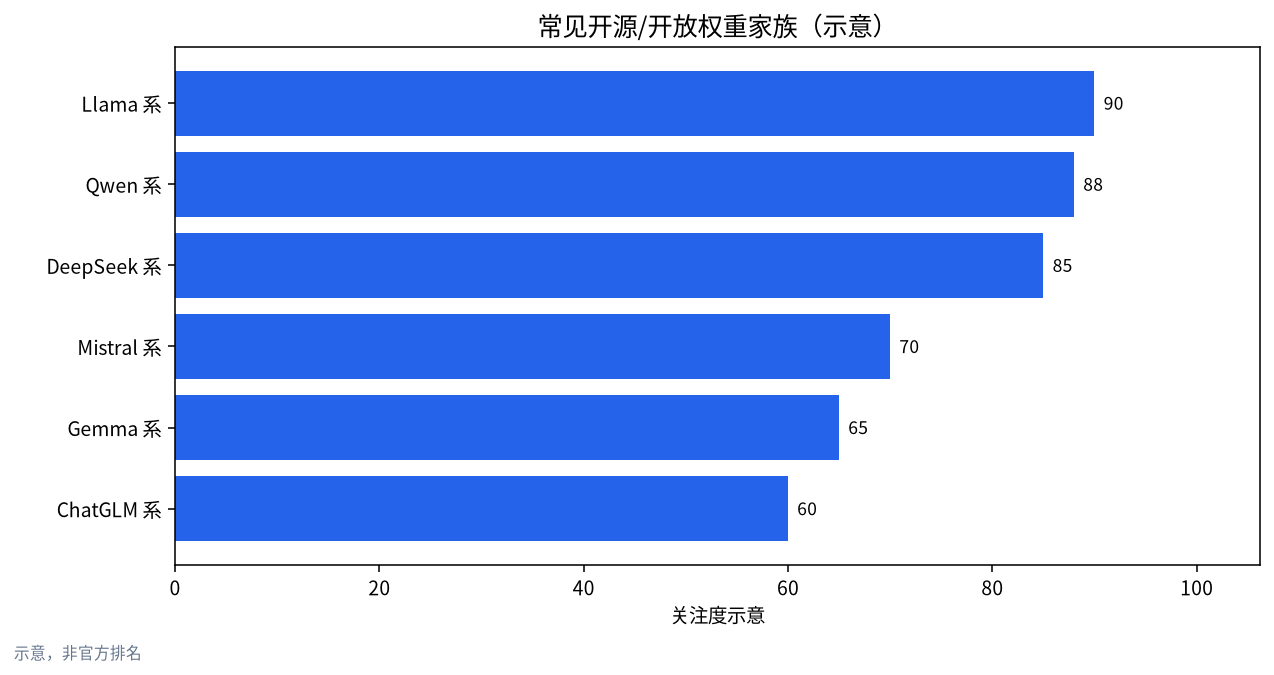
下列是科普向家族,不代表名次:
- Llama 系:生态大,工具适配多。
- Qwen 系:中文场景常见,本站有本地部署与硬件需求。
- DeepSeek 系:推理与代码讨论多,见本地部署与安装。
- Mistral / Gemma / ChatGLM 等:各有许可与尺寸线,部署前读模型卡。
更偏“现在本地好用哪些”的主观清单见最佳本地模型。
小模型和大模型的区别
| 维度 | 小模型(如 1B–8B 量级) | 更大模型(如 70B 量级) |
|---|---|---|
| 显存 | 更容易塞进消费卡 | 常需 24GB+ 或多卡/激进量化 |
| 速度 | 通常更快 | 更慢或需更强硬件 |
| 复杂推理 | 可能较弱 | 通常更强(非绝对) |
| 运维 | 简单 | 权重更大、更新成本高 |
大模型和小模型的区别没有单一分数线;要以你的任务与硬件衡量。个人写作助手常常“小而高量化质量”胜过“大而过度量化”。
开源大模型下载网站
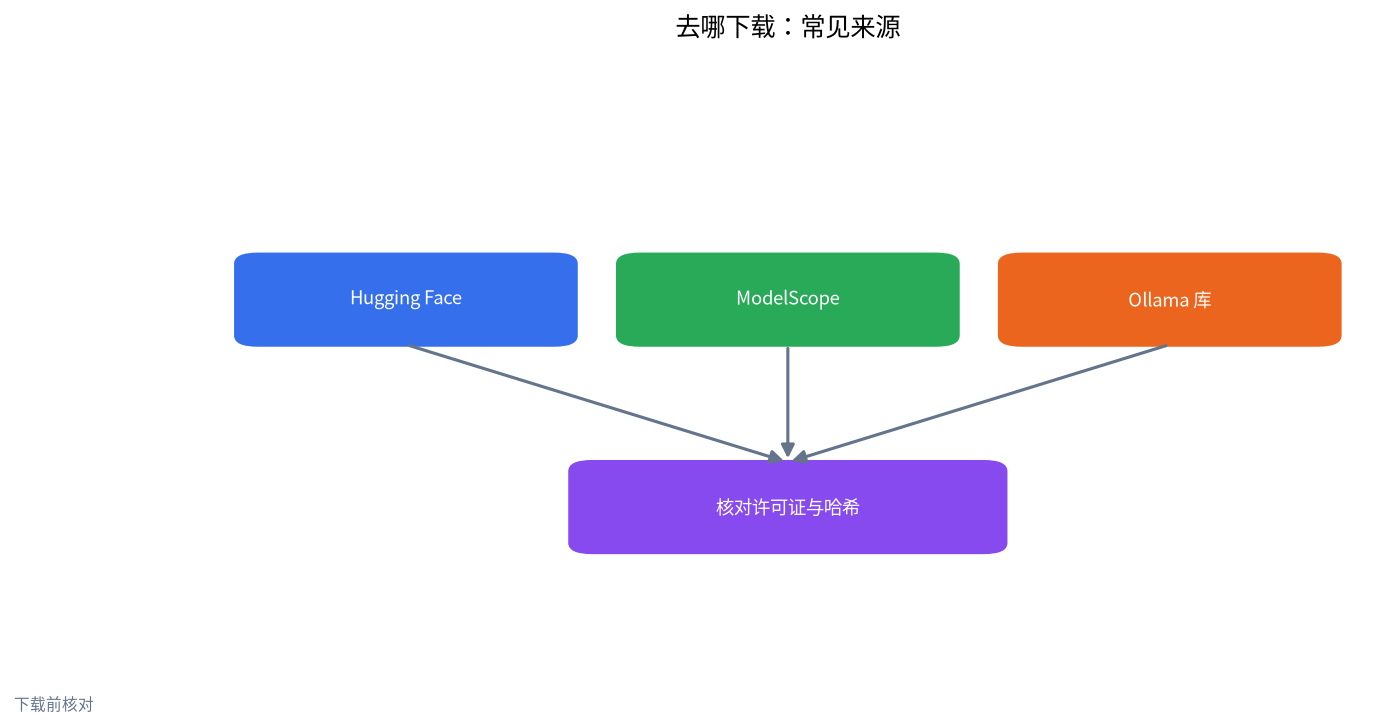
| 来源 | 特点 | 注意 |
|---|---|---|
| Hugging Face Hub | 国际主流模型卡与文件 | 网络与镜像策略因环境而异 |
| ModelScope | 国内访问友好度常更好 | 同样要读许可 |
| Ollama 库 | 一键拉量化包 | 方便但要知道具体量化标签 |
| 项目官网 Release | 官方打包 | 防钓鱼,核校验和 |
下载后核对许可证与哈希;不要随手点来路不明的网盘“全集破解”。
和闭源 API 差在哪
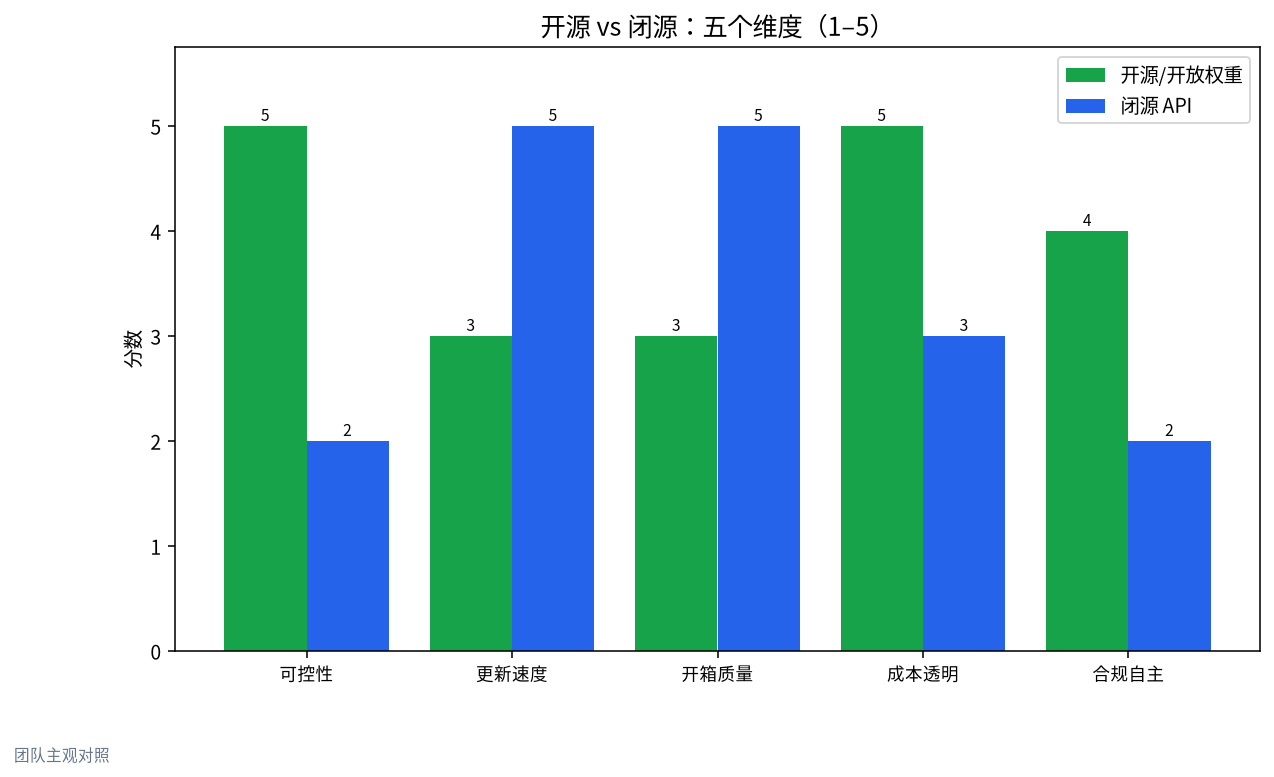
| 维度 | 开源/开放权重本地 | 闭源 API |
|---|---|---|
| 可控性 | 高(权重在你侧) | 低(服务方策略) |
| 更新速度 | 取决于你是否追新 | 厂商持续迭代 |
| 开箱质量 | 参差,需选型 | 通常省心 |
| 成本透明 | 硬件与电费可见 | token 账单可见、长期难料 |
| 合规自主 | 强,但责任也在你 | 依赖厂商条款与地区可用性 |
很多团队最终是混合:敏感数据本地,公开任务走 API。
国内使用的额外提醒
“国内开源大模型排名”会随榜单与版本剧烈变化,不宜把自媒体截图当采购依据。关注:许可证中文摘要是否完整、是否允许商用、是否需备案的上线形态、以及数据是否必须本地。企业落地见企业定制文。
我们怎么核对,没做什么
未发布自家跑分榜;未镜像盗版权重;未宣称某一家族“永久第一”。
场景化补充:把抽象建议落到一周计划
很多读者看完长文仍不知道周一早晨做什么。可以用「三天验证」代替「三个月幻想」:第一天只完成安装与一次成功对话;第二天用自己的十个真实任务压测,记下失败类型;第三天决定是加知识库、换更大模型,还是先改善提示词。这样,硬件预算与训练计划都会附在证据后面,而不是附在焦虑前面。
若三天里反复出现同一类失败——例如表格总是拆坏、引用总是张冠李戴——优先针对失败类型改流程:表格问题可能要改输出约束或后处理;引用问题可能要改切块与检索,而不是立刻下单更贵的显卡。把失败分类写成小表格,本身就是最便宜的评测集雏形。
风险与责任边界(再强调一次)
本地部署降低了数据出域的直觉风险,但不会自动完成合规。员工把客户名单贴进提示词、把未授权代码库喂给微调、或把内网 API 裸露到公网,都是流程问题。建议在项目章程里写清:哪些数据永远禁止进入提示与训练集、谁有权合并适配器、出事时如何停机与追溯。技术教程解决的是“怎么跑”,章程解决的是“能不能跑、出了谁负责”。
对个人爱好者,责任边界可以很轻:不传播他人隐私、不用于违法用途、不把来路不明的权重当可信软件。对企业,边界必须可审计。两者都不要把“开源”误当成“无义务”。
与站内其他文章如何连起来读
若你的卡点是机器买太大或太小,先读预算装机与显存计算;若卡点是知识不更新,先读 RAG;若卡点是语气与格式不稳,再读 LoRA 训练;若卡点是组织权限,读企业私有化与安全清单;若卡点是许可证,读开源与免费边界。按卡点阅读,比按发布时间阅读更省时间。遇到互链,尽量点开对应章节,而不是只收藏标题。
维护清单:上线之后仍要做的小事
模型文件会累积,日志会膨胀,驱动会过时。每月抽出固定时间:删除不再使用的权重、检查磁盘健康、确认备份仍能恢复、浏览一次上游安全通告。若你把本地模型当成“装完即忘的绿色软件”,半年后最常见的结局是:磁盘塞满、某次系统更新后驱动异常,然后误以为“本地 AI 不行了”。维护平凡,但能让前面的选型文章继续值钱。
场景化补充:把抽象建议落到一周计划
很多读者看完长文仍不知道周一早晨做什么。可以用「三天验证」代替「三个月幻想」:第一天只完成安装与一次成功对话;第二天用自己的十个真实任务压测,记下失败类型;第三天决定是加知识库、换更大模型,还是先改善提示词。这样,硬件预算与训练计划都会附在证据后面,而不是附在焦虑前面。
若三天里反复出现同一类失败——例如表格总是拆坏、引用总是张冠李戴——优先针对失败类型改流程:表格问题可能要改输出约束或后处理;引用问题可能要改切块与检索,而不是立刻下单更贵的显卡。把失败分类写成小表格,本身就是最便宜的评测集雏形。
补充核对与阅读建议
为满足完整阅读体验,建议你把本文与显存、装机、私有化相关文章对照着看:先确认自己的任务与显存量级,再决定工具与模型,最后才谈训练或企业治理。把关键提示词、模型文件名与评测结果留在同一笔记里,两周后回看,会比只收藏链接更有用。若你的环境有特殊合规要求,以法务与安全团队意见为准,本文只提供技术向科普。
本地部署的长期价值,往往不在“一次跑通”,而在“可重复、可回滚、可解释”。无论你选免费工具还是企业方案,都把变更记录留下:哪天换了哪个权重、谁批准了适配器合并、哪次评测失败。这些记录会让下一次排障便宜一个数量级。若你仍不确定从哪一步开始,先写清三个真实任务,再回到显存表与配置表做选择题,而不是先下单。
实践备忘(字数补强段)
先把任务写清楚,再买硬件;先把评测集准备好,再谈微调;先把权限与许可证读完,再谈对外演示。按照这个顺序,少走的弯路通常比多买的显存更值钱。把每周一次的冒烟测试坚持下来,本地 AI 才会从“新鲜玩具”变成“稳定工具”。对团队而言,指定一名备份负责人,避免唯一懂行的人休假时服务停摆。
常见问题
开源大模型有哪些?
有多个家族与尺寸线,上表是示意;以模型卡与许可为准。
开源大模型是什么意思?
常指可下载权重的模型,严格开源还涉及代码与数据开放程度。
开源大模型下载网站用哪个?
Hugging Face、ModelScope、Ollama 库都常见;先核许可与完整性。
大模型是什么意思?
通常指大规模预训练的通用语言模型,用于生成与理解文本等任务。
小模型和大模型的区别是什么?
主要是能力、资源占用与成本的权衡,要按任务选。
开源一定比闭源更安全吗?
不一定。本地可控,但配置错误与提示注入仍可能出问题;安全治理不能省。
想讨论某模型是否适合本地?
欢迎到社区留言,或发邮件到 admin@microaione.com,说明显存、语言与是否商用。深圳团队可以帮你对照许可与显存量级。
参考资料:Hugging Face Hub、ModelScope、Ollama 库、本站最佳本地模型、榜单解读。