大模型排行榜前十名怎么看:开源榜 Top 10 与你的显卡能跑哪一个(2026-11 快照)
每次有新模型发布,社交媒体上就会出现“某某登顶榜单”的截图。但如果你想在自己的电脑上跑模型,大模型排行榜前十名其实是一份“看得见、摸不着”的名单:前十名几乎都是几千亿参数的超大混合专家模型,单卡根本装不下。这篇文章给出一份 2026 年 11 月的快照:LMArena 开源许可榜的前十名,加上 Artificial Analysis 的指数,再用公式估算每个模型 Q4 量化后的体积,告诉你前十名里哪些真能在本地跑,以及更适合个人用户的“本地能跑的榜单明星”。
核对说明:LMArena 数据为 2026-10-27 的开源许可榜快照,Artificial Analysis 数据读取于 2026-11-04,榜单随时变化,请当作快照而不是定论。Q4 体积按每十亿参数约 0.61GB 估算,是估算值;我们没有下载或实测这些模型。两个榜单测的东西不同,我们不把分数平均或合并。
要点速览(更新于 2026-11-04)
- LMArena 开源许可榜前十名(2026-10-27 快照):Kimi K3(Max)1488、GLM-5.3(Max)1481、MiMo-V2.6-Pro 1480、GLM-5.3-Flash 1477、DeepSeek-V4.1-Flash-20260910(Max)1476,其后为 GLM-5.2、MiMo-V2.5-Pro、GLM-5.1、DeepSeek-V4-Pro、Kimi K2.6。
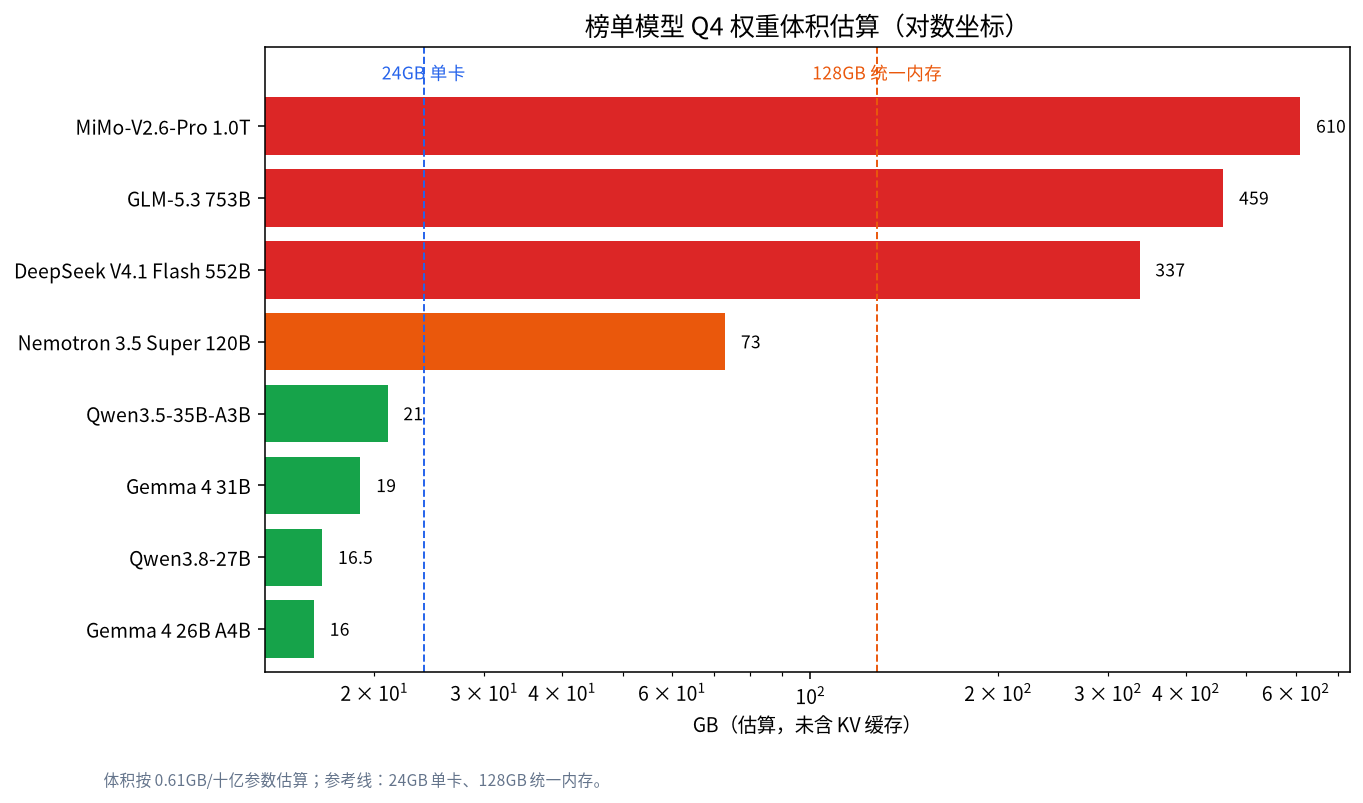
能公开查到总参数的前十名模型都在数百亿到万亿级:例如 DeepSeek V4.1 Flash 为 552B(激活 16B),GLM-5.3 为 753B,MiMo-V2.6-Pro 约 1.0T。Q4 估算分别约 337GB、459GB、610GB,远超单卡或 128GB 桌面机。
本地更现实的是榜单里的中小模型:Gemma 4 31B(Arena 分 1452,Apache 2.0)、Gemma 4 26B A4B(1438)、Qwen3.8-27B(1436,Apache 2.0),Q4 估算约 16 到 19GB,一张 24GB 显卡可以放得下,上下文需留意。
- 两个榜单不能直接平均:LMArena 是人类偏好投票,Artificial Analysis 指数更偏智能体与专业任务。
大模型排行榜前十名:LMArena 开源榜快照
LMArena(现域名 arena.ai)的文本榜允许按许可证筛选,下面是“开源许可”筛选后的前十名。分数是 Elo 式的偏好分,数字之间的差距很小,前几名之间并不存在可以放心下结论的差别。
| 名次 | 模型 | Arena 分 | 备注 |
|---|---|---|---|
| 1 | Kimi K3(Max) | 1488 | 许可证为自定义许可,使用前请阅读条款 |
| 2 | GLM-5.3(Max) | 1481 | AA 页面标注总参数 753B,激活 40B |
| 3 | MiMo-V2.6-Pro | 1480 | AA 页面标注总参数约 1.0T,激活 42B |
| 4 | GLM-5.3-Flash | 1477 | — |
| 5 | DeepSeek-V4.1-Flash-20260910(Max) | 1476 | AA 页面标注总参数 552B,激活 16B |
| 6 | GLM-5.2(Max) | 1475 | — |
| 7 | MiMo-V2.5-Pro | 1467 | — |
| 8 | GLM-5.1 | 1465 | — |
| 9 | DeepSeek-V4-Pro(High,20260813) | 1465 | — |
| 10 | Kimi K2.6 | 1461 | — |
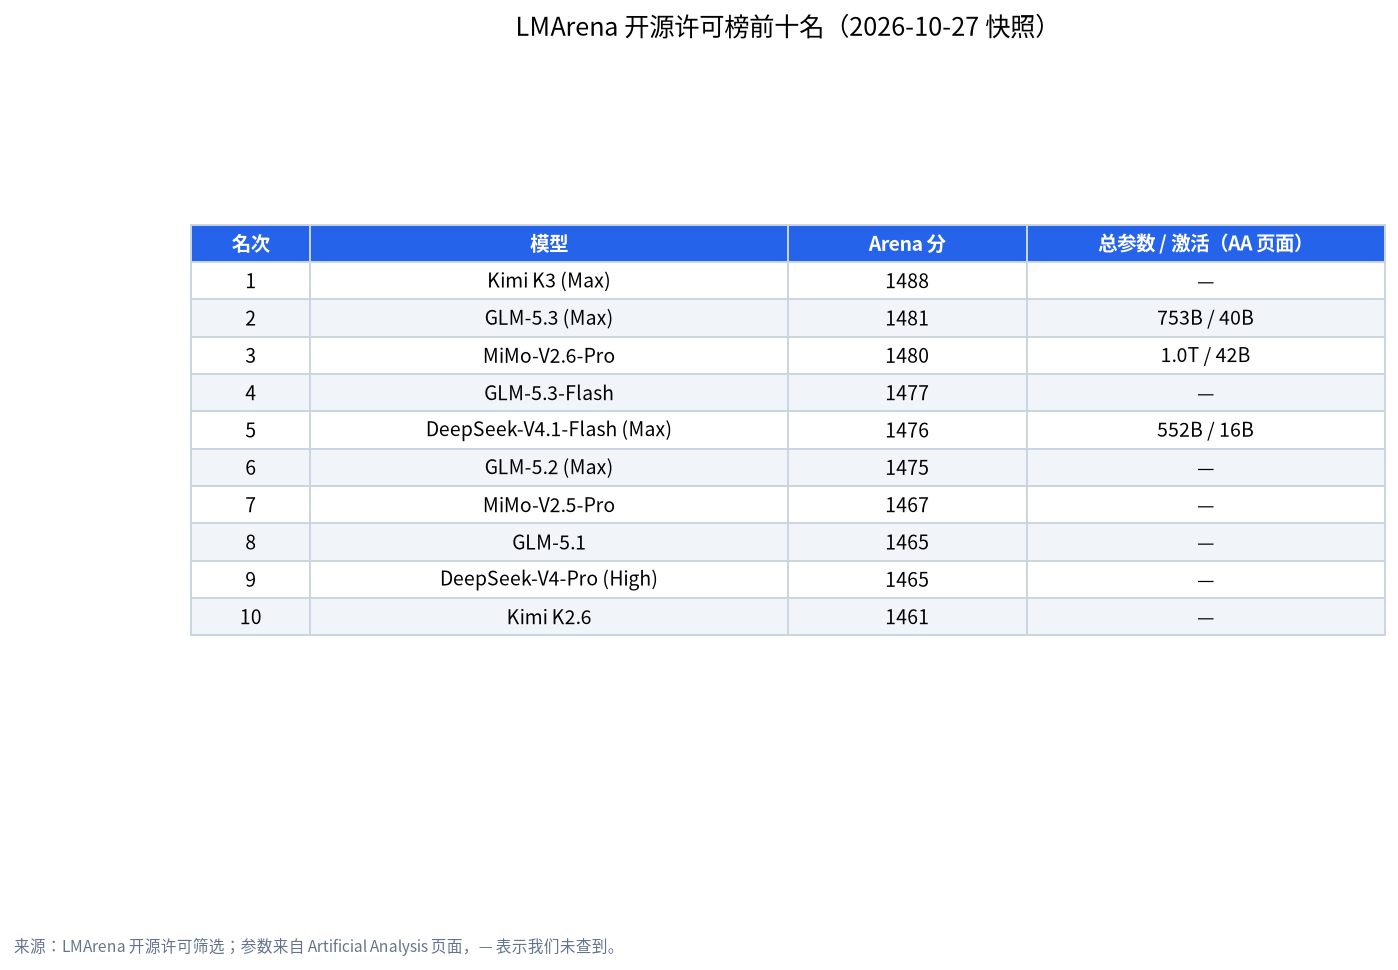
这份名单有两个值得注意的地方:一是前十名只有 4 个系列(Kimi、GLM、MiMo、DeepSeek)。如果你搜的是“国内大模型排行榜前十名”,这四个系列恰好都来自中国团队,不过“国内榜”并没有统一口径,各家榜单筛选条件不同;二是第 1 名与第 10 名的分差只有 27 分,而且榜单还会随新投票变动。把它当作“第一梯队名单”比当作“精确排名”更合适。
第二个榜:Artificial Analysis 指数
Artificial Analysis(AA)的开源模型页面给出的是它自己的智能指数(v5.0.1),由九项评测组成,偏重智能体和专业任务。我们读取到的部分数值如下:
| 模型 | AA 指数 | 备注 |
|---|---|---|
| DeepSeek V4.1 Flash 1017(Max) | 33 | 552B,激活 16B,页面标注约 169 tokens/s(云端) |
| GLM-5.3 | 32 | 753B,激活 40B |
| MiMo-V2.6-Pro | 30 | 约 1.0T,激活 42B |
| Ling 3.1 Flash 1019 | 30 | — |
| MiniMax-M3.1-Flash | 29 | — |
| Step 5 Preview | 29 | — |
| Mistral Large 4 | 26 | 约 1.1T |
| Qwen3.8 27B(Xhigh) | 20 | 27B 稠密,256k 上下文 |
| Nemotron 3.5 Super VL | 14 | — |
对比两个榜可以发现:同一个模型在不同榜单上的相对位置会变。例如 Qwen3.8 27B 在 AA 指数上只有 20 分,但在 LMArena 开源榜上排在前 30 名以内。这不是谁错了,而是它们测的东西不同。顺带一提,Hugging Face 的 Open LLM Leaderboard 已在 2025 年 3 月退役,如果你看到还在引用它的文章,数据已经过时。
前十名里,哪些能在本地跑
决定能不能跑的是权重体积,不是排名。Q4 量化体积的粗略估算是“每十亿参数约 0.61GB”(估算值,实际取决于量化方案),再对照常见设备容量:
| 模型 | 总参数 | Q4 体积估算 | 能在哪里跑 |
|---|---|---|---|
| DeepSeek V4.1 Flash | 552B | 约 337GB | 多卡服务器或超大内存机器;单卡与 128GB 桌面机都不够 |
| GLM-5.3 | 753B | 约 459GB | 同上 |
| MiMo-V2.6-Pro | 约 1.0T | 约 610GB | 同上 |
| Nemotron 3.5 Super VL 120B(预览) | 120B | 约 73GB | 128GB 统一内存级别 |
| gpt-oss-120b | 约 120B | llama.cpp 指南称 128K 上下文约 68.5GB | 128GB 统一内存级别或大显存机器 |
| Gemma 4 31B | 31B | 约 19GB | 24GB 显卡,上下文要留意 |
| Qwen3.8-27B | 27B | 约 16.5GB | 24GB 显卡 |
| Gemma 4 26B A4B | 26B(激活约 4B) | 约 16GB | 24GB 显卡,混合专家速度更友好 |
| Qwen3.5-35B-A3B | 35B(激活约 3B) | 约 21GB | 24GB 显卡较紧,宜短上下文 |
说明:表中本地可跑的模型来自 LMArena 开源榜的中下游名次:Gemma 4 31B(1452 分)、Gemma 4 26B A4B(1438)、Qwen3.8-27B(1436)、Qwen3.5-27B(1409)、Qwen3.5-35B-A3B(1394)、gpt-oss-120b(1352)、gpt-oss-20b(1317,llama.cpp 指南称 128K 上下文约 17.9GB)。你的显存够不够,建议先用显存计算器和模型大小选择器核对,混合专家模型的特点见MoE 模型本地部署。
算一个例子:我只有一张 24GB 显卡
假设你有一张 24GB 的显卡,想看看榜单里的 Gemma 4 31B 放不放得下。步骤是:
- 可用显存约为标称的 0.92 到 0.95 倍,24GB 约为 22.1 到 22.8GB(经验范围,不同系统有差异)。
- Gemma 4 31B 的 Q4 体积估算为 31 × 0.61 ≈ 18.9GB。
- 运行时开销按 1 到 2GB 估算,剩下留给 KV 缓存的显存大约是 22.1 − 18.9 − 2 ≈ 1.2GB 到 22.8 − 18.9 − 1 ≈ 2.9GB。
- 能支持多长的上下文,取决于该模型的层数、KV 头数和缓存精度,需要用显存计算器按模型结构代入;结论是“放得下,但上下文余量很紧”。
同样的算法套在 Qwen3.8-27B 上:27 × 0.61 ≈ 16.5GB,余量约 3.6GB 到 5.3GB,更宽裕;Gemma 4 26B A4B 约 15.9GB,余量更多。榜单分数差几十分,换来的是显存余量的明显差别,这就是为什么我们建议把“能装下并留有余量”放在“榜单名次”前面。
榜单上的速度列:别当成本地速度
AA 页面给出的 tokens/s(例如 DeepSeek V4.1 Flash 1017 约 169 tokens/s)是服务端接口的输出速度,反映的是云端部署和硬件,不是你的显卡上的速度。本地速度的粗略上限仍然用“带宽 ÷ 模型体积”估算,可以参考为什么跑大模型要 GPU。混合专家模型每个 token 只读取激活参数,所以同样体积下往往更快,但它仍然需要把全部权重放进内存或显存。
三种常见读者,该怎么用这份榜单
个人玩家,一张 12GB 到 24GB 的显卡。 不要被前十名吸引,直接在 27B 到 35B 以内的区间找“名次靠前又放得下”的模型。先确定显存,再看名次;如果显存只有 12GB,8B 到 14B 级别的模型在你的设备上更流畅,榜单上的名次差异远没有“能不能完整放进显存”重要。
小团队,想搭一台共享的内部服务。 你更关心的是并发和稳定性,而不是单次对话的偏好分。可以先看小团队共享本地大模型,再用榜单挑 2 到 3 个候选,用你们自己的真实问题做盲测。
企业,想用榜单前十名的完整版。 需要多卡服务器,硬件成本很高,而且要把许可证、运维和安全一起算进去,可参考企业私有化部署。如果只是偶尔用,租用云端算力或直接调用接口往往更划算,成本比较见云端 API 与本地部署对比。
怎么长期跟踪榜单,而不是靠截图
- 记录日期:每次引用榜单分数都写上快照日期,就像本文的 2026-10-27 与 2026-11-04。
- 看筛选条件:LMArena 页面可以按许可证、风格控制等条件筛选,不同筛选下的名次不同,引用时要写明。
- 看置信区间:Arena 页面会给出分数的不确定范围,名次相邻的模型之间往往无法区分。
- 交叉验证:同一个模型在两个榜单上都靠前,才更值得花时间下载测试。
- 建立自己的小测试集:准备 20 到 30 个你真实会问的问题,换模型时重新跑一遍,比任何榜单都更贴近你的需求。
怎么读榜:四步法
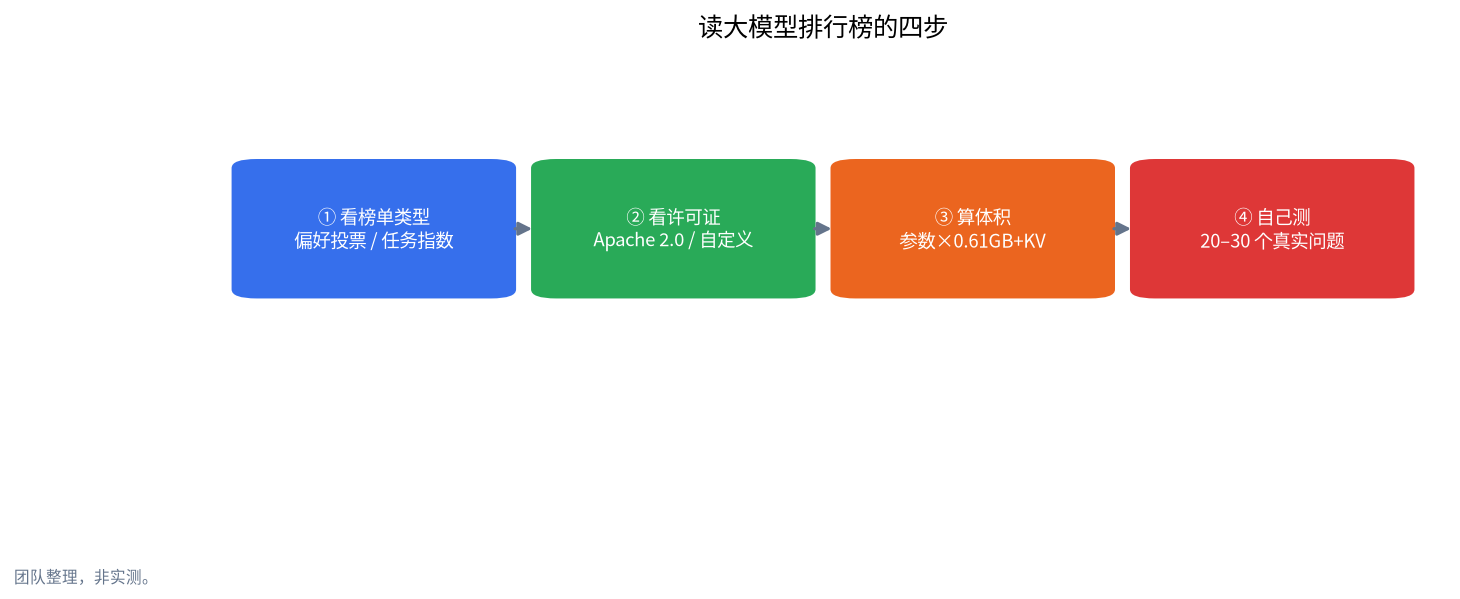
- 先看榜单测什么:LMArena 是用户盲测偏好,AA 指数偏任务与智能体,其他榜单还可能是单项基准。方法细节见如何读懂大模型评测。
- 再看许可证:开放权重不等于随便商用。比如 Kimi K3 在榜单页被标注为自定义许可,使用前需要阅读条款;Gemma 4 31B 与 Qwen3.8-27B 标注为 Apache 2.0。合规判断请交给法务。
- 算体积:用“参数 × 0.61GB/十亿”估算 Q4 大小,再加 KV 缓存和 1 到 2GB 开销,对照你的设备。
- 用自己的任务测:榜单分数差几十分,在你的业务问题上可能毫无区别。
如果要按预算选:我们的建议
| 你的设备 | 更现实的选择 | 参考 |
|---|---|---|
| 12GB 到 16GB 显存 | 8B 到 14B 级别模型 | 12GB、16GB 显存指南 |
| 24GB 显存(3090/4090) | 26B 到 35B 的 Q4 模型 | RTX 4090 最大能跑多大模型 |
| 128GB 统一内存 | 约 120B 的 Q4 模型 | 大内存迷你主机 |
| 想跑榜单前十名的完整版 | 多卡服务器,成本很高 | DeepSeek 本地部署成本 |
更多“适合本地的模型”可以看2026 本地模型推荐。
常见误区与避坑
- 把“榜单第一”当作“适合我”:第一名往往是几千亿参数的模型,本地装不下。
- 把两个榜单的分数相加或平均:量纲不同,没有意义。
- 只看 Arena 分差:几十分的差距在统计上和业务上都可能不重要。
- 忽略许可证:榜单上的“开源”分很多种,商用前必须读条款。
- 拿榜单快照当长期结论:新模型发布后名次会变,我们的快照日期是 2026-10-27(LMArena)和 2026-11-04(AA)。
- 忽略量化损失:Q4 会带来质量损失,榜单分数通常对应的是原始或较高精度版本。
我们怎么核对,没做什么
LMArena 与 AA 的数值来自两个榜单页面的公开显示,我们不对其评测方法负责;参数量来自 AA 页面标注;Q4 体积用每十亿参数 0.61GB 估算,gpt-oss 的体积来自 llama.cpp 指南。我们没有下载或实测这些模型,也没有核对每个模型的许可证全文,只转述榜单页面显示的许可类别。
常见问题
国内大模型排行榜前十名怎么看?和本地能跑的模型有什么关系?
目前 AI 大模型排行榜前十名、最新国内 AI 大模型排名前十名,多来自在线评测榜,和「你的显卡能跑谁」不是同一件事。选本地模型时,把榜单名次和显存/量化可行性一起看,见正文本地适配表。
现在大模型排行榜前十名是哪些模型?
按 LMArena 开源许可榜 2026-10-27 的快照:Kimi K3(Max)、GLM-5.3(Max)、MiMo-V2.6-Pro、GLM-5.3-Flash、DeepSeek-V4.1-Flash(Max)、GLM-5.2、MiMo-V2.5-Pro、GLM-5.1、DeepSeek-V4-Pro、Kimi K2.6。榜单会变动。
排行榜前十名的模型能在本地跑吗?
多数不能。已知总参数的前十名模型都在数百亿到万亿级,Q4 估算体积是数百 GB,需要多卡服务器。个人电脑更适合榜单里的 27B 到 35B 级别模型。
LMArena 和 Artificial Analysis 哪个更可信?
它们测的东西不同:前者是人类偏好投票,后者是任务型指数。建议两个都看,再用自己的任务测,不要平均分数。
24GB 显卡能跑榜单里的哪些模型?
按 Q4 估算,Gemma 4 31B、Qwen3.8-27B、Gemma 4 26B A4B 约 16 到 19GB,可以放入,Qwen3.5-35B-A3B 约 21GB 较紧。
开源榜的模型可以直接商用吗?
不一定。榜单页面会标注许可类别,有的是 Apache 2.0,有的是自定义许可,商用前请阅读条款并咨询法务。
排名会变吗?
会。榜单随投票与新模型更新,本文只是快照。
想知道你的设备适合哪个模型?
欢迎到社区交流,或发邮件到 admin@microaione.com,告诉我们显存、内存和用途。我们的深圳团队可以帮你选型配置,也会如实说明哪些结论只是估算。
参考资料:LMArena 文本榜(开源许可筛选)、Artificial Analysis:开源模型、llama.cpp:gpt-oss 指南、Hugging Face:Open LLM Leaderboard(已退役)。