¿Qué es Strata? Por qué este motor de LLM local se hizo viral y en qué se diferencia de Ollama
Actualizado 2026-11-04. Este artículo es una lectura de fuentes públicas. No hemos instalado Strata ni ejecutado ningún benchmark nosotros mismos.
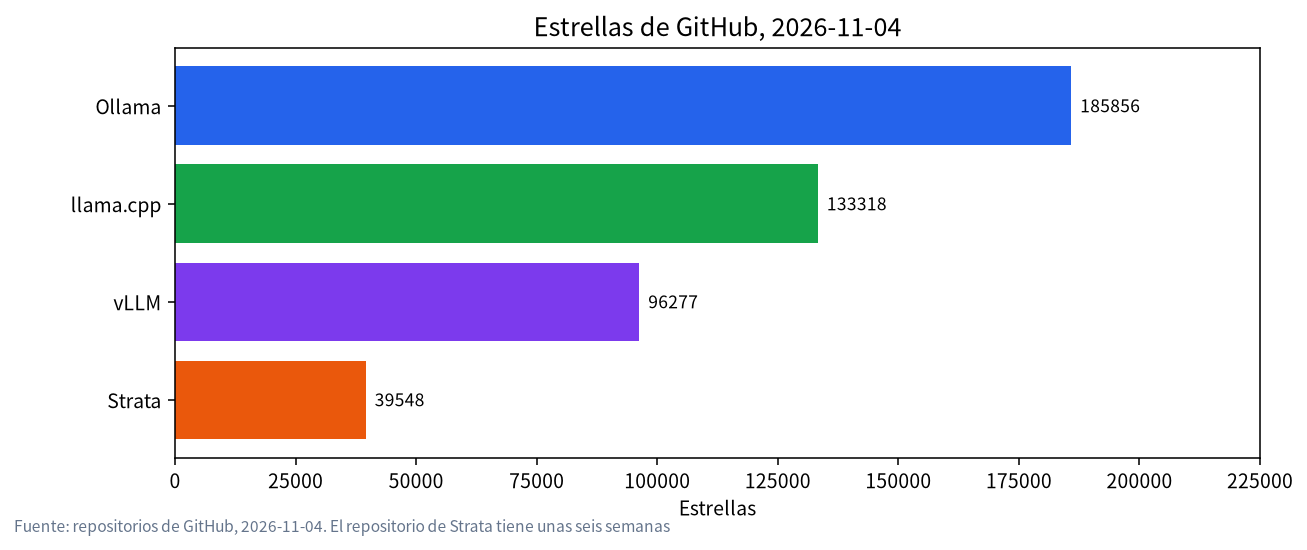
¿Qué es Strata? Es un motor de inferencia de código abierto, distribuido como aplicación de escritorio y herramienta de terminal, construido sobre una idea: ejecutar un modelo de mezcla de expertos (MoE) muy grande, como Qwen3.8-Flash-Next con 125.000 millones de parámetros, en un PC de juegos normal repartiendo el modelo entre la tarjeta gráfica, la RAM del sistema y el SSD. Unas seis semanas después de crearse el repositorio tiene cerca de 39.500 estrellas en GitHub y casi todos los foros de LLM locales tienen un hilo sobre él. Aquí explicamos qué es Strata, por qué se difundió tan rápido, qué midieron probadores independientes y dónde están las reservas. Se coloca junto a Ollama, no lo sustituye, y la comparación está en nuestro artículo Strata vs Ollama.
Qué es Strata, en un párrafo
Strata está publicado en GitHub con licencia MIT, y el repositorio está escrito sobre todo en C++. Se instala como aplicación de escritorio (Windows, AppImage de Linux, macOS) o como herramienta de terminal que se inicia con strata launch. Cuando hay un modelo en marcha, ofrece en tu propio equipo una API OpenAI Chat Completions, una API Anthropic Messages y una API Responses, de modo que las herramientas de programación pueden conectarse. La documentación cita ggml, la biblioteca de tensores de llama.cpp, como componente de terceros, pero la planificación que diferencia a Strata es propia.
| Elemento | Valor el 2026-11-04 | Origen |
|---|---|---|
| Repositorio creado | 2026-09-24 | GitHub |
| Estrellas / forks | 39.548 / 4.298 | GitHub |
| Última versión | v0.2.10 (2 nov 2026, UTC) | Releases de GitHub |
| Licencia del motor | MIT | Repositorio |
| Licencia del modelo | Los pesos de Qwen3.8-Flash-Next usan la Qwen Community License 1.0, no MIT | Documentación del proyecto |
| Dirección local por defecto | http://127.0.0.1:8080 |
Guía de instalación |
| Telemetría | Ninguna y sin cuenta, según el proyecto | Documento de seguridad |
| Auditoría de seguridad externa | Todavía no, según el mismo documento | Documento de seguridad |
Los modelos que ejecuta Strata
Un modelo de mezcla de expertos tiene muchas subredes especializadas («expertos») y usa solo unas pocas por token. Qwen3.8-Flash-Next tiene unos 125.000 millones de parámetros en total, pero unos 6.000 millones activos por token (512 expertos por capa, 24.576 en total y un contexto nativo de 262.144 tokens). Esa proporción, cerca del 5 % de los pesos por token, es lo que aprovecha Strata.
| Modelo | Tamaño | Qué dice la documentación |
|---|---|---|
| Qwen3.8-Flash-Next | 125B en total, ~6B activos | Cuatro cuantizaciones que necesitan 37,6 GB (Q2_0), 39,2 GB (IQ2_XS), 47,0 GB (IQ3_XXS) o 54,8 GB (IQ3_S) de RAM más VRAM |
| Qwen3.6-35B-A3B | 35B en total, ~3B activos | Paquetes de Unsloth, de 32 a 52 GB de RAM |
| DeepSeek V4.1-Flash | Muy grande | Descarga de 239 a 274 GB, GPU de 12 GB, de 46 a 64 GB de RAM; véase nuestro artículo sobre DeepSeek V4.1 Flash en 12 GB |
Para entender por qué los modelos MoE se comportan así, consulta nuestra guía de modelos MoE.
Cómo funciona Strata: tres niveles
El propio documento HOW_IT_WORKS de Strata describe tres niveles.
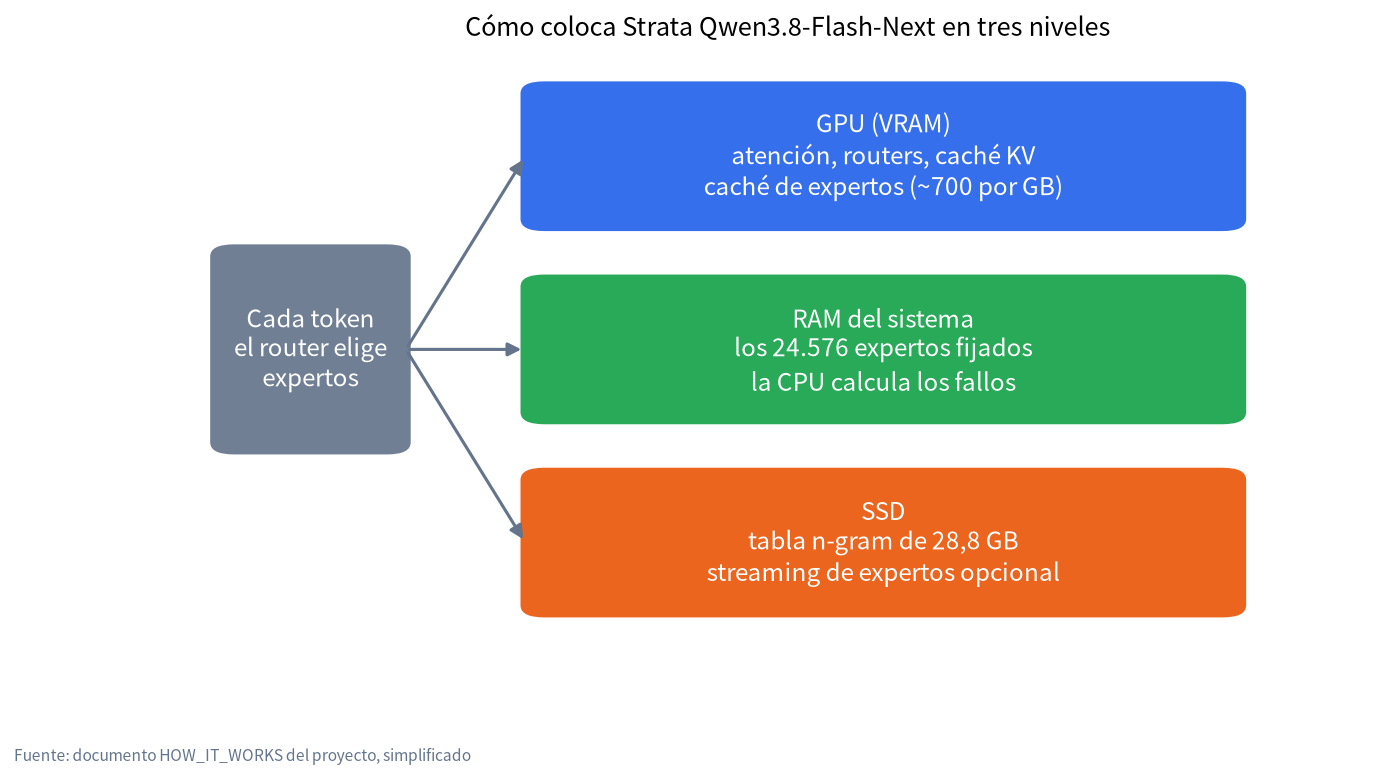
- GPU. Capas de atención, enrutadores, expertos compartidos, la cabeza de salida, la capa borrador de predicción de varios tokens (MTP), la caché KV y una caché de expertos que ocupa la VRAM restante. La documentación dice que cada gigabyte extra de VRAM aloja unos 700 expertos más.
- RAM. Los 24.576 expertos, fijados en memoria. Cuando el enrutador elige un experto que no está en VRAM, la CPU lo calcula en su sitio en lugar de copiarlo a la tarjeta.
- SSD. Una tabla de embeddings n-gram de 28,8 GB, de la que solo se leen unas pocas filas por token. Un modo opcional
--mmap-expertstambién puede leer expertos desde el disco cuando falta RAM; funciona, pero es mucho más lento.
La velocidad depende entonces de con qué frecuencia los expertos que necesita un token ya están en la GPU. La prueba de PC Watch con una RTX 3060 reportó unos 3.031 expertos en la tarjeta y una tasa de aciertos de caché cercana al 72 % con el archivo IQ2_XS, y unos 1.104 expertos y un 56 % con IQ3_S. El artículo del proyecto atribuye a la decodificación especulativa MTP una aceleración de 1,6 a 1,8 veces; esa cifra es de los propios autores.
Por qué Strata se hizo viral
Según las fuentes que leímos, coincidieron varias cosas:
- Instalación con un clic. Un instalador de Windows, un AppImage de Linux y una imagen de disco de macOS, además de un instalador de terminal de una línea. El motor para tu GPU se descarga en el primer arranque.
- Un titular fácil de repetir. «Un modelo de 125B en una tarjeta gráfica de 12 GB» es fácil de compartir, aunque el panorama completo exige 64 GB de RAM para las cuantizaciones mayores.
- El momento. Qwen3.8-Flash-Next era el modelo del que ya se hablaba en octubre.
- Soporte para agentes de programación.
strata connectescribe la configuración para Claude Code, Codex CLI, OpenCode, Hermes Agent, OpenClaw y otros. - Un ritmo de versiones rápido. Seis versiones entre el 25 de octubre y el 2 de noviembre.
- Atención en Hacker News. Un hilo llegó a 940 puntos y 420 comentarios cuando lo leímos, y otro se quejaba de que las discusiones sobre LLM locales se estaban llenando de enlaces a Strata. Lee el hilo principal.
Qué reportaron probadores independientes
Ninguna de las cifras siguientes es nuestra. Proceden de hardware, versiones de Strata y cuantizaciones distintos, así que tómalas como un rango, no como una clasificación.
| Fuente | Hardware | Modelo y cuantización | Resultado reportado |
|---|---|---|---|
| Benchmark comunitario de Strata (v0.1.41) | RTX 3060 12 GB, DDR4-3200 | Q2_0 / IQ2_XS / IQ3_XXS | 42,9 / 45,5 / 26,2 tok/s de generación con un prompt de 4.096 tokens |
| PC Watch (v0.1.38) | RTX 3060 12 GB, Core i9-12900, 64 GB DDR4 | IQ2_XS; IQ3_S | De 34 a 44; de 25 a 32 tok/s. Unos 7 s hasta el primer token con un prompt de 5,9k tokens, unos 25 s con 23k |
| note.com, usshi_it | RTX 3060 12 GB, Ryzen 5 3600, 48 GB | Q2_0 | 44,49 tok/s de generación, 326,68 tok/s de prefill, 1,60 s hasta el primer token |
| Siddhant Dembi | RTX 3060 en una VM de Proxmox, unos 50 GiB de RAM | IQ3_S | Unos 36 a 38 tok/s; necesitó un presupuesto de razonamiento para evitar el pensamiento interminable |
| AkitaOnRails | RTX 5090 | IQ3_S | Unos 159 tok/s y una puntuación de 91 en el benchmark de programación del propio autor |
| arm1.ru | Portátil RTX 5080, 30 GB de RAM | Flash-Next frente a Qwen3.8-27B en llama.cpp | Calidad de programación similar; Strata usó unos 21 GB de RAM, mandó de 4 a 5 GB al swap y leyó unos 6,9 TB del SSD en una ejecución de 1,3 horas |
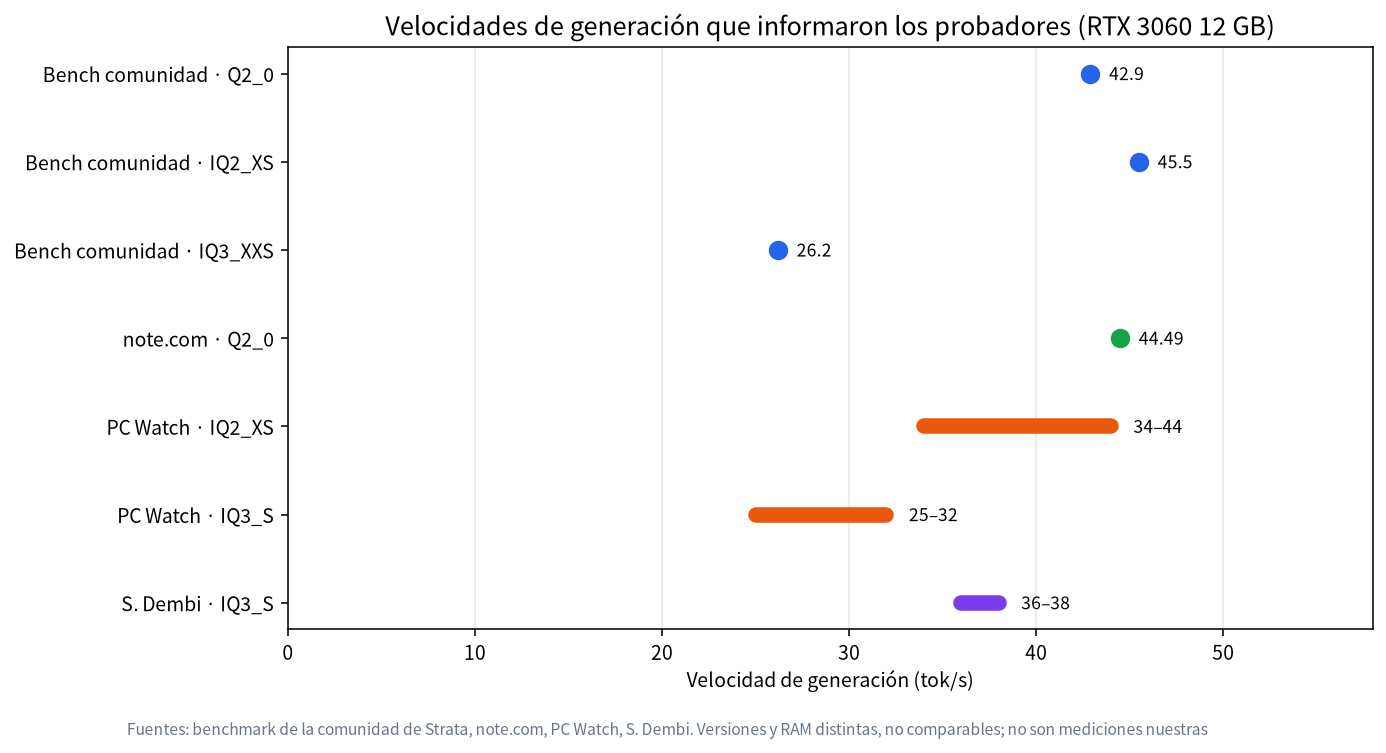
Una sola tarjeta, la RTX 3060, produce de unos 20 a 45 tokens por segundo según la cuantización, la versión y la memoria, y por eso «qué tan rápido es Strata» no tiene una única respuesta.
Reservas y críticas
- Calidad a 2-3 bits. El proyecto dice que IQ3_S iguala al modelo completo en sus pruebas publicadas. Es una afirmación de los autores. PC Watch encontró que la generación de código con IQ2_XS queda un escalón por debajo de IQ3_S, y en Hacker News hay comentarios escépticos, entre ellos un usuario que reportó una prueba de visión en la que el error de Strata fue mayor que el de llama.cpp con los mismos pesos. No pudimos verificarlo.
- Los prompts largos son lentos en una tarjeta de 12 GB. PC Watch midió unos 25 segundos hasta el primer token con un prompt de 23k tokens, lo que perjudica a los agentes de programación que envían archivos enteros.
- Presión de memoria. La prueba de arm1.ru muestra un portátil con 30 GB de RAM haciendo swap y el SSD ocupado durante toda la ejecución.
- Un proyecto joven. El repositorio tiene seis semanas y salen versiones cada dos días. Los ajustes y las velocidades cambian entre versiones, y la propia documentación de Strata afirma que no ha tenido auditoría de seguridad externa.
- Instalador por tubería. El instalador de una línea es cómodo, pero es un script que ejecutas con tus permisos de usuario. Léelo, o usa el instalador firmado de la aplicación.
- Licencia del modelo. El motor es MIT, pero los pesos de Qwen están bajo la Qwen Community License; léela antes de un uso comercial.
- Las cifras no coinciden en todas partes. Algunos textos hablan de 176B parámetros; el repositorio dice 125B, que es lo que usamos.
Strata frente a Ollama de un vistazo
| Strata | Ollama | |
|---|---|---|
| Objetivo principal | Ejecutar modelos MoE muy grandes y concretos con poca VRAM repartiendo GPU, RAM y SSD | Gestor general de modelos: descargar, ejecutar y servir muchos modelos pequeños y medianos |
| Estrellas (2026-11-04) | 39.548 | 185.856 |
| Modelos | Qwen3.8-Flash-Next, Qwen3.6-35B-A3B, DeepSeek V4.1-Flash | Una biblioteca grande; véase ollama.com/library |
| Última versión que vimos | v0.2.10 (2 nov) | v0.40.14 (3 nov) |
| Qwen3.8-Flash-Next | Funciona en Windows, Linux y macOS | La página de la biblioteca mostraba una sola etiqueta, 125b-mlx (105 GB, para Apple Silicon); no encontramos etiqueta para GPU NVIDIA y no probamos |
Se solapan menos de lo que sugieren los titulares. Si quieres una sola herramienta para muchos modelos, Ollama sigue siendo la opción más fácil; si quieres esta clase concreta de modelo en una tarjeta de 12 a 24 GB, Strata es la construida para ello. La comparación completa con llama.cpp y LM Studio está en nuestro artículo comparativo, la instalación en la guía de instalación y el aspecto del hardware en nuestro artículo de requisitos de hardware. Si Ollama te resulta nuevo, empieza con nuestra guía de instalación de Ollama.
Lo que hicimos y lo que no
El 2026-11-04 leímos los documentos del repositorio de Strata, sus notas de versión, las notas de versión y la página de biblioteca de Ollama y los informes de terceros enlazados arriba. No instalamos Strata, no descargamos ningún peso ni medimos ninguna velocidad. Cada cifra se atribuye a su fuente.
Preguntas frecuentes (FAQ)
¿Qué es Strata en pocas palabras?
Strata es un programa gratuito que permite a un PC normal ejecutar un modelo de IA muy grande manteniendo las partes más activas en la tarjeta gráfica, el resto en la RAM y una tabla de consulta en el SSD. Es un motor más una aplicación de chat, no un modelo.
¿Strata es gratuito y de código abierto?
El motor tiene licencia MIT. Los modelos que descarga tienen sus propias licencias; Qwen3.8-Flash-Next usa la Qwen Community License 1.0.
¿De verdad es un modelo de 125B en una GPU de 12 GB?
El modelo tiene 125.000 millones de parámetros en total, pero unos 6.000 millones están activos por token. Aun así, Strata pide unos 38 a 55 GB de RAM y VRAM combinadas para el modelo y unos 80 GB de disco, de modo que la tarjeta de 12 GB es solo el mínimo para la parte de GPU.
¿Puedo ejecutar Strata y Ollama en el mismo PC?
Sí. Strata escucha por defecto en el puerto 8080 y Ollama en el 11434, pero ambos quieren la misma VRAM y RAM, así que ejecuta un modelo grande a la vez. La guía de instalación lo explica.
¿Es seguro instalar Strata?
El proyecto dice que no tiene telemetría ni cuentas y que su servidor escucha en localhost, pero también que no ha habido una auditoría de seguridad externa. Instálalo primero en un equipo sin datos sensibles y descárgalo solo del repositorio oficial.
¿Strata sustituye a Ollama?
No. Resuelven problemas distintos. Mucha gente mantendrá Ollama para los modelos de todos los días y añadirá Strata para un modelo MoE grande.
Habla con nosotros
¿Tienes una duda sobre GPU, RAM o presupuesto? Únete a la comunidad o escribe a admin@microaione.com y lo resolvemos contigo. Si prefieres una máquina montada y probada, consulta nuestra guía de máquinas y soluciones.