Strata 하드웨어 요구 사양: RAM·VRAM·SSD는 얼마나 필요한가, 예산별 구성 포함
업데이트 2026-11-04. 저희는 Strata를 직접 실행해 보지 않았습니다. 아래의 모든 요구 사양은 프로젝트 문서나 이름이 밝혀진 테스터에게서 나왔고, 모든 속도는 그들의 값입니다.
Strata 하드웨어 요구 사양이 이 도구가 흥미로운 이유입니다. 12 GB 그래픽카드로 1,250억 파라미터 모델이라니, 무게가 실제로 어디에 있는지 보기 전에는 불가능하게 들립니다. 솔직하게 요약하면 GPU는 비용의 가장 작은 부분입니다. 모델의 대부분은 시스템 RAM에, 일부는 SSD에 있고, GPU는 가장 자주 쓰는 전문가의 캐시를 갖습니다. 이 글은 문서와 테스터 보고를 PC를 계획할 수 있는 숫자로 바꾸고, 예산별 구성을 스케치하며, 저희가 추측하지 않는 지점을 밝힙니다. 이 도구를 아직 모르신다면 Strata란 무엇인가를 먼저 읽으세요.
Strata 하드웨어 요구 사양 요약
| 부품 | 현실적인 최소 | 여유 있는 사양 |
|---|---|---|
| GPU | 12 GB NVIDIA RTX 20~50 시리즈(오래된 카드는 CUDA 12 엔진). AMD, Intel Arc, Apple Silicon은 별도 가이드 | 16~24 GB 또는 카드 두 장 |
| RAM | 작은 두 크기에는 약 48 GB | 모든 크기에 64 GB. 긴 컨텍스트라면 더 |
| SSD | 여유 약 80 GB, NVMe 권장 | 여러 크기를 두려면 1 TB |
| CPU | 최신 x86-64. 엔진에는 AVX2와 AVX-512 경로가 있음 | 테스터에 따르면 AVX-512가 도움 |
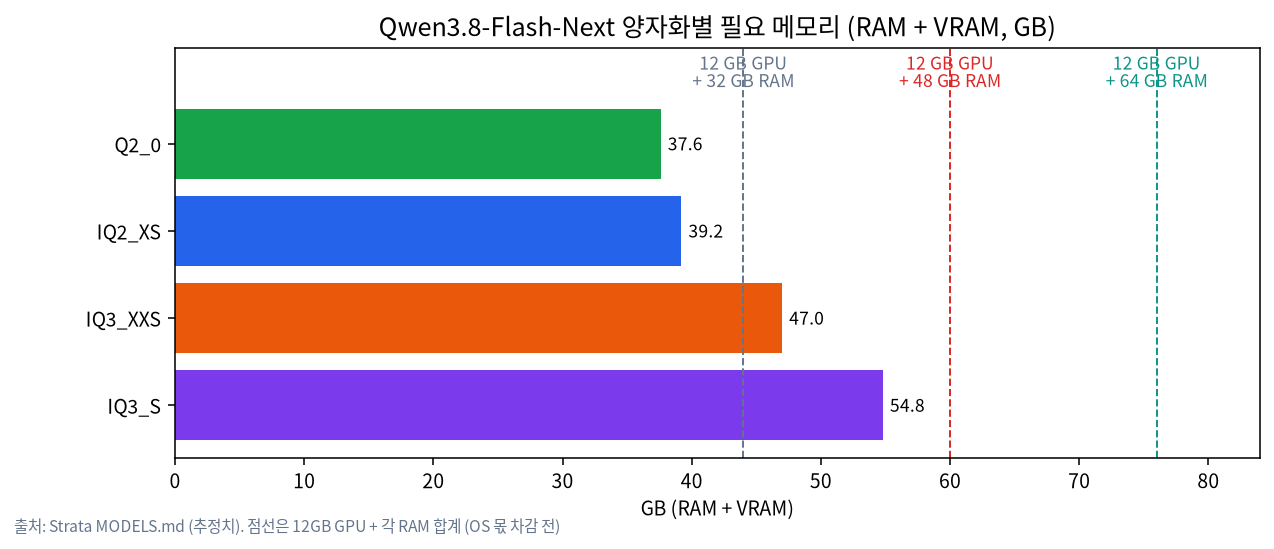
프로젝트의 모델 페이지는 가중치를 RAM+VRAM으로 적고 있습니다. Q2_0 37.6 GB, IQ2_XS 39.2, IQ3_XXS 47.0, IQ3_S 54.8입니다. 운영체제가 쓸 여유를 남기라고 하고, 수치는 추정이라고 밝힙니다. AkitaOnRails의 리뷰어는 프로젝트가 밝힌 최소가 RAM과 VRAM 합계 32 GB이며 이는 가장 압축된 버전만 돌린다고 쓰고, 자신의 테스트에서 점수가 좋았던 IQ3_S는 RAM 약 64 GB를 원했다고 썼습니다.
부품별 역할
GPU와 VRAM. 프로젝트의 HOW_IT_WORKS 문서에 따르면 카드에는 어텐션 층, 라우터, 공유 전문가, KV 캐시, 그리고 남은 VRAM을 채우는 전문가 캐시가 올라갑니다. 1 GB가 늘 때마다 전문가 약 700개입니다. 캐시가 클수록 더 많은 토큰이 GPU에서 계산됩니다. PC Watch는 12 GB 카드에서 IQ2_XS일 때 전문가 약 3,031개와 적중률 72%, IQ3_S일 때 1,104개와 56%를 측정했습니다. 병렬 요청 수도 VRAM을 따릅니다. 12 GB에서 1, 20 GB에서 2, 24 GB에서 3, 32 GB 이상에서 4입니다.
RAM. 전문가 24,576개 전부가 고정 메모리에 있고, GPU에 없는 것은 CPU가 계산합니다. RAM 용량이 어떤 크기를 돌릴 수 있는지 정하고, RAM 속도와 CPU 명령어가 미스 처리의 속도를 정합니다. PC Watch는 테스트 CPU의 DDR4 대역폭과 AVX-512 부재를 속도를 늦추는 요인으로 꼽았고, 다른 일본 테스터도 AVX-512가 없는 CPU에 대해 같은 말을 했습니다.
SSD. 28.8 GB짜리 n-gram 표는 토큰당 몇 줄만 읽습니다. RAM이 모자라면 선택 모드가 전문가를 디스크에서 스트리밍하는데, 문서는 동작은 하지만 훨씬 느리다고 합니다. RAM 30 GB의 노트북에서 arm1.ru 리뷰어는 1.3시간 테스트에서 SSD로부터 약 6.9 TB를 읽었다고 측정했습니다(평균 1.4 GB/s).
CPU. 헤드라인 사양은 아니지만 캐시 미스마다 실제 일을 합니다. 엔진에는 AVX-512가 있는 CPU와 없는 CPU를 위한 별도 경로가 있습니다.
테스터가 보고한 예산별 구성
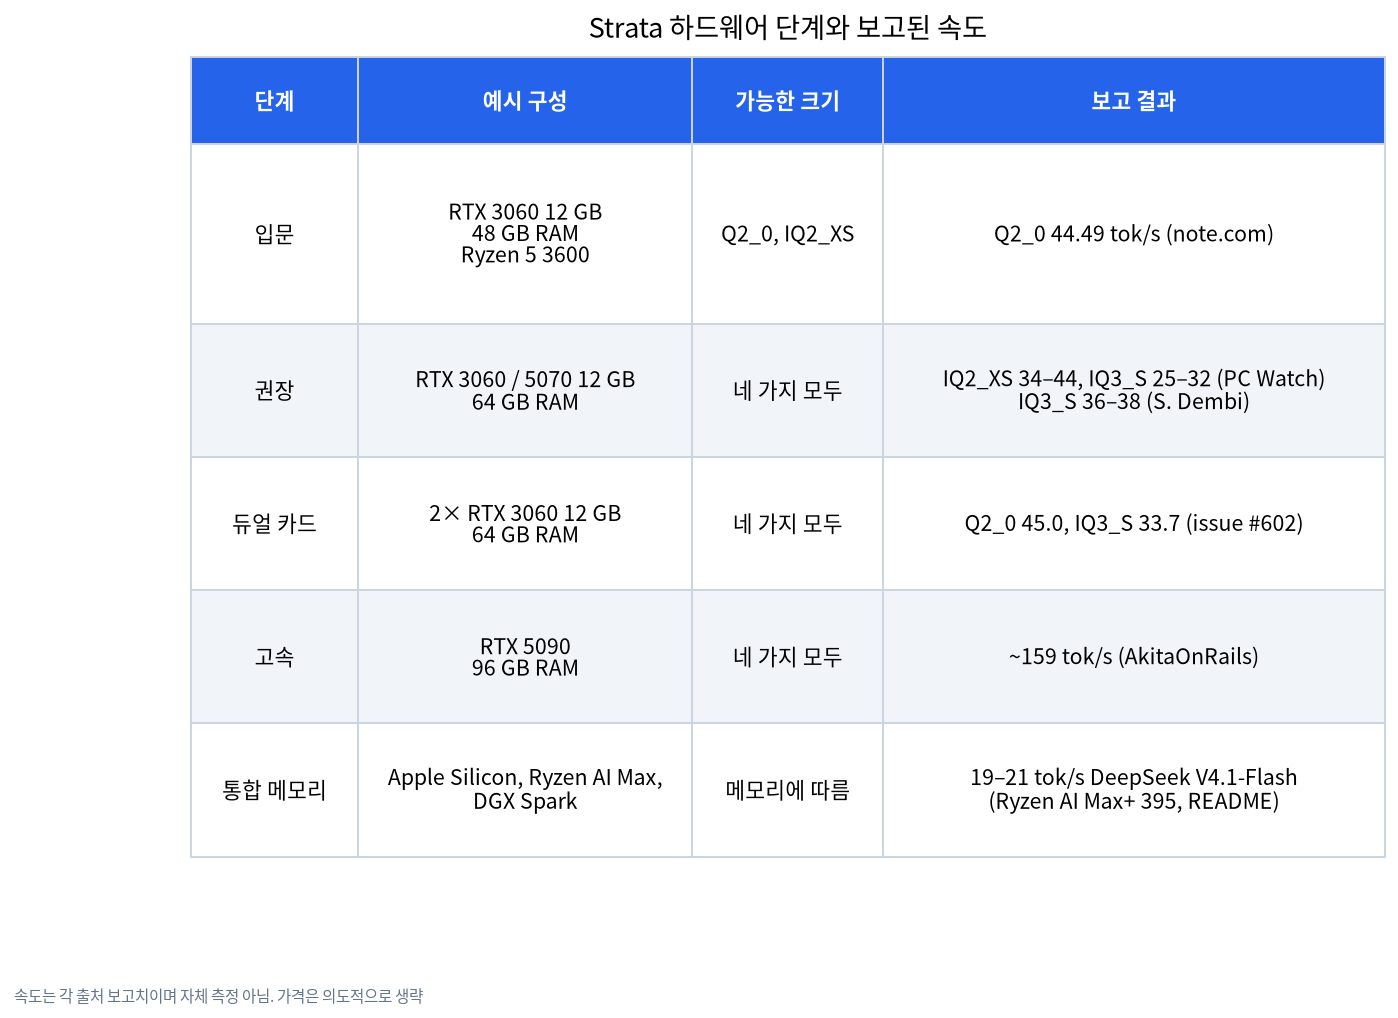
| 등급 | 예시 부품 | 맞는 크기 | 출처가 보고한 것 |
|---|---|---|---|
| 입문 | RTX 3060 12 GB, RAM 48 GB, Ryzen 5 3600 | Q2_0, IQ2_XS | Q2_0에서 생성 44.49 tok/s, 프리필 326.68 tok/s (note.com) |
| 권장 | RTX 3060 또는 RTX 5070 12 GB, RAM 64 GB | 4종 모두 | IQ2_XS 34~44, IQ3_S 25~32 tok/s (PC Watch). IQ3_S 36~38 tok/s, RAM 약 50 GiB (Dembi) |
| 카드 두 장 | RTX 3060 12 GB 2장, RAM 64 GB | 4종 모두 | Q2_0 45.0, IQ3_S 33.7 tok/s (프로젝트 이슈 #602). 멀티 GPU는 층 단위로 나누며 NVLink가 필요 없음 |
| 고속 | RTX 5090, RAM 96 GB, 강력한 CPU | 4종 모두 | 약 159 tok/s, 저자 자신의 벤치마크에서 91점 (AkitaOnRails) |
| 통합 메모리 | Apple Silicon(macOS 15+), Ryzen AI Max, DGX Spark | 메모리에 따라 | 프로젝트 README는 128 GB의 Ryzen AI Max+ 395에서 DeepSeek V4.1-Flash가 19~21 tok/s(코드)라고 보고 |
표에 가격은 일부러 넣지 않았습니다. GPU와 메모리 가격은 매주 변하는데, 위 출처들은 확인할 수 있는 날짜가 붙은 가격을 주지 않았습니다. 시작점으로는 날짜가 붙은 저희 가격 가이드가 낫습니다. 입문 구성, 24 GB GPU 구성, 중고 GPU 구매, 저렴한 LLM용 GPU를 보세요.
디스크와 SSD 계획
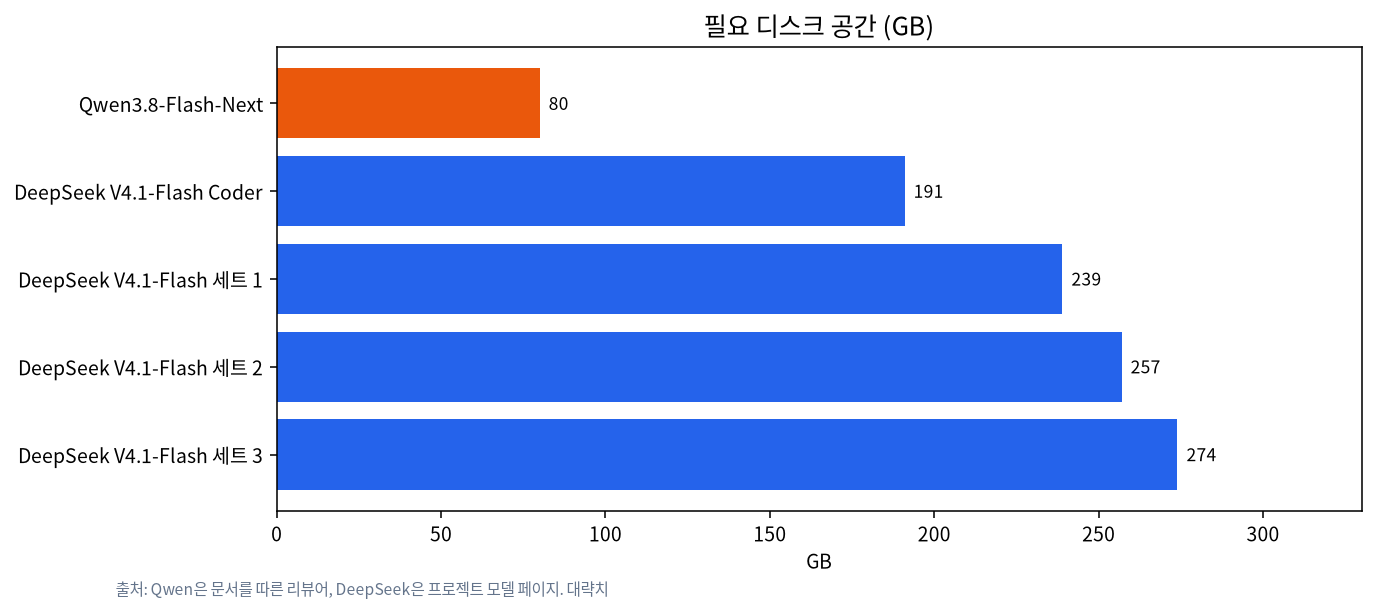
Qwen3.8-Flash-Next에는 여유 약 80 GB를 계획하세요. 양자화된 전문가, 보조 파일, n-gram 표가 다운로드에 포함되기 때문입니다. DeepSeek V4.1-Flash는 세트에 따라 191~274 GB가 필요하며, 이 경우는 12GB로 DeepSeek V4.1 Flash 돌리기에서 다룹니다. 읽기는 SSD를 닳게 하지 않지만 바쁜 드라이브는 다른 모든 것을 느리게 하므로, 가능하면 Strata 폴더를 시스템 디스크가 아닌 NVMe에 두세요.
노트북, WSL2, 통합 메모리
노트북은 애매한 경우입니다. arm1.ru 리뷰어는 RAM 30 GB의 RTX 5080 노트북 GPU에서 125B 모델을 돌려 동작한다는 것을 확인했지만 메모리가 빠듯했습니다. Strata는 RAM을 약 21 GB 쓰고 스왑이 4~5 GB였으며, 그래서 저희는 RAM 32 GB를 계획이 아니라 묘기라고 부르겠습니다. WSL2의 Windows에서도 동작합니다. 커뮤니티 목록에 RTX 5060 Ti 사례가 있지만, 문서는 Windows 그래픽 드라이버에서는 멀티 GPU 실행 시 전문가 메모리의 일부만 고정된다고 적고 있습니다. Strix Halo 같은 통합 메모리 머신에서는 그래픽 메모리와 RAM이 하나의 풀이라서, 128 GB라는 숫자 하나가 위 표의 VRAM과 RAM 수치를 대신합니다.
프로젝트 벤치마크 목록의 추가 결과
저장소에는 사용자가 제출한 실행 결과를 모은 커뮤니티 벤치마크 목록이 있습니다. 자가 보고이고 버전(v0.1.40~v0.1.43)과 프롬프트 길이가 다르며 저희는 하나도 재현하지 못했으므로, 순위가 아니라 범위의 감각으로만 보세요.
| 하드웨어(제출된 대로) | 크기 | 생성, tok/s |
|---|---|---|
| RX 9070 16 GB, Ryzen 7 5800X3D, RAM 64 GB | IQ3_XXS | 57.9~58.7 |
| RTX 5060 Ti 16 GB(WSL2), Ryzen 7 3700X, RAM 128 GB | IQ3_S | 47.7~48.2 |
| Tesla P40 24 GB 2장, Xeon E5-2699 v3, RAM 125 GB | IQ3_S | 35.0 |
| Tesla V100 32 GB, Threadripper 2990WX, RAM 96 GB | UD-IQ4_XS | 약 28~33 |
| Strix Halo 노트북, 통합 128 GB, 70 W | UD-IQ4_XS | 프롬프트 길이에 따라 42~59 |
두 가지가 눈에 띕니다. 목록의 16 GB 카드는 비슷한 크기에서 위의 12 GB 수치보다 높은 속도를 보고하는데, CPU와 버전은 다르지만 전문가 캐시 설계와 맞아떨어집니다. 그리고 오래된 24 GB 워크스테이션 카드도 RAM이 크면 쓸 만한 속도로 돕니다. 둘 다 아래의 업그레이드 순서와 맞지만 각각 한 건의 제출이므로 보장으로 읽지 마세요.
내 PC 어림해 보기
VRAM과 RAM을 더한 뒤 모델 크기를 빼세요. 남는 것이 운영체제, 브라우저, KV 캐시 등을 위한 공간입니다. 이것은 프로젝트의 숫자로 한 단순한 산수이지 측정이 아닙니다.
| 구성 (VRAM + RAM) | 합계 | IQ2_XS(39.2 GB) 여유 | IQ3_S(54.8 GB) 여유 |
|---|---|---|---|
| 12 GB + 32 GB | 44 GB | 약 4.8 GB, 매우 빠듯 | 들어가지 않음 |
| 12 GB + 48 GB | 60 GB | 약 20.8 GB | 약 5.2 GB, 매우 빠듯 |
| 12 GB + 64 GB | 76 GB | 약 36.8 GB | 약 21.2 GB |
여유가 적을수록 arm1.ru의 노트북처럼 스왑하게 될 가능성이 커지고 속도가 떨어집니다. 저희 조언은 ‘딱 맞는’ 머신에서 가장 큰 크기를 쫓지 말고, 한 단계 작은 크기를 고르고 긴 컨텍스트와 일상 사용을 위한 여유를 남기라는 것입니다. 같은 산수가 어떤 메모리를 살지도 알려 줍니다. 사 놓고 들어가기를 바라지 말고, 먼저 크기를 정한 뒤 거꾸로 계산하세요.
저희가 읽은 문서에 따른 업그레이드 순서
이것은 프로젝트가 설계를 설명하는 방식에서 나온 저희의 추론이지 측정한 순위가 아닙니다.
- RAM을 64 GB로. 모든 전문가가 거기에 있으므로 어떤 크기를 돌릴지 정합니다. 대개 가장 저렴한 큰 단계입니다.
- VRAM 늘리기. 1 GB마다 캐시된 전문가가 약 700개 늘고, 적중률이 오르면 CPU 계산이 줄어듭니다.
- AVX-512 CPU와 빠른 메모리. 테스터 두 명에 따르면 미스 처리에 도움이 됩니다.
- NVMe 저장장치. 디스크에서 전문가를 스트리밍해야 할 때 가장 중요합니다.
이 선택의 메모리 트레이드오프는 RAM vs VRAM과 CPU 오프로딩 가이드와 GPU VRAM 가이드를 참고하세요.
맞춤 PC가 어울리는 경우
가장 어려운 것은 부품 쇼핑입니다. 12 GB나 24 GB 카드, 충분한 RAM 슬롯, NVMe 드라이브, 파워서플라이, 쿨링을 맞춰야 합니다. 직접 하고 싶지 않다면, 선전의 저희 팀이 로컬 LLM 머신을 조립하고 테스트하며, 머신과 솔루션 가이드에 방식이 설명되어 있습니다. 목표 모델, 예산, 소음 한도를 알려 주시면 날짜가 붙은 가격으로 부품 목록을 제안해 드립니다. 저희는 어떤 머신에서도 Strata 벤치마크를 하지 않았으므로, 위의 숫자를 믿기보다 검토 중인 특정 구성에서 테스트해 달라고 요청하세요. 전력과 열은 전력과 쿨링 가이드에서 다룹니다.
저희가 한 것과 하지 않은 것
2026-11-04에 프로젝트의 MODELS, HOW_IT_WORKS, 멀티 GPU 문서와 위에 링크한 테스터 보고를 읽었습니다. 머신을 조립하지 않았고, 벤치마크를 돌리지 않았으며, 가격을 인용하지 않습니다. 한 사람에게서 나온 수치는 그 사람의 이름을 밝혔습니다.
자주 묻는 질문 (FAQ)
8 GB GPU로 Strata를 돌릴 수 있나요?
공식 경로는 12 GB 이상을 권장합니다. 프로젝트의 커뮤니티 목록에는 8 GB Quadro RTX 4000 두 장과 RAM 96 GB로 아주 긴 프롬프트에서 IQ2_XS를 생성 18~23 토큰/초로 돌린 사례가 있지만, 카드 두 장에 큰 RAM이 든 경우이고 저희가 확인한 것은 아닙니다.
RAM 32 GB로 충분한가요?
빠듯합니다. 가중치만으로 RAM과 VRAM 합계 37.6~54.8 GB가 필요하므로, 12 GB VRAM에 RAM 32 GB는 운영체제 몫을 빼기 전에 서류상 가장 작은 크기를 겨우 덮는 정도입니다. 프로젝트의 코딩 중심 변형은 RAM 약 32 GB로 적혀 있습니다. 표준 크기에는 48 GB가 현실적인 최소, 64 GB가 여유 있는 사양입니다.
RAM 속도도 중요한가요?
네. GPU에 없는 전문가는 CPU가 계산하기 때문입니다. 테스터들은 DDR4 대역폭과 AVX-512 부재를 요인으로 짚었지만, 통제된 비교는 없습니다.
NVMe SSD가 필요한가요?
표준 경로에서는 주로 공간이 필요하며 약 80 GB입니다. RAM이 모자라 Strata가 전문가를 디스크에서 스트리밍해야 한다면 NVMe가 더 중요해집니다.
AMD, Intel, Mac도 쓸 수 있나요?
프로젝트는 지원하는 AMD Radeon 카드, Linux의 Intel Arc, macOS 15 이상의 Apple Silicon, Ryzen AI Max, DGX Spark를 나열하며 각각 별도 가이드가 있습니다. 내 카드의 설치 가이드를 확인하세요.
작은 GPU 두 장이 큰 한 장보다 나은가요?
한 테스터는 RTX 3060 두 장에서 Q2_0이 초당 45.0 토큰이라고 측정했고, 다른 테스터들의 단일 카드는 40대였으므로 그 크기에서 이득은 분명하지 않습니다. 더 큰 크기에서는 더 도움이 될 수 있지만 통제된 비교는 찾지 못했습니다.
문의하기
GPU, RAM, 예산에 맞춰 구성을 계획하시나요? 커뮤니티에 참여하시거나 admin@microaione.com으로 현재 가지고 계신 사양을 알려 주세요.