Qu’est-ce que Strata ? Pourquoi ce moteur de LLM local est devenu viral et en quoi il diffère d’Ollama
Mis à jour le 2026-11-04. Cet article est une lecture de sources publiques. Nous n’avons ni installé Strata ni lancé de benchmark nous-mêmes.
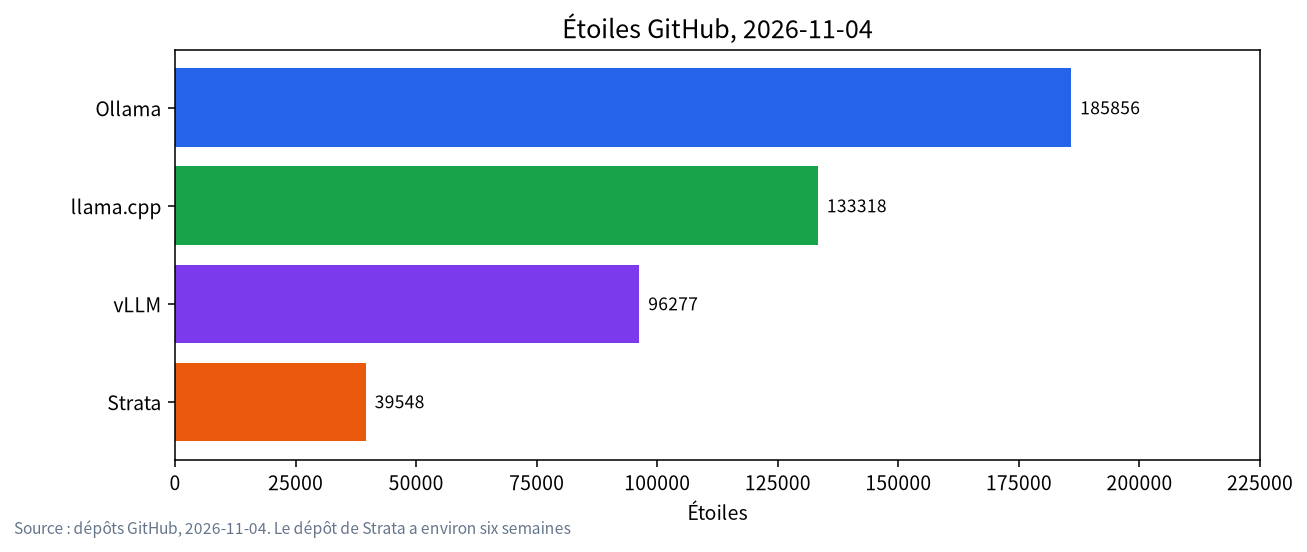
Qu’est-ce que Strata ? C’est un moteur d’inférence open source, livré sous forme d’application de bureau et d’outil de terminal, construit autour d’une idée : exécuter un très grand modèle à mélange d’experts (MoE), comme Qwen3.8-Flash-Next et ses 125 milliards de paramètres, sur un PC de jeu ordinaire en répartissant le modèle entre la carte graphique, la RAM et le SSD. Environ six semaines après la création de son dépôt, il compte quelque 39 500 étoiles GitHub, et presque tous les forums de LLM locaux ont un fil à son sujet. Nous expliquons ici ce qu’est Strata, pourquoi il s’est diffusé si vite, ce que des testeurs indépendants ont mesuré et où se trouvent les réserves. Il se place à côté d’Ollama sans le remplacer ; la comparaison est dans notre article Strata contre Ollama.
Qu’est-ce que Strata, en un paragraphe
Strata est publié sur GitHub sous licence MIT, et le dépôt est écrit surtout en C++. Il s’installe comme application de bureau (Windows, AppImage Linux, macOS) ou comme outil de terminal que l’on démarre avec strata launch. Une fois un modèle lancé, il expose sur votre propre machine une API OpenAI Chat Completions, une API Anthropic Messages et une API Responses, de sorte que les outils de programmation peuvent s’y connecter. La documentation cite ggml, la bibliothèque de tenseurs derrière llama.cpp, comme composant tiers, mais l’ordonnancement qui distingue Strata est le sien.
| Élément | Valeur au 2026-11-04 | Origine |
|---|---|---|
| Dépôt créé | 2026-09-24 | GitHub |
| Étoiles / forks | 39 548 / 4 298 | GitHub |
| Dernière version | v0.2.10 (2 nov. 2026, UTC) | Releases GitHub |
| Licence du moteur | MIT | Dépôt |
| Licence du modèle | Les poids de Qwen3.8-Flash-Next sont sous Qwen Community License 1.0, pas MIT | Documentation du projet |
| Adresse locale par défaut | http://127.0.0.1:8080 |
Guide d’installation |
| Télémétrie | Aucune et pas de compte, selon le projet | Document de sécurité |
| Audit de sécurité externe | Pas encore, selon le même document | Document de sécurité |
Les modèles que Strata exécute
Un modèle à mélange d’experts possède de nombreux sous-réseaux spécialisés (les « experts ») et n’en utilise que quelques-uns par jeton. Qwen3.8-Flash-Next compte environ 125 milliards de paramètres au total, mais seulement environ 6 milliards actifs par jeton (512 experts par couche, 24 576 au total, et un contexte natif de 262 144 jetons). Ce rapport, environ 5 % des poids par jeton, est ce que Strata exploite.
| Modèle | Taille | Ce que dit la documentation |
|---|---|---|
| Qwen3.8-Flash-Next | 125B au total, ~6B actifs | Quatre quantifications demandant 37,6 Go (Q2_0), 39,2 Go (IQ2_XS), 47,0 Go (IQ3_XXS) ou 54,8 Go (IQ3_S) de RAM plus VRAM |
| Qwen3.6-35B-A3B | 35B au total, ~3B actifs | Paquets Unsloth, 32 à 52 Go de RAM |
| DeepSeek V4.1-Flash | Très grand | 239 à 274 Go de téléchargement, GPU de 12 Go, 46 à 64 Go de RAM ; voir notre article sur DeepSeek V4.1 Flash avec 12 Go |
Pour comprendre pourquoi les modèles MoE se comportent ainsi, voyez notre guide des modèles MoE.
Comment fonctionne Strata : trois niveaux
Le document HOW_IT_WORKS de Strata décrit trois niveaux.
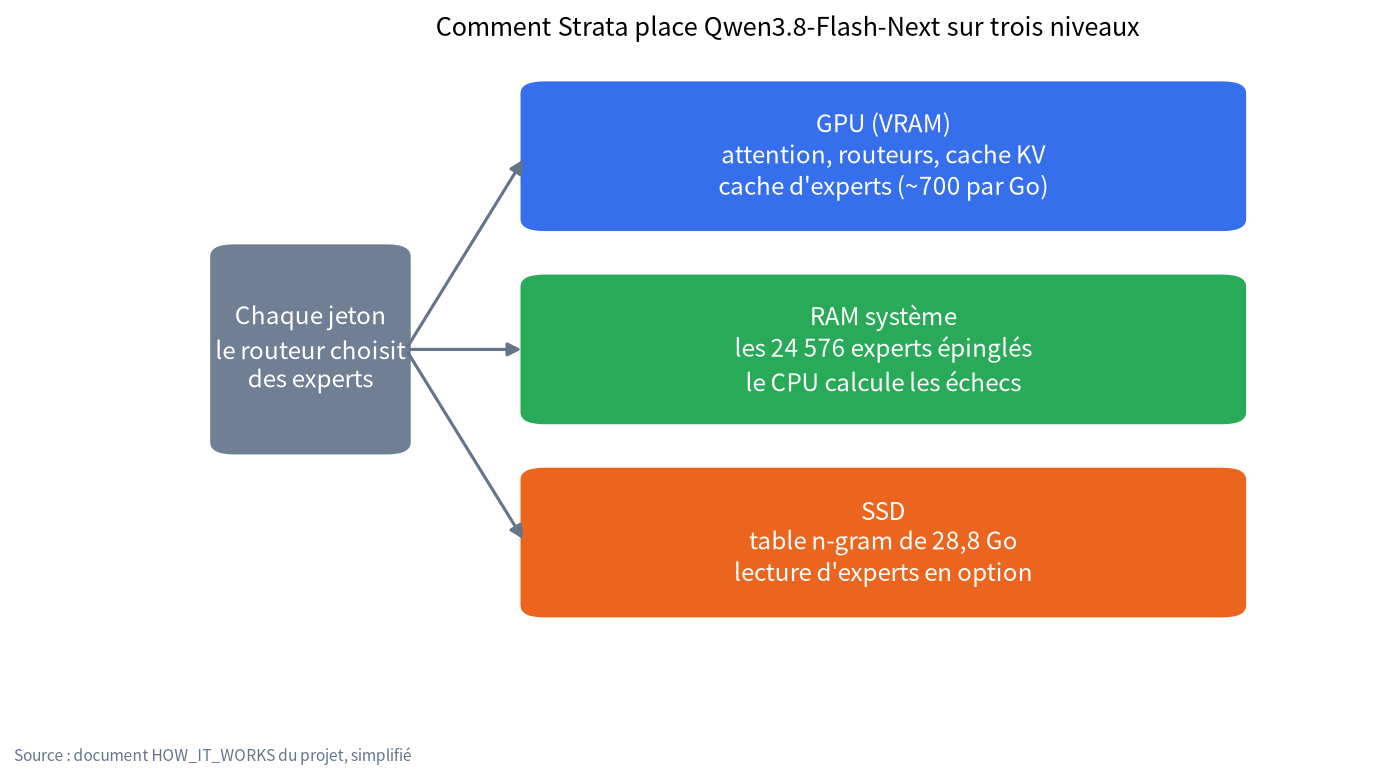
- GPU. Les couches d’attention, les routeurs, les experts partagés, la tête de sortie, la couche brouillon de prédiction multi-jetons (MTP), le cache KV et un cache d’experts qui remplit la VRAM restante. La documentation indique que chaque gigaoctet de VRAM supplémentaire loge environ 700 experts de plus.
- RAM. Les 24 576 experts, épinglés en mémoire. Quand le routeur choisit un expert qui n’est pas en VRAM, le CPU le calcule sur place au lieu de le copier sur la carte.
- SSD. Une table d’embeddings n-gram de 28,8 Go, dont seules quelques lignes sont lues par jeton. Un mode optionnel
--mmap-expertspeut aussi faire lire les experts depuis le disque quand la RAM manque ; cela fonctionne, mais bien plus lentement.
La vitesse dépend alors de la fréquence à laquelle les experts dont un jeton a besoin sont déjà sur le GPU. Le test de PC Watch sur une RTX 3060 a relevé environ 3 031 experts sur la carte et un taux de réussite du cache proche de 72 % avec le fichier IQ2_XS, et environ 1 104 experts et 56 % avec IQ3_S. L’article du projet attribue au décodage spéculatif MTP une accélération de 1,6 à 1,8 fois ; ce chiffre vient des auteurs eux-mêmes.
Pourquoi Strata est devenu viral
D’après les sources que nous avons lues, plusieurs choses se sont conjuguées :
- Une installation en un clic. Un installeur Windows, un AppImage Linux et une image disque macOS, plus un installeur de terminal d’une ligne. Le moteur pour votre GPU se télécharge au premier démarrage.
- Un titre facile à répéter. « Un modèle de 125B sur une carte graphique de 12 Go » se partage facilement, même si le tableau complet demande 64 Go de RAM pour les quantifications les plus grandes.
- Le moment. Qwen3.8-Flash-Next était déjà le modèle dont tout le monde parlait en octobre.
- La prise en charge des agents de programmation.
strata connectécrit la configuration pour Claude Code, Codex CLI, OpenCode, Hermes Agent, OpenClaw et d’autres. - Un rythme de versions rapide. Six versions entre le 25 octobre et le 2 novembre.
- L’attention sur Hacker News. Un fil a atteint 940 points et 420 commentaires lors de notre lecture, et un second se plaignait que les discussions sur les LLM locaux soient inondées de liens vers Strata. Lire le fil principal.
Ce que des testeurs indépendants ont rapporté
Aucun des chiffres ci-dessous n’est de nous. Ils proviennent de matériels, de versions de Strata et de quantifications différents ; prenez-les comme une fourchette, pas comme un classement.
| Source | Matériel | Modèle et quantification | Résultat rapporté |
|---|---|---|---|
| Benchmark communautaire de Strata (v0.1.41) | RTX 3060 12 Go, DDR4-3200 | Q2_0 / IQ2_XS / IQ3_XXS | 42,9 / 45,5 / 26,2 tok/s en génération avec un prompt de 4 096 jetons |
| PC Watch (v0.1.38) | RTX 3060 12 Go, Core i9-12900, 64 Go DDR4 | IQ2_XS ; IQ3_S | 34 à 44 ; 25 à 32 tok/s. Environ 7 s jusqu’au premier jeton pour un prompt de 5,9k jetons, environ 25 s pour 23k |
| note.com, usshi_it | RTX 3060 12 Go, Ryzen 5 3600, 48 Go | Q2_0 | 44,49 tok/s en génération, 326,68 tok/s en préremplissage, 1,60 s jusqu’au premier jeton |
| Siddhant Dembi | RTX 3060 dans une VM Proxmox, environ 50 Gio de RAM | IQ3_S | Environ 36 à 38 tok/s ; un budget de raisonnement a été nécessaire pour éviter une réflexion sans fin |
| AkitaOnRails | RTX 5090 | IQ3_S | Environ 159 tok/s et un score de 91 sur le benchmark de programmation de l’auteur |
| arm1.ru | Portable RTX 5080, 30 Go de RAM | Flash-Next contre Qwen3.8-27B dans llama.cpp | Qualité de programmation similaire ; Strata a utilisé environ 21 Go de RAM, poussé 4 à 5 Go dans le swap et lu environ 6,9 To sur le SSD en 1,3 heure |
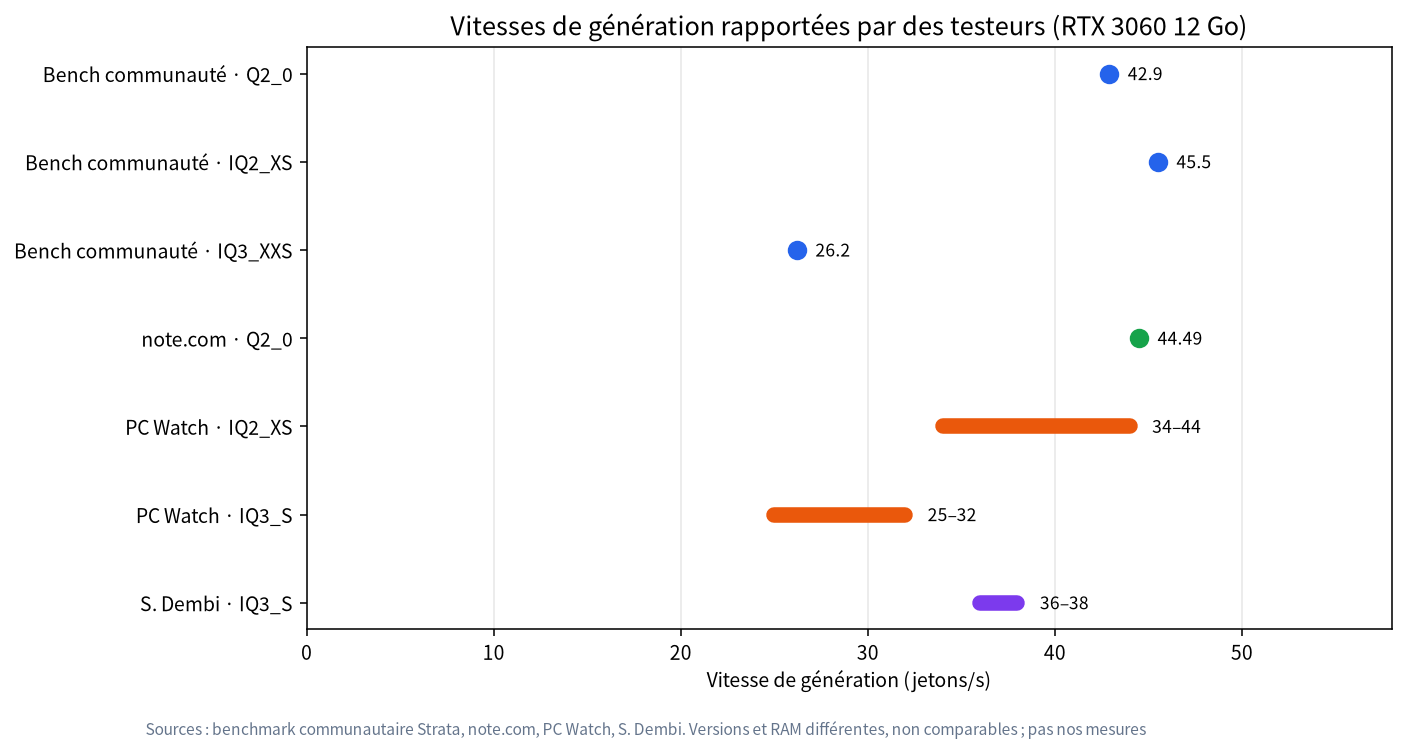
Une seule carte, la RTX 3060, donne de 20 à 45 jetons par seconde environ selon la quantification, la version et la mémoire, ce qui explique que « quelle est la vitesse de Strata » n’ait pas de réponse unique.
Réserves et critiques
- Qualité à 2 ou 3 bits. Le projet dit qu’IQ3_S égale le modèle complet dans ses tests publiés. C’est l’affirmation des auteurs. PC Watch a jugé la génération de code en IQ2_XS un cran en dessous d’IQ3_S, et Hacker News contient des commentaires sceptiques, dont un utilisateur qui a rapporté un test de vision où l’erreur de Strata dépassait celle de llama.cpp avec les mêmes poids. Nous n’avons pas pu le vérifier.
- Les longs prompts sont lents sur une carte de 12 Go. PC Watch a mesuré environ 25 secondes jusqu’au premier jeton pour un prompt de 23k jetons, ce qui pénalise les agents de programmation qui envoient des fichiers entiers.
- Pression sur la mémoire. Le test d’arm1.ru montre un portable de 30 Go de RAM qui swappe, le SSD occupé pendant toute l’exécution.
- Un projet jeune. Le dépôt a six semaines, et une version sort tous les deux jours. Les réglages et les vitesses changent d’une version à l’autre, et la documentation de Strata dit elle-même qu’il n’y a pas eu d’audit de sécurité externe.
- Installeur par tube. L’installeur d’une ligne est pratique, mais c’est un script que vous exécutez avec vos droits d’utilisateur. Lisez-le, ou utilisez l’installeur signé de l’application.
- Licence du modèle. Le moteur est MIT, mais les poids de Qwen sont sous Qwen Community License ; lisez-la avant un usage commercial.
- Les chiffres ne concordent pas partout. Certains articles parlent de 176B paramètres ; le dépôt dit 125B, que nous retenons.
Strata et Ollama en un coup d’œil
| Strata | Ollama | |
|---|---|---|
| Objectif principal | Exécuter des modèles MoE précis et très grands avec peu de VRAM en étageant GPU, RAM et SSD | Gestionnaire de modèles généraliste : télécharger, exécuter et servir de nombreux modèles petits et moyens |
| Étoiles (2026-11-04) | 39 548 | 185 856 |
| Modèles | Qwen3.8-Flash-Next, Qwen3.6-35B-A3B, DeepSeek V4.1-Flash | Une grande bibliothèque ; voir ollama.com/library |
| Dernière version vue | v0.2.10 (2 nov.) | v0.40.14 (3 nov.) |
| Qwen3.8-Flash-Next | Fonctionne sous Windows, Linux et macOS | La page de bibliothèque montrait une seule étiquette, 125b-mlx (105 Go, pour Apple Silicon) ; nous n’avons trouvé aucune étiquette pour les GPU NVIDIA et n’avons pas testé |
Ils se recoupent moins que les titres ne le laissent croire. Si vous voulez un seul outil pour beaucoup de modèles, Ollama reste le choix le plus simple ; si vous voulez cette classe de modèle précise sur une carte de 12 à 24 Go, Strata est celui qui est conçu pour cela. La comparaison complète avec llama.cpp et LM Studio est dans notre article comparatif, l’installation dans le guide d’installation et le volet matériel dans notre article sur la configuration requise. Si Ollama lui-même est nouveau pour vous, commencez par notre guide d’installation d’Ollama.
Ce que nous avons fait et ce que nous n’avons pas fait
Le 2026-11-04, nous avons lu les documents du dépôt de Strata, ses notes de version, les notes de version et la page de bibliothèque d’Ollama, ainsi que les rapports de tiers liés ci-dessus. Nous n’avons pas installé Strata, téléchargé aucun poids ni mesuré aucune vitesse. Chaque chiffre est attribué à sa source.
Questions fréquentes (FAQ)
Qu’est-ce que Strata, en termes simples ?
Strata est un programme gratuit qui permet à un PC ordinaire d’exécuter un très grand modèle d’IA en gardant les parties les plus sollicitées sur la carte graphique, le reste en RAM et une table de recherche sur le SSD. C’est un moteur plus une application de discussion, pas un modèle.
Strata est-il gratuit et open source ?
Le moteur est sous licence MIT. Les modèles qu’il télécharge ont leurs propres licences ; Qwen3.8-Flash-Next utilise la Qwen Community License 1.0.
Est-ce vraiment un modèle de 125B sur un GPU de 12 Go ?
Le modèle compte 125 milliards de paramètres au total, mais environ 6 milliards sont actifs par jeton. Strata demande tout de même environ 38 à 55 Go de RAM et VRAM combinées pour le modèle et environ 80 Go de disque ; la carte de 12 Go n’est que le minimum pour la partie GPU.
Puis-je exécuter Strata et Ollama sur le même PC ?
Oui. Strata écoute par défaut sur le port 8080 et Ollama sur 11434, mais tous deux veulent la même VRAM et la même RAM : n’exécutez donc qu’un grand modèle à la fois. Le guide d’installation en parle.
Est-il sûr d’installer Strata ?
Le projet dit n’avoir ni télémétrie ni comptes, et son serveur écoute sur localhost, mais il dit aussi qu’il n’y a pas eu d’audit de sécurité externe. Installez-le d’abord sur une machine sans données sensibles et ne téléchargez que depuis le dépôt officiel.
Strata remplace-t-il Ollama ?
Non. Ils résolvent des problèmes différents. Beaucoup garderont Ollama pour les modèles du quotidien et ajouteront Strata pour un grand modèle MoE.
Parlons-en
Une question sur le GPU, la RAM ou le budget ? Rejoignez la communauté ou écrivez à admin@microaione.com et nous verrons cela avec vous. Si vous préférez une machine montée et testée, consultez notre guide des machines et solutions.