Strata против Ollama, llama.cpp, LM Studio и vLLM: для чего каждый и что выбрать
Обновлено 2026-11-04. По открытой документации, заметкам о релизах и сторонним отчётам. Мы не запускали собственных бенчмарков.
Strata против Ollama — сравнение, которого в этом месяце требуют все, но это не честный поединок двух инструментов с одной и той же задачей. Strata — новый движок, созданный, чтобы запускать класс очень больших моделей «смесь экспертов» (MoE) на ПК с небольшой видеокартой. Ollama — зрелый универсальный менеджер моделей. llama.cpp, LM Studio и vLLM занимают другие уголки той же карты. В этой статье пять инструментов поставлены рядом, показано, для чего нужен каждый, проверено то, что мы смогли установить о поддержке Qwen3.8-Flash-Next, а в конце дана подсказка по выбору. Если слово «Strata» вам знакомо только по названию, начните с нашего объяснения, что такое Strata.
Strata против Ollama: короткий ответ
- Strata: выбирайте, если нужна очень большая MoE-модель, прежде всего Qwen3.8-Flash-Next, на ПК с GPU 12–24 ГБ и 48–64 ГБ ОЗУ.
- Ollama: выбирайте, если нужен простейший способ запускать множество малых и средних моделей и подключать их к приложениям.
- llama.cpp: выбирайте, если нужен максимальный контроль над моделями GGUF и железом или если нужный вам инструмент построен на нём.
- LM Studio: выбирайте, если нужно графическое приложение для поиска, скачивания и общения с моделями.
- vLLM: выбирайте, если вы обслуживаете много пользователей одновременно с GPU, у которых достаточно памяти.
Сравнение рядом
| Strata | Ollama | llama.cpp | LM Studio | vLLM | |
|---|---|---|---|---|---|
| Основная функция | Запуск очень больших MoE-моделей на малой видеопамяти через многоуровневое размещение GPU, ОЗУ и SSD | Скачивать, запускать и раздавать множество моделей одной командой | Библиотека инференса и сервер, на которых построены многие инструменты | Настольное приложение для поиска, скачивания и чата | Движок для обслуживания с высокой пропускной способностью |
| Лицензия | MIT (движок) | MIT | MIT | Закрытое приложение, по условиям бесплатное для личного и рабочего использования | Apache-2.0 |
| Звёзды на GitHub (2026-11-04) | 39 548 | 185 856 | 133 318 | Не открытый репозиторий | 96 277 |
| Интерфейс | Настольное приложение и терминал | Командная строка, приложение, REST API | Командная строка и llama-server |
Графическое приложение, CLI lms, безголовый режим |
Библиотека Python и сервер |
| API | В стиле OpenAI, Anthropic и Responses | Собственный API плюс OpenAI-совместимые точки | OpenAI-совместимый сервер | OpenAI-совместимый сервер | OpenAI-совместимый сервер |
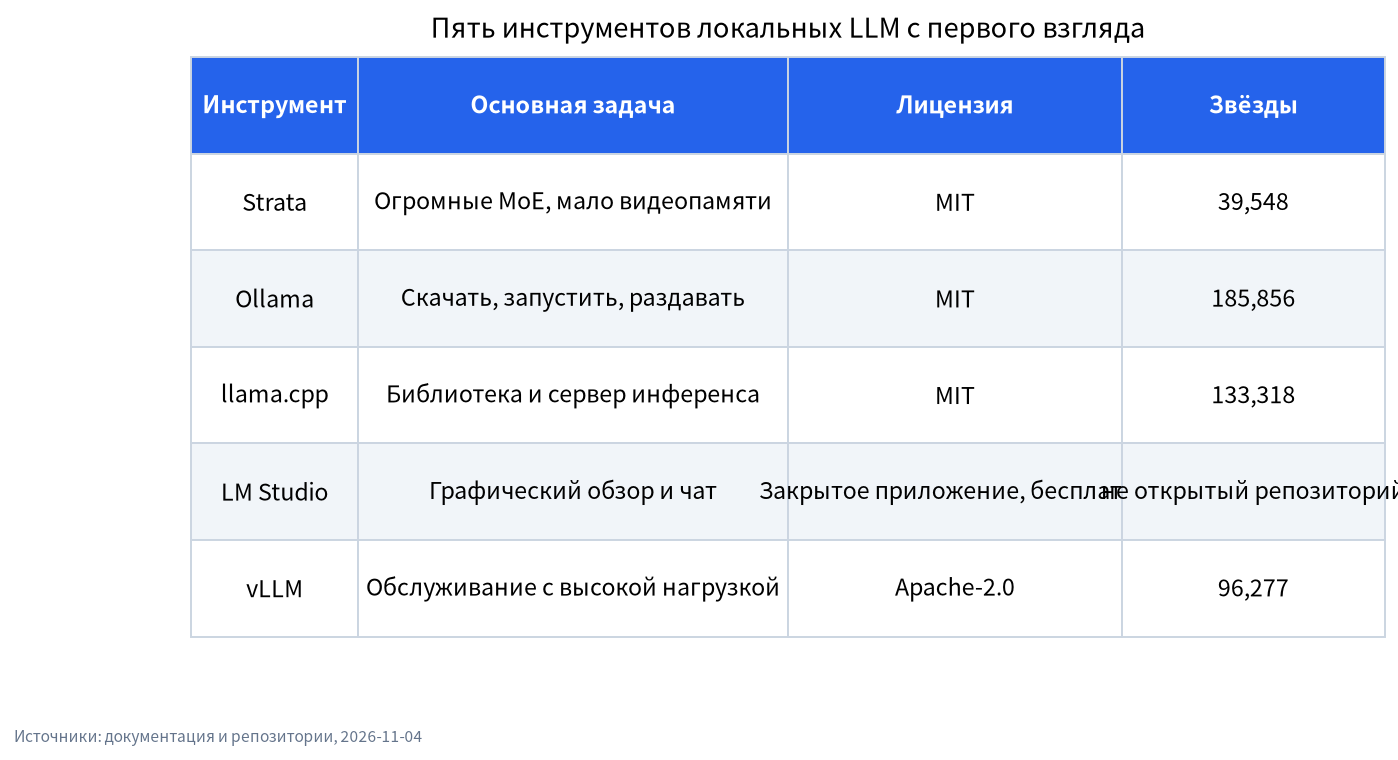
Звёзды измеряют внимание, а не качество. Репозиторию Strata шесть недель; у Ollama были годы, чтобы их набрать. О динамике больше говорят заметки о релизах: Strata выпустил шесть версий с 25 октября по 2 ноября, а v0.40.14 Ollama появилась 3 ноября.
Что каждый делает хорошо и на что смотреть
| Инструмент | Силён в | На что смотреть |
|---|---|---|
| Strata | Очень большие MoE-модели на картах 12–24 ГБ, установка в один клик, strata connect для агентов программирования |
Мало поддерживаемых моделей, молодой проект, длинные промпты медленные на картах 12 ГБ (PC Watch), нет внешнего аудита безопасности по его документации |
| Ollama | Простота, большая библиотека моделей, огромная экосистема, ollama launch для инструментов программирования, MLX на Apple Silicon с v0.40.0 |
Не рассчитан на чтение MoE-модели 125B из ОЗУ и с SSD; рядом с локальным использованием существуют необязательные облачные модели и платные тарифы |
| llama.cpp | Широкая поддержка железа, форматы квантования, тонкий контроль; поддержку Qwen3.8-Flash-Next добавил pull request #27742, влитый 2026-08-27 | Больше опций, которые нужно изучить; конфигурацию вы собираете сами |
| LM Studio | Дружелюбный интерфейс, движки llama.cpp и MLX, умеет работать без окна через lms |
Приложение с закрытым кодом; соблюдайте его условия, если встраиваете в продукт |
| vLLM | Пропускная способность при множестве параллельных запросов | Требует видеопамяти под всю модель; не рассчитан на карту 12 ГБ |
Собственный репозиторий vLLM находится на github.com/vllm-project/vllm. Для более подробного разбора трёх самых распространённых инструментов см. наше руководство Ollama, LM Studio и llama.cpp, а о vLLM — наше введение в vLLM и SGLang.
Поддержка Qwen3.8-Flash-Next в том виде, как нам удалось её проверить
Именно эта модель стоит за большей частью шума вокруг Strata, поэтому будем точны. Всё ниже датировано 2026-11-04.
- Strata: создан под неё (список моделей). В документации четыре квантования: от 37,6 до 54,8 ГБ ОЗУ плюс видеопамяти.
- llama.cpp: pull request #27742 «model: add Qwen3.8-Flash-Next (qwen4exp)» влит 2026-08-27. Один пользователь Hacker News сообщил, что llama.cpp выдаёт около 21 ток/с против примерно 60 ток/с у Strata на конфигурации AMD. Это частный случай, а не тест, за который мы можем ручаться.
- Ollama: на её странице библиотеки для
qwen3.8-flash-nextбыл один тег,125b-mlx(105 ГБ, для Apple Silicon). Запрос на функцию закрыт 2026-10-17. Тега для видеокарт NVIDIA мы не нашли и не проверяли, поэтому мы не утверждаем, что Ollama не может её запустить, — только что не нашли документированного пути. - LM Studio и vLLM: мы не проверяли.
Как каждый инструмент справляется с моделью больше вашей видеопамяти
Здесь инструменты различаются по-настоящему. Когда модель не помещается на карту, Ollama и llama.cpp обычно делят её по слоям: часть слоёв считает GPU, остальное — CPU, а веса лежат в ОЗУ. Для плотных моделей это работает хорошо и является обычным путём на небольших картах. MoE-модель устроена иначе, потому что на токен нужны лишь несколько экспертов. В llama.cpp есть опции, которые оставляют экспертов на стороне CPU (семейство опций --cpu-moe), и один пользователь Hacker News сообщил о 16 ток/с с файлом Q8_0 на машине со 192 ГБ ОЗУ при таком подходе. Strata идёт на шаг дальше: держит на GPU кэш самых востребованных экспертов, остальных считает на CPU прямо там, где они лежат в ОЗУ, а недостающее может читать с SSD. Получается инструмент, который хорошо делает одно, ценой поддержки лишь нескольких моделей. vLLM, напротив, исходит из того, что вся модель живёт в памяти GPU, поэтому он подходит скорее для серверов, чем для настольной карты на 12 ГБ.
Как читать заявления о скорости
Большинство статей «Strata быстрее» сравнивают разные модели. Японский блогер, автор теста на RTX 3060, поставил 44,49 ток/с Strata на модели 125B рядом с результатами Ollama на моделях 9B и 26B на том же ПК, а затем прямо написал, что эта таблица не показывает, быстрее или медленнее Strata, чем Ollama. Тест arm1.ru сравнивал Strata с Flash-Next и llama.cpp с другой моделью — Qwen3.8-27B. Честное сравнение требует одной и той же модели, квантования, контекста, железа и версии ПО; ни одного, который выполнял бы это полностью, мы не нашли. Пока такого нет, читайте скорости как «что этот инструмент показал на этой модели», а не «какой инструмент быстрее». Читайте источники: тест на note.com, arm1.ru и тему на Hacker News.
Подсказка по выбору
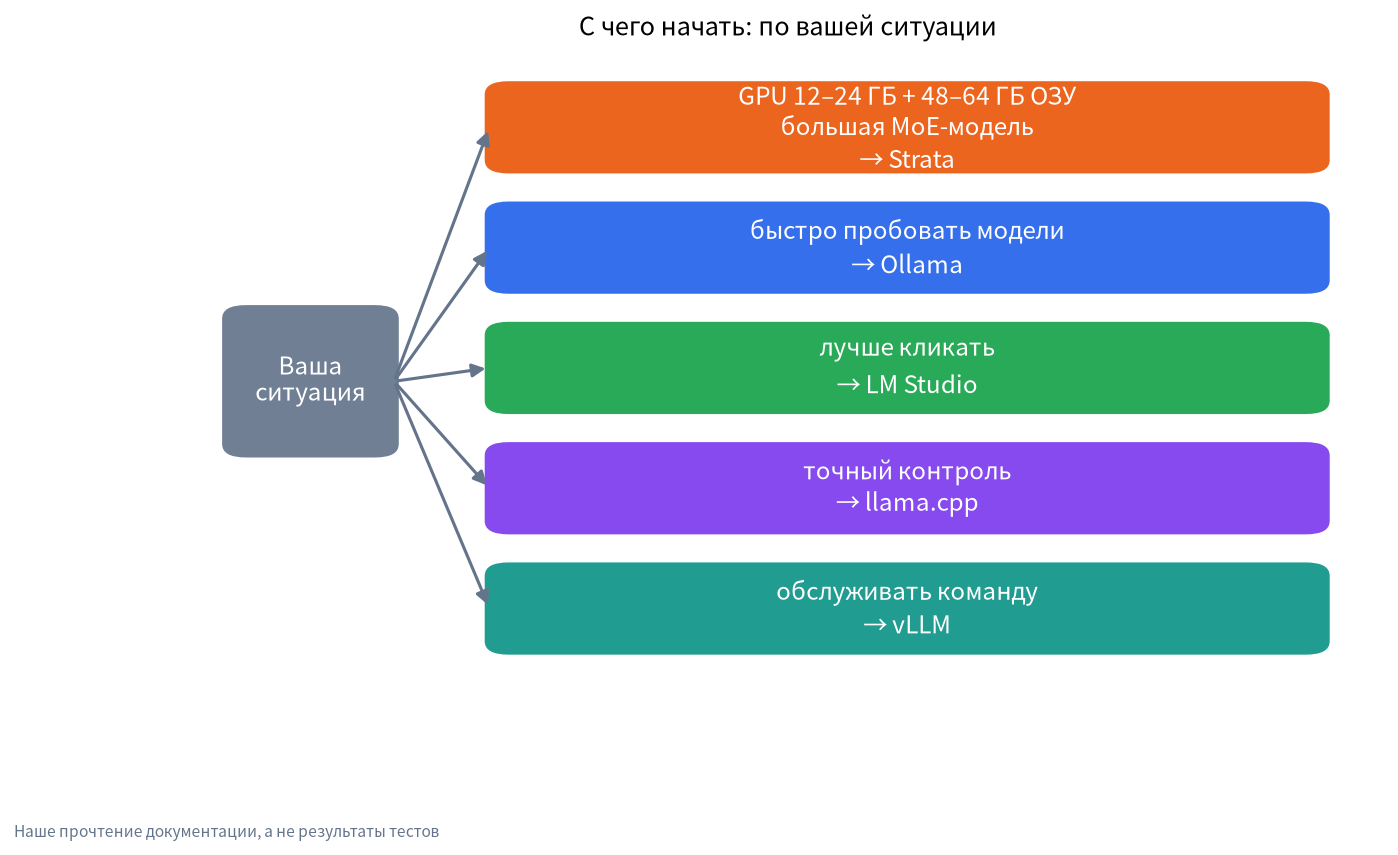
| Ваша ситуация | С чего начать | Почему |
|---|---|---|
| GPU NVIDIA или AMD 12–24 ГБ, 48–64 ГБ ОЗУ, нужна Qwen3.8-Flash-Next | Strata | Он создан для этой модели и такого распределения памяти |
| Хотите быстро попробовать много моделей или подключить Open WebUI | Ollama | Самая простая установка и самая большая экосистема; см. наше руководство по установке Ollama |
| Лучше кликать, чем печатать | LM Studio | Графический обозреватель моделей; см. наш учебник по LM Studio |
| Нужен точный контроль над опциями, квантованием или сборками | llama.cpp | Ближе всего к железу |
| Обслуживаете команду с GPU-сервера | vLLM | Создан для параллельных запросов |
| Есть Mac с большим объёмом единой памяти | Сначала Ollama или LM Studio | Оба используют MLX на Apple Silicon; Strata тоже поддерживает macOS 15 и новее |
Ничто не мешает использовать два инструмента. Многие оставят Ollama для повседневных моделей и добавят Strata для одной большой; помните лишь, что обоим нужны те же видеопамять и ОЗУ. Практические шаги — в нашем руководстве по установке Strata рядом с Ollama, а цифры по памяти — в нашей статье о системных требованиях.
Лицензии, данные и стоимость
Движки открыты (MIT или Apache-2.0), но у весов моделей свои лицензии; Qwen3.8-Flash-Next использует Qwen Community License 1.0, так что прочтите её, если планируете коммерческое использование. В документах Strata сказано, что телеметрии и учётных записей нет; Ollama запускает локальные модели без входа и, по заметкам о релизах, также предлагает необязательные облачные модели и платные тарифы; условия LM Studio разрешают личное и рабочее использование, но не перепродажу и не размещение как сервис. Действующие условия всегда проверяйте сами.
Что мы сделали и чего не делали
2026-11-04 мы прочитали репозиторий, заметки о релизах и документацию каждого проекта, а также сторонние отчёты, на которые даны ссылки выше. Мы не устанавливали ни один из пяти инструментов для этой статьи и не измеряли ни одной скорости. Если утверждение исходит от одного пользователя, мы так и пишем.
Частые вопросы (FAQ)
Strata быстрее Ollama?
Сказать не можем. Опубликованные сравнения в основном используют разные модели и потому не отвечают на вопрос. По словам тестеров, Strata может запускать MoE на 125B со скоростью несколько десятков токенов в секунду на карте 12 ГБ, но это другая задача, чем запуск модели 9B в Ollama.
Может ли Ollama запустить Qwen3.8-Flash-Next?
2026-11-04 в библиотеке Ollama был один тег MLX на 105 ГБ для Apple Silicon. Документированного пути для видеокарт NVIDIA мы не нашли и не проверяли, поэтому смотрите страницу библиотеки для вашей платформы.
Какой инструмент лучше для новичка?
Ollama или LM Studio. Оба ставятся за несколько минут и имеют больше всего руководств. Добавьте Strata позже, если захотите одну очень большую модель.
Strata построен на llama.cpp?
В его документации ggml, тензорная библиотека, на которой построен llama.cpp, указана как сторонний компонент, но Strata — отдельный движок на C++ со своим планировщиком. Он не описан как форк llama.cpp.
Что лучше для обслуживания команды?
vLLM, если у вас хватает видеопамяти под всю модель. Настройка Strata по умолчанию подгоняет параллельные запросы под вашу карту (один на GPU 12 ГБ), так что карта на 12 ГБ рассчитана на одного пользователя, а не на команду.
Нужно ли удалять Ollama, чтобы попробовать Strata?
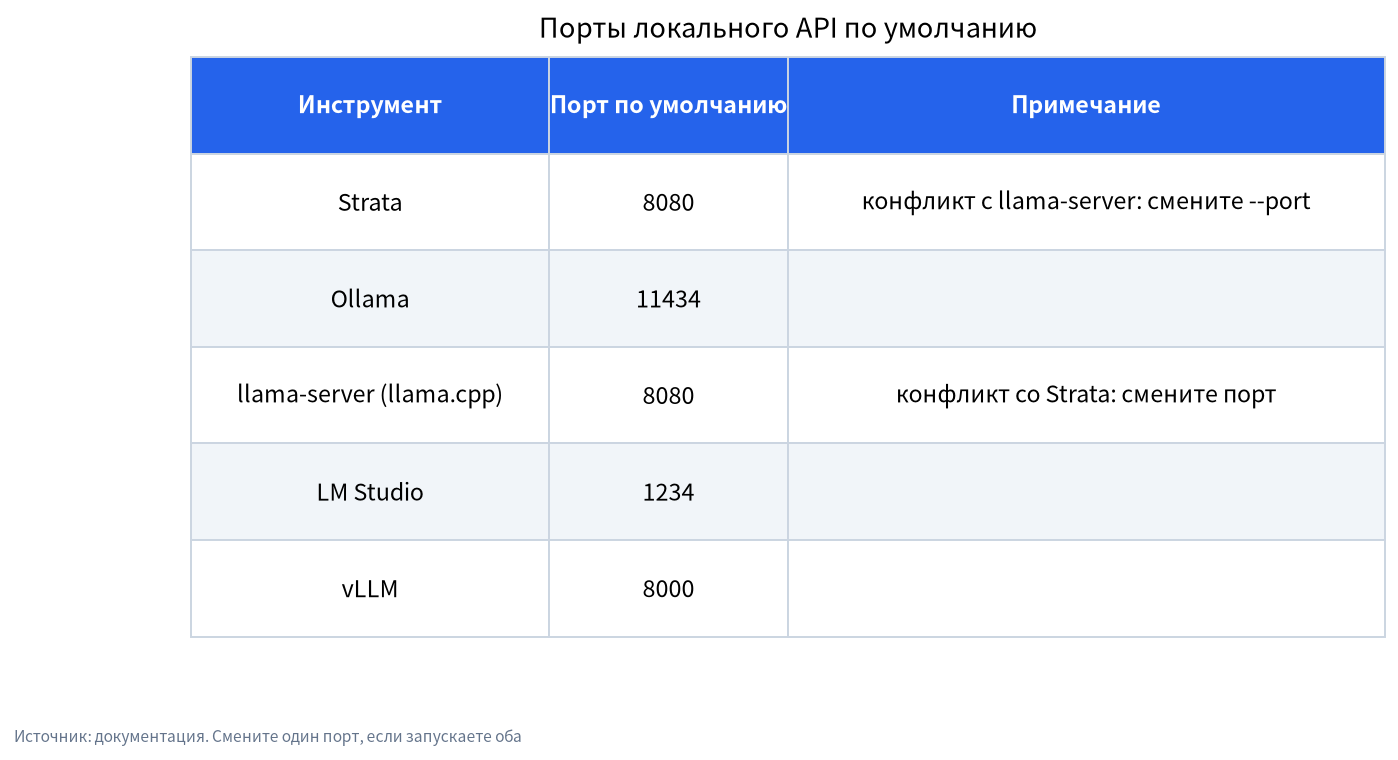
Нет. У них разные порты по умолчанию и разные папки моделей. Просто не загружайте две большие модели в один GPU одновременно.
Давайте обсудим
Не знаете, какой инструмент подходит вашей видеокарте и бюджету? Присоединяйтесь к сообществу или напишите на admin@microaione.com, указав GPU, ОЗУ и задачу. Если вы предпочитаете машину, собранную и проверенную под это, загляните в руководство по машинам и решениям.