本地部署的大模型怎么训练:LoRA 入门、显存账与常见坑
「本地部署的大模型怎么训练」几乎是私有化咨询里出现频率最高的问题之一。很多人默认“训练=从零预训练”,于是立刻开始搜千卡机房;对个人与绝大多数公司团队来说,真正可落地的是:选一个开放权重基座,用自己的高质量数据做 LoRA/QLoRA 微调,再在本地推理栈里加载适配器。本文只讨论合法、合规的微调教育向流程——改变语气、格式、行业术语——不提供任何越狱、去安全对齐或绕过拒绝策略的训练配方。
核对说明:显存数字按公开论文与常用经验公式估算,不是我们的实测;数据量区间是启发式;硬件档位与AI 训练电脑配置、本地 LoRA 显存、私有化训练部署互为补充。涉及企业数据时,先完成授权与脱敏评审。
要点速览(更新于 2026-11-05)
- 先分清四级:提示词 → RAG → LoRA/QLoRA → 从零预训练;多数“本地训练大模型”停在第三级。
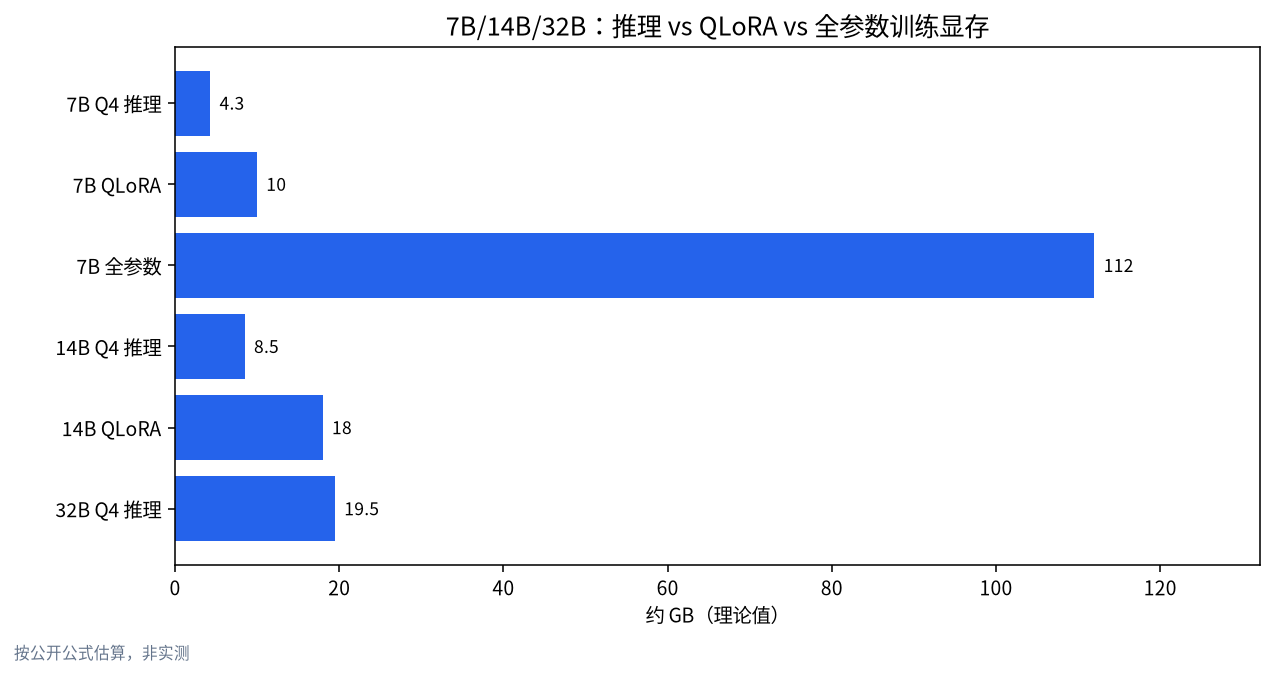
同一 7B:Q4 推理约数 GB;QLoRA 常可单卡;全参数训练按“每参数约 16 字节状态”估算会到百 GB 量级。
数据质量远比“堆十万条垃圾”重要;先做评测集,再开训。
- 训练配置见 A87;推理装机见三套预算配置。
本地部署的大模型怎么训练:先选对层级
| 层级 | 你在改什么 | 典型数据 | 算力 | 何时足够 |
|---|---|---|---|---|
| 提示词与规则 | 口径、格式、禁用词 | 几十条示例 | 仅推理 | 统一话术 |
| RAG | 可检索的知识 | 文档库 | 推理+向量化 | 制度/知识问答,见本地知识库 |
| LoRA/QLoRA | 行为与风格 | 千到万级精标 | 单卡到数卡 | 固定输出结构、行业语气 |
| 从零预训练 | 基座本身 | 海量 token | 集群 | 基础模型厂商的事 |
若你的痛点是“模型不知道我们公司今年的制度”,优先 RAG,而不是微调。微调擅长“怎么说”,不擅长“记住天天变的事实”。
显存账:推理、QLoRA、全参数差多少
「训练大模型需要什么配置」取决于你做哪一层。下面用公开近似帮助建立数量级(未含全部激活与框架开销):
| 规模 | Q4 推理(约) | QLoRA 微调(量级) | 全参数训练状态(约 16 字节/参数,不含激活) |
|---|---|---|---|
| 7B | ~4.3GB | 常见单张 12–24GB 可尝试 | ~112GB |
| 14B | ~8.5GB | 更常见 24GB+ | ~224GB |
| 32B | ~19.5GB | 往往要 48GB 级或更聪明的并行 | ~512GB |
实践建议:个人学习 LoRA,从 7B/8B 基座 + 单张 24GB 开始;把“一上来就全参数硬训 70B”当成预算自杀。更细的装机见AI 训练电脑配置;偶尔训一次可租 GPU。
数据:本地训练大模型真正的瓶颈
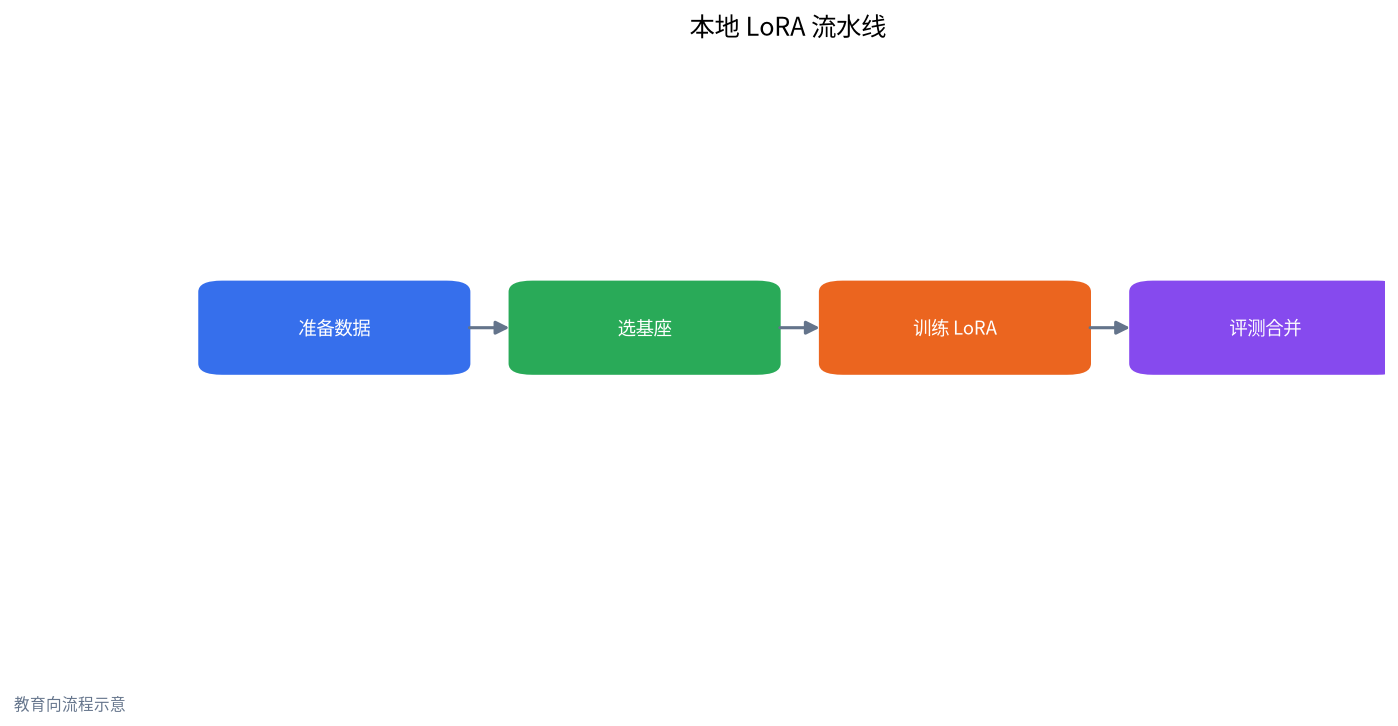
没有评测集就开训,等于无仪表盘开车。最小可行流程:
- 冻结一份评测集(几十到几百条),含你在意的格式、术语与拒绝边界(合法业务边界,不是越狱)。
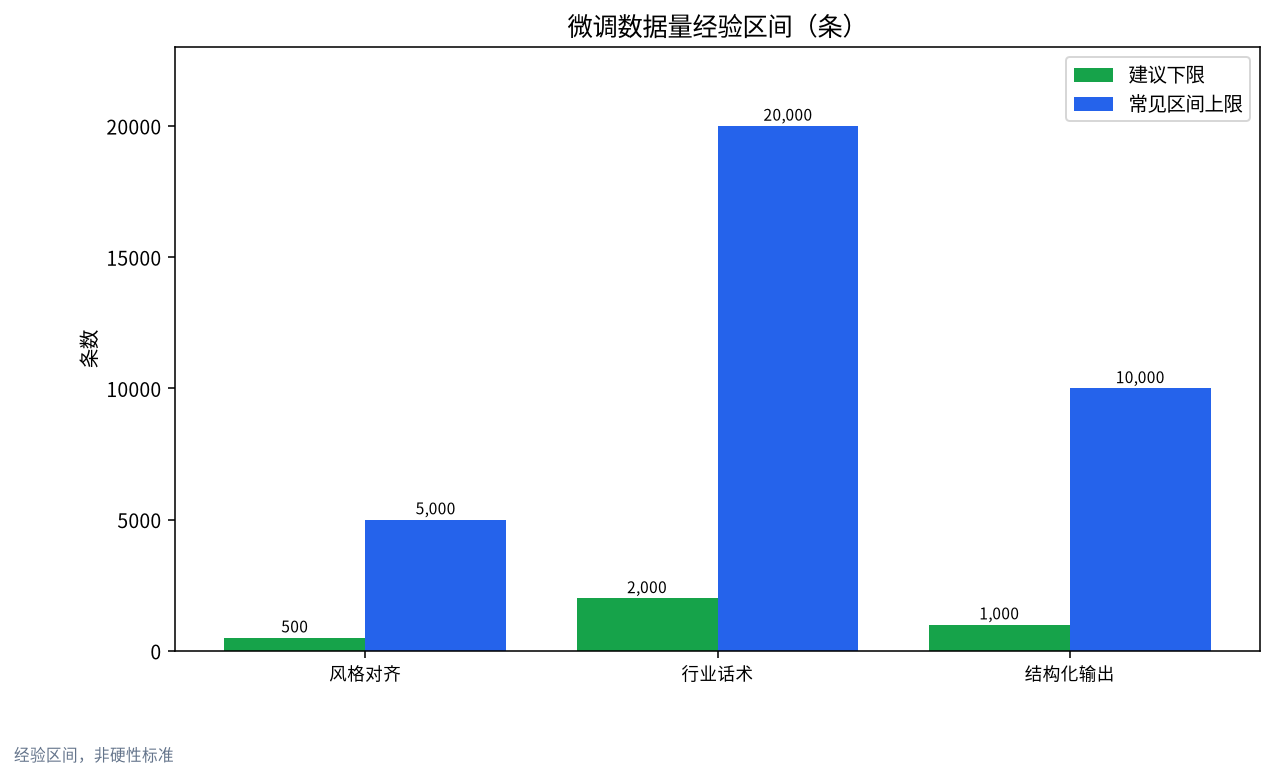
- 训练集约 500–20,000 条,按目标而定:风格对齐偏少但要干净;行业话术需要覆盖场景;结构化输出要有严格 schema。
- 去重、脱敏、授权:客户合同、身份证号、内部未公开数据不得未经审批进入训练集。
- 人类抽检:随机开 50 条,看是否像你会发给同事的示范。
LoRA 入门:概念用一句话记住
全参数微调改整个权重;LoRA 在旁路插入低秩矩阵,训练结束后可合并或作为适配器加载。QLoRA 把基座量化后做 LoRA,显存更省,是个人「本地训练大模型」的主流入口。你需要理解的工程点只有几个:基座选型、学习率与步数别盲目抄、定期在评测集上看分、保存可复现的随机种子与配置文件。
工具链常见组合:PyTorch + 主流微调框架 / 厂商脚本;推理侧再用 Ollama、llama.cpp、vLLM 或 Strata 加载。Windows 用户若只想先跑通推理,可看无命令行安装;训练仍更建议 Linux 或 WSL2 的成熟环境。
常见坑(我们反复见到的)
- 用 RAG 能解决的问题去微调:知识一更新又要重训。
- 没有持有集,只看训练 loss:loss 下降不等于业务变好。
- 把“更听话”理解成“去掉安全拒绝”:这既危险也不在本文范围内;合规风险见未审查模型合规风险。
- 上下文与批次盲目加大:显存爆炸或吞吐崩掉。
- 合并适配器后忘记回归测试:聊天变好了,工具调用或 JSON 模式坏了。
- 硬盘与检查点管理混乱:半成品权重堆满磁盘,见存储指南。
最小实验计划(周末可完成)
- 选 7B/8B 开放权重基座,确认许可证允许你的用途。
- 准备 800 条干净指令数据 + 100 条评测。
- 在单张 24GB 上跑 QLoRA,记录超参。
- 在评测集上对比基座 vs 适配器:格式成功率、术语正确率、拒答是否仍符合政策。
- 只有指标变好,才考虑扩数据或换 14B。
超参与训练过程:少调、勤看评测
新手最容易陷入“把学习率、LoRA rank、dropout 全部扫一遍”。更稳的做法是:先固定一份官方或社区验证过的起点配置,只改数据;每一轮只动一个主要旋钮,并在同一评测集上对比。记录下:步数、耗时、峰值显存、评测集格式成功率、人工抽检通过率。若指标不动,先检查数据标签是否自相矛盾,而不是立刻上更大模型。
检查点(checkpoint)建议按固定间隔保存,并保留“目前评测最好”的一份,避免只留最后一步。训练中断后应能从检查点恢复;随机种子、容器镜像或 pip freeze 要一并归档,否则三个月后无法复现。
评测集怎么设计才有用
好的评测集至少覆盖四类题目:一是你最在意的标准问法;二是边界情况(缺字段、口语化、多轮追问);三是必须保持的安全与合规拒答(合法业务政策,例如不提供违法操作指引);四是回归题——基座本来就会、你不能训坏的能力。每类不必很多,但要稳定。不要把训练集原样复制进评测集,否则你只是在考记忆。
自动化指标可以先从“能否解析为合法 JSON”“关键词是否出现”“是否仍拒绝某类违规请求”做起,再辅以人工 Likert 打分。企业场景还应加上权限角色差异:同一问题,不同角色看到的答案边界不同。
推理侧加载:训练完只是一半
适配器训完后,要在你真实的推理栈里加载:API 服务器、Web UI、还是 IDE 插件。确认 tokenizer、对话模板(chat template)与基座一致,否则会出现“训练分很高、线上胡言乱语”。合并权重与“基座+适配器运行时加载”各有利弊:合并简单,多适配器场景则运行时加载更灵活。上线前用同一批提示做盲测,避免只看 loss 曲线。
若你服务的是部门用户,还要准备回滚开关:一键回到纯基座或上一版适配器,并留下变更说明。这与企业私有化里的版本治理是同一逻辑。
与推理装机、企业流程的衔接
个人把适配器挂到本地推理即可;部门级还要版本管理、回滚、权限与审计,见企业内容安全清单与企业定制私有化。一体机是否内置训练能力,见一体机对比。
我们怎么核对,没做什么
本文不提供可复制的“去对齐”数据集,不承诺某一框架的逐行教程长期不变,也不替代法律意见。显存表是理论量级;你的驱动、上下文长度与框架版本都会改变结果。
补充核对与阅读建议
为满足完整阅读体验,建议你把本文与显存、装机、私有化相关文章对照着看:先确认自己的任务与显存量级,再决定工具与模型,最后才谈训练或企业治理。把关键提示词、模型文件名与评测结果留在同一笔记里,两周后回看,会比只收藏链接更有用。若你的环境有特殊合规要求,以法务与安全团队意见为准,本文只提供技术向科普。
本地部署的长期价值,往往不在“一次跑通”,而在“可重复、可回滚、可解释”。无论你选免费工具还是企业方案,都把变更记录留下:哪天换了哪个权重、谁批准了适配器合并、哪次评测失败。这些记录会让下一次排障便宜一个数量级。若你仍不确定从哪一步开始,先写清三个真实任务,再回到显存表与配置表做选择题,而不是先下单。
实践备忘(字数补强段)
先把任务写清楚,再买硬件;先把评测集准备好,再谈微调;先把权限与许可证读完,再谈对外演示。按照这个顺序,少走的弯路通常比多买的显存更值钱。把每周一次的冒烟测试坚持下来,本地 AI 才会从“新鲜玩具”变成“稳定工具”。对团队而言,指定一名备份负责人,避免唯一懂行的人休假时服务停摆。
常见问题
本地部署的大模型怎么训练才划算?
先确认 RAG 不够用,再做 LoRA/QLoRA;用单卡 7B/8B 证明指标,再放大。
训练大模型需要什么配置?
学习 LoRA:24GB 级显卡更从容;全参数或大模型预训练不是消费级目标。详见 A87。
LoRA 和满血微调差在哪?
LoRA 训练参数少、显存低、更好管理多适配器;满血改动大、成本高,通常留给有集群的人。
要准备多少数据?
看目标:风格对齐可能几百到几千条高质量即可;复杂行业场景常常需要更多,但脏数据堆十万条不如精标五千条。
可以在 Windows 上训练吗?
可以,但驱动与环境坑更多;许多团队用 Linux 服务器或云 GPU 训练,本机只做推理。
微调会不会让模型变得不安全?
任何微调都可能改变拒答与偏见行为。必须用评测集回归安全与业务策略,并遵守法律与平台政策;本文不覆盖恶意用途。
想让我们帮你看训练计划?
欢迎到社区留言,或发邮件到 admin@microaione.com,说明基座、显卡、目标任务与是否可公开评测集结构。深圳团队可以帮你判断该停在 RAG 还是进入 LoRA,并标明估算。
参考资料:QLoRA 论文页面(arXiv)、Hugging Face PEFT 文档、本站本地 LoRA 显存、AI 训练电脑配置。