大模型本地部署需要多大的硬盘?模型文件体积与 SSD、NVMe 怎么选
买电脑或者装模型之前,很多人只盯着显卡,直到下载到一半提示“磁盘空间不足”才想起硬盘。大模型本地部署需要多大的硬盘,答案取决于你准备放多少个模型、每个多大:一个 8B 的量化模型只有 5GB 左右,一个 70B 要 43GB,完整的 DeepSeek-R1(671b)则约 404GB。这篇文章用 Ollama 页面标注的真实文件体积做估算,告诉你 512GB 和 1TB 够不够,机械硬盘、SATA SSD 和 NVMe 在加载模型时差多少,以及什么时候不必为 NVMe 多花钱。
核对说明:模型文件体积来自 Ollama 模型库 deepseek-r1 页面;硬盘速度使用三星 990 PRO(最高约 7,450MB/s 顺序读取)和 870 EVO(最高约 560MB/s)官方标称值,机械硬盘取 150MB/s 的假设值;加载耗时是“文件大小 ÷ 顺序读取速度”的理论下限,下载耗时是“文件大小 ÷ 带宽”的理论值。我们没有实测任何加载或下载,实际时间会更长。
要点速览(更新于 2026-11-04)
- 文件体积(Ollama 标注):8b 约 5.2GB、14b 约 9.0GB、32b 约 20GB、70b 约 43GB、671b 约 404GB。
同时保留 8b+14b+32b+70b 四个模型约 77.2GB,预留 30% 余量后约 100GB;日常只试几个模型,512GB 的盘通常够用,经常换模型建议 1TB。
理论加载时间(70b,43GB):990 PRO 约 5.8 秒、870 EVO 约 76.8 秒、机械硬盘(假设 150MB/s)约 287 秒。加载只发生在每次载入模型时,聊天过程中不再反复读盘。
- 下载往往比读盘更慢:70b 在 100Mbps 带宽下理论需要约 57 分钟,所以多数人的瓶颈在网络,而不是硬盘。
大模型本地部署需要多大的硬盘:先看模型文件有多大
模型文件的体积主要由参数量和量化精度决定。Ollama 默认提供的多是 4 位左右的量化版本,下面是 deepseek-r1 的标注体积,可以当作同类模型的参照:
| 模型 | 文件体积(Ollama 标注) | 大致用途 |
|---|---|---|
| deepseek-r1:1.5b | 约 1.1GB | 体验、低配设备 |
| deepseek-r1:7b | 约 4.7GB | 入门显卡 |
| deepseek-r1:8b | 约 5.2GB | 入门显卡 |
| deepseek-r1:14b | 约 9.0GB | 12GB 显存 |
| deepseek-r1:32b | 约 20GB | 24GB 显存 |
| deepseek-r1:70b | 约 43GB | 大显存或大内存 |
| deepseek-r1:671b | 约 404GB | 服务器级硬件 |
量化为什么能把体积压到这个程度,见量化 Q4_K_M 解读;文件格式见GGUF 与 llama.cpp 入门。经验上,Q4 量化大约是每十亿参数 0.61GB(估算值,不同模型略有差异)。
要预留多少空间:按“模型组合”算
只算当前要用的模型是不够的,因为你多半会试好几个,另外还有系统、软件和临时文件。下面是常见组合的占用估算:
| 场景 | 模型组合 | 文件合计 | 建议预留 30% 后 |
|---|---|---|---|
| 只试一个入门模型 | 8b | 5.2GB | 约 6.8GB |
| 入门加一个中型 | 8b + 14b | 14.2GB | 约 18.5GB |
| 24GB 显卡玩家 | 8b + 14b + 32b | 34.2GB | 约 44.5GB |
| 经常对比各尺寸 | 8b + 14b + 32b + 70b | 77.2GB | 约 100GB |
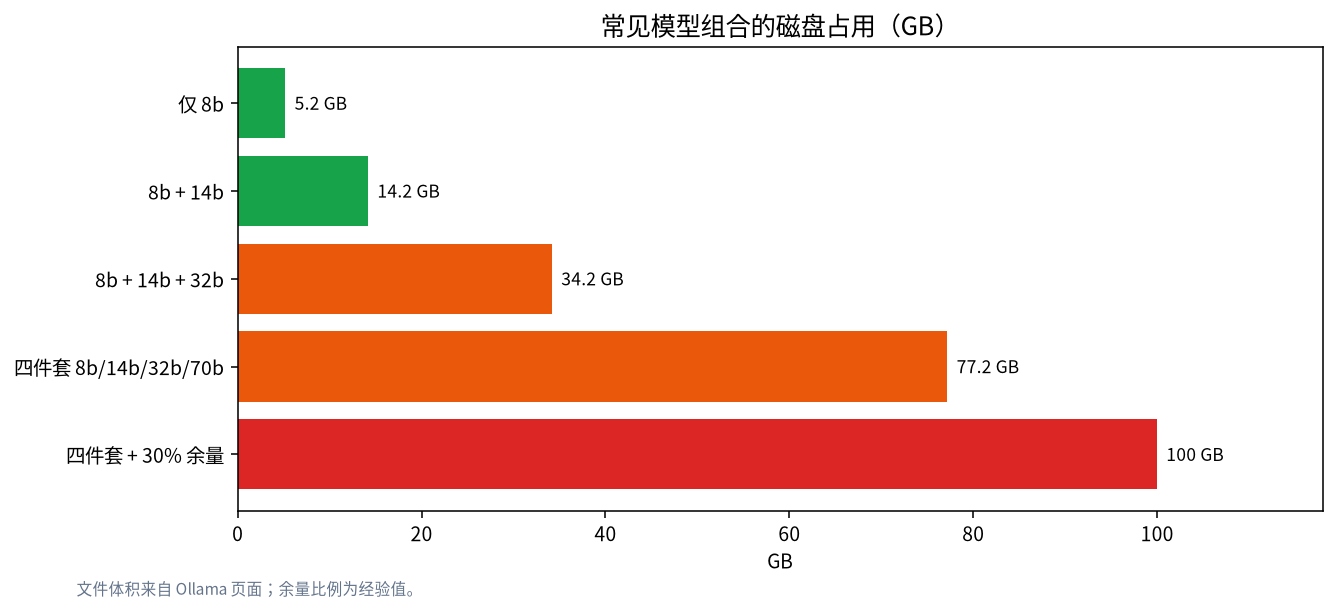
注意这只是模型文件。多数人还会装 Windows 本身、游戏、软件,以及其他工具的缓存。因此:
- 512GB 的系统盘:如果只放 2 到 3 个模型(总计不超过 50GB),通常够用;但如果还有游戏和大量资料,就会比较紧。
- 1TB:放得下四五个中大型模型加上日常使用,是我们更推荐的容量,尤其是打算经常换模型的人。
- 2TB 或更大:只有在你要保存多个 70b 以上的模型,或者会做模型微调、保存多份检查点时才有必要。
硬盘速度影响什么:加载时间的理论估算
硬盘速度只在“把模型文件读入内存或显存”的那一刻起作用。理论加载时间 = 文件体积 ÷ 顺序读取速度。三种硬盘的对比如下(990 PRO 与 870 EVO 为三星官方标称的最高值,机械硬盘 150MB/s 是我们的假设):
| 模型 | 990 PRO NVMe(7,450MB/s) | 870 EVO SATA(560MB/s) | 机械硬盘(假设 150MB/s) |
|---|---|---|---|
| 8b(5.2GB) | 约 0.7 秒 | 约 9.3 秒 | 约 34.7 秒 |
| 14b(9.0GB) | 约 1.2 秒 | 约 16.1 秒 | 约 60 秒 |
| 32b(20GB) | 约 2.7 秒 | 约 35.7 秒 | 约 133 秒 |
| 70b(43GB) | 约 5.8 秒 | 约 76.8 秒 | 约 287 秒 |
| 671b(404GB) | 约 54 秒 | 约 721 秒 | 约 2,693 秒 |
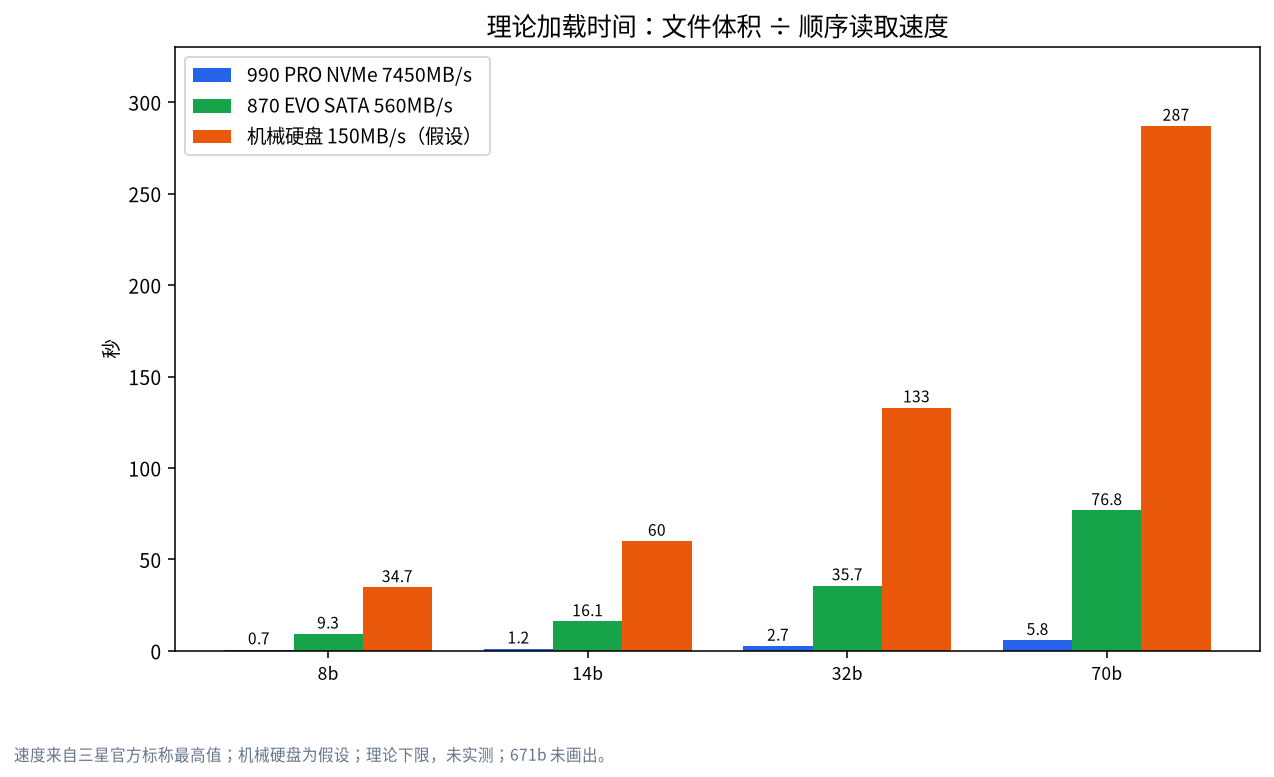
算例:32b(20GB)从 SATA SSD 读入,理论上要 20 ÷ 0.56 ≈ 35.7 秒,换成 NVMe 约 2.7 秒,每次载入模型快了大约 33 秒。如果你一天只载入模型几次,这点差别并不重要;如果你每次都要在多个模型之间来回切换,NVMe 的优势才会变得明显。需要强调:这是理论下限,实际加载还要经过文件系统、内存拷贝和显存上传,实际时间会更长,我们没有实测。
下载比读盘更慢:网络才是第一个瓶颈
下载耗时 = 文件体积 × 8 ÷ 带宽。按 100Mbps 和 500Mbps 估算:
| 模型 | 100Mbps | 500Mbps |
|---|---|---|
| 8b(5.2GB) | 约 6.9 分钟 | 约 1.4 分钟 |
| 14b(9.0GB) | 约 12 分钟 | 约 2.4 分钟 |
| 32b(20GB) | 约 26.7 分钟 | 约 5.3 分钟 |
| 70b(43GB) | 约 57.3 分钟 | 约 11.5 分钟 |
| 671b(404GB) | 约 538.7 分钟(约 9 小时) | 约 107.7 分钟 |
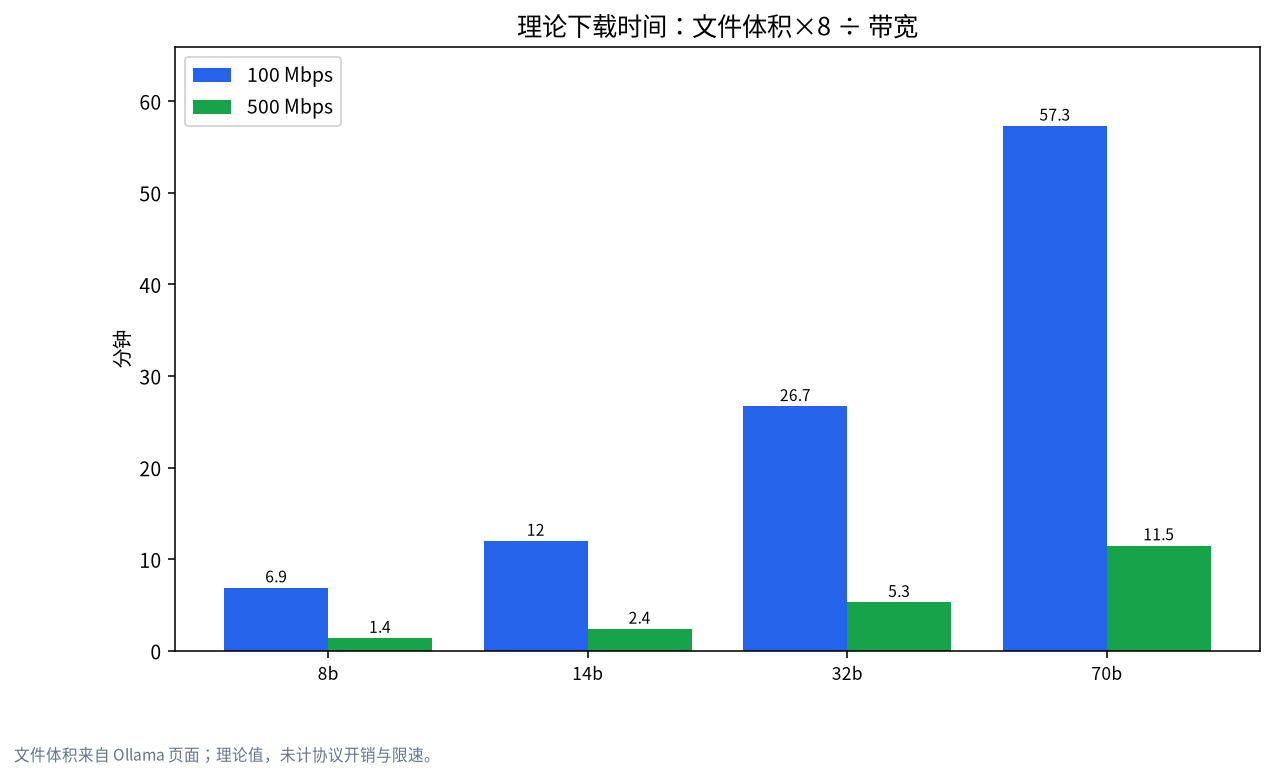
这是理论值,没有计入协议开销、服务器限速或网络波动。可以看到:下载 70b 要花近一个小时,而从 NVMe 读入只要几秒,所以“少下载几次”比“换更快的硬盘”更省时间。把已下载的模型保存好、不要随便重装系统,比换硬盘更实在。下载慢的解决办法见Ollama 下载慢与模型路径。
到底要不要 NVMe
| 你的情况 | 建议 | 理由 |
|---|---|---|
| 只用一两个模型,很少切换 | SATA SSD 或普通 NVMe 都可以 | 加载只发生在载入时,差几十秒影响不大 |
| 经常在多个模型之间切换 | 优先 NVMe | 每次切换节省的时间累积明显 |
| 模型放在机械硬盘 | 不建议 | 理论加载 70b 要近 5 分钟,体验差 |
| 做微调或保存检查点 | NVMe,容量更大 | 写入量大,需要空间与速度 |
| 笔记本只有一个 M.2 槽 | 优先扩容这个槽的容量 | 空间不够时再快也没用 |
要注意的一点:NVMe 不会提高生成速度。模型载入显存之后,生成速度由显存带宽和算力决定,与硬盘无关。如果模型放不进显存,部分放入内存,速度受内存带宽影响,也不由硬盘决定。想了解什么决定生成速度,见显存选购指南。
不同平台的特殊情况
- Windows 电脑:Ollama 的安装程序本身至少需要约 4GB 空间,模型默认保存在用户目录的
.ollama文件夹,系统盘紧张时可以设置OLLAMA_MODELS指向别的盘。 - Mac:统一内存和固态硬盘通常是焊接在主板上,购买后无法扩容,买之前就要估好容量,见Mac 跑本地大模型;外接 SSD 可以存放模型,但速度取决于接口。
- 迷你主机与笔记本:M.2 插槽数量有限,购买前确认空余槽位,配置思路见大内存迷你主机与本地大模型整机配置。
模型文件之外,还有哪些东西占空间
很多人只算了模型,却忽略了这些:
- 运行环境:Ollama 的安装程序至少要约 4GB;如果用 Docker,镜像与数据卷还会额外占用,记得定期清理不用的镜像。
- 知识库与向量数据:如果搭建本地知识库(见本地 RAG 知识库),你的文档、切分后的文本和向量索引都要保存,占用与资料量成正比,需要按你的资料实际体积评估。
- 微调与检查点:做微调时每保存一个检查点就是一份文件,保存多份很快占满空间,这类场景才需要更大的容量。
- 多个工具各存一份:Ollama、LM Studio 等工具默认各有自己的模型目录,同一个模型可能被存两份。
三个预算算例
算例一:入门用户,只想试试。 打算下载 8b 和 14b 两个模型,合计 14.2GB,预留 30% 后约 18.5GB。哪怕是 256GB 的盘也放得下,但建议留足系统与软件空间;这种场景买 SATA 还是 NVMe 都无所谓。
算例二:24GB 显卡玩家。 日常用 14b,偶尔切换 32b 做对比,再留一个 8b 备用,合计 34.2GB,预留后约 44.5GB。1TB 的盘绰绰有余,把“多出来的空间”留给游戏和资料。
算例三:经常对比各尺寸的发烧用户。 四个模型合计 77.2GB,预留后约 100GB,再加上若干 DeepSeek 之外的模型,轻松超过 200GB。这类用户建议单独用一块 1TB 或 2TB 的 NVMe 作为模型盘,既不挤占系统盘,又能把切换时间压到几秒。
怎么把模型挪到另一块盘
在 Windows 上,可以设置环境变量 OLLAMA_MODELS 指向新的目录,重启 Ollama 后新下载的模型就会放到新位置;已下载的模型需要把文件夹内容移动过去。具体的路径设置与下载慢的处理,见Ollama 下载慢与模型路径。移动前先关闭 Ollama,避免文件被占用。
常见误区与隐性成本
- 只看显卡不看硬盘:模型文件的体积很容易吃掉 100GB 以上,买 256GB 的系统盘会很快满。
- 以为 NVMe 能让回答变快:它只缩短加载时间,不改变生成速度。
- 忽略下载带宽:下载时间往往比读盘时间大几十倍到上百倍。
- 把模型放在机械硬盘:可以存档,但不适合经常载入的主力模型。
- 不预留余量:硬盘剩余空间很少时,系统与应用的临时文件也会受影响,建议至少预留约 30%。
- 重复下载:多个工具各自保存一份同一个模型,浪费磁盘,统一模型目录更省空间。
我们怎么核对,没做什么
文件体积来自 Ollama 页面标注,硬盘速度来自三星 990 PRO 与 870 EVO 的官方资料,机械硬盘速度是我们的假设;所有耗时都是按“体积÷速度”算出的理论值。我们没有实测加载与下载时间,也没有测试不同文件系统或杀毒软件对读取的影响。你的实际时间会因系统和网络而不同。
常见问题
大模型本地部署需要多大的硬盘?
只试一两个入门模型,10GB 以内就够;同时保留 8b、14b、32b、70b 四个模型约 77.2GB,预留 30% 约 100GB。日常使用建议 1TB。
512GB 的硬盘够不够本地部署大模型?
如果只放两三个模型(合计不超过 50GB),且没有大量游戏和资料,通常够用;经常换模型建议 1TB。
本地部署大模型要不要用 NVMe?
不是必需。NVMe 缩短的是模型载入时间,例如 32b 从 SATA SSD 载入理论约 36 秒,NVMe 约 3 秒;生成速度不受硬盘影响。
模型可以放在机械硬盘吗?
可以存放,但载入慢。假设 150MB/s,70b 载入理论约 287 秒,不适合经常切换的模型。
DeepSeek 671b 完整版需要多大硬盘?
Ollama 标注约 404GB,加上余量建议 1TB 以上,并且需要服务器级的显存或内存才能运行。
模型能存放到外接硬盘吗?
可以,通过设置 OLLAMA_MODELS 等方式指定目录,但载入速度取决于外接硬盘的接口与速度。
想按预算配一台电脑?
欢迎到社区交流,或发邮件到 admin@microaione.com,告诉我们你打算放几个模型、预算多少。我们的深圳团队会帮你列出内存、显存与硬盘的配置建议,并如实标明估算部分。
参考资料:Ollama 模型库:deepseek-r1、三星 990 PRO 系列资料、三星 870 EVO 资料、Ollama:Windows 文档。