
本地大模型是什么?和在线 AI 的区别、适合谁
核对说明:本文的文件大小、许可证和官方说明,于 2026 年 10 月 30 日对照 Ollama 模型库、Hugging Face 模型页和 Ollama FAQ 核对。文中没有自测跑分;对比表里的“成本”只描述结构差异,不给具体价格,具体测算见《本地部署 vs 在线 API》。
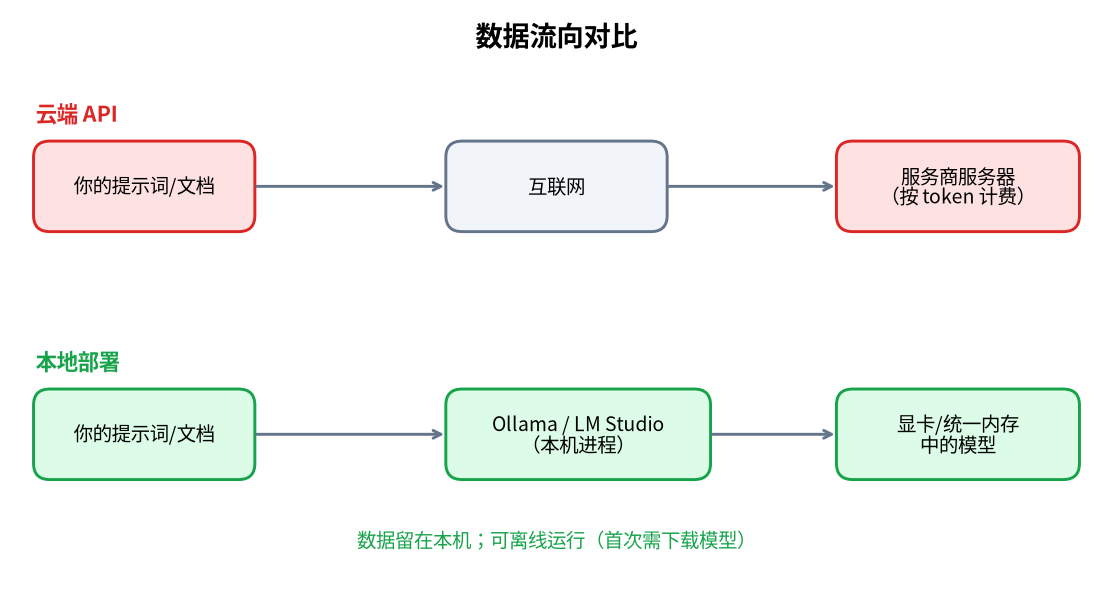
本地大模型是什么? 简单说:它是一个可以下载到自己电脑上运行的大语言模型(LLM)。你的提问在本机的显卡或内存里完成计算,答案也在本机生成,不必把内容发送给任何服务商。常见的 Qwen、Gemma、gpt-oss、DeepSeek 等“开放权重”模型,都可以这样使用。
这个概念听起来简单,但中文互联网上同时流行着“本地大模型”“离线大模型”“端侧大模型”“私有化部署”等说法,容易混淆。本文先把术语一次讲清,再讲它和在线 AI 的区别、能做什么、不能做什么、适合哪些人,最后告诉你需要什么硬件、怎么迈出第一步。
本地大模型是什么意思:本地、离线、端侧、私有化怎么区分
| 说法 | 核心含义 | 典型场景 | 是否必须断网 |
|---|---|---|---|
| 本地大模型 | 模型运行在你自己控制的设备上 | 个人电脑、工作站、家里的小主机 | 不必 |
| 离线大模型 | 运行时不依赖网络 | 保密环境、出差、网络不稳定 | 运行时不联网 |
| 端侧大模型 | 运行在手机、平板、笔记本等终端设备上 | 手机上的小模型、AI PC | 不必 |
| 私有化部署 | 运行在企业自己的机房或专属服务器上,供多人使用 | 企业知识库、内部助手 | 不必 |
四者经常交叉:同一台笔记本上的小模型,既是本地的,也是端侧的;断开网线后继续用,就是离线使用。本站后续文章统一使用“本地大模型”指代“在你自己控制的硬件上运行的模型”。
本地大模型是怎么工作的
一个模型,就是一个(很大的)文件
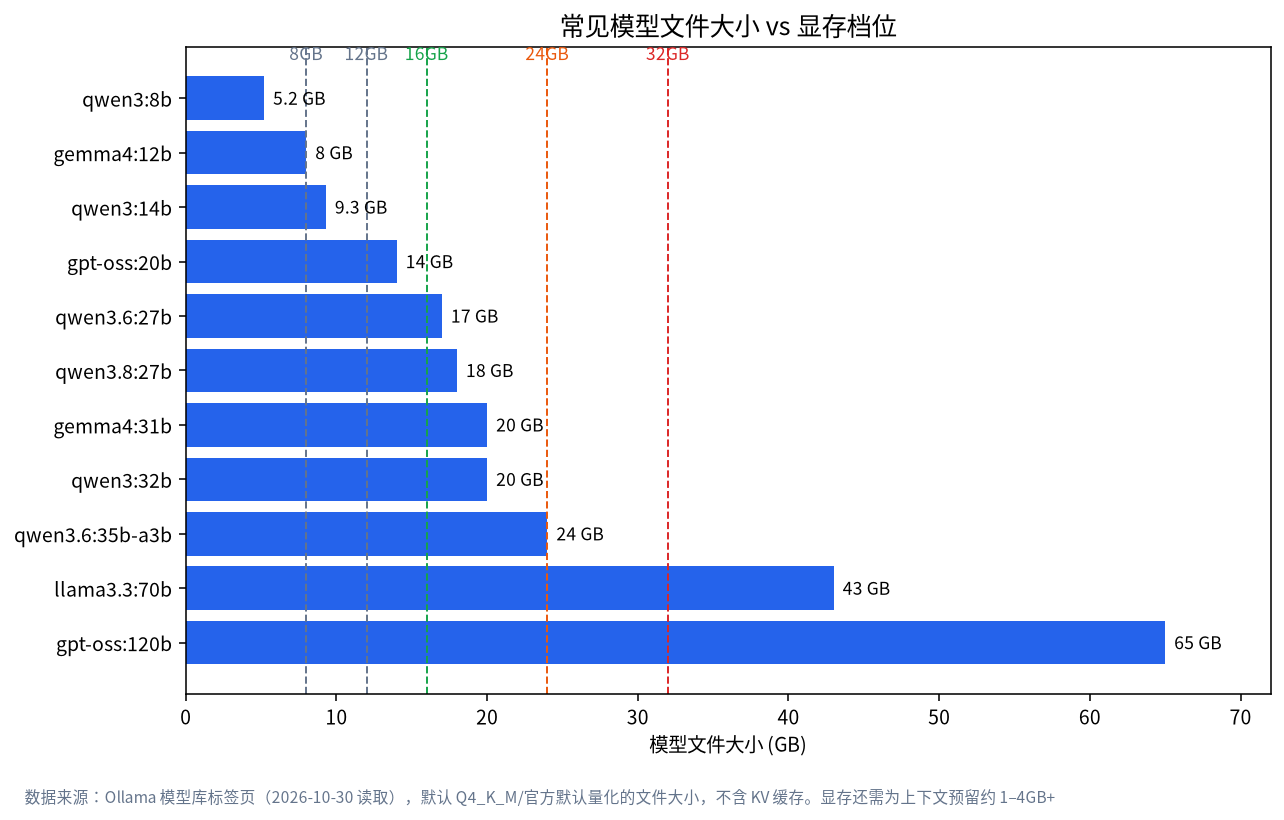
下载到本机的模型是一组训练好的参数文件。以 Ollama 模型库为例(2026-10-30 读取),qwen3:8b 约 5.2GB,gpt-oss:20b 约 14GB,llama3.3:70b 约 43GB。为了让这些文件能在家用设备上运行,通常会做“量化”,也就是降低参数精度来换取更小的体积,详见《大模型量化是什么》。
推理引擎负责“读文件、算答案”
模型文件本身不会自己回答问题,需要一个推理引擎把它加载进显存或内存,再逐个 token 地生成回答。常见的引擎和工具有 Ollama、LM Studio 和 llama.cpp。它们在本机提供命令行、图形界面或本地接口(例如 Ollama 的 http://localhost:11434),其他软件可以像调用云端接口那样调用它。
速度取决于“放得下”和“搬得快”
一个粗略但实用的理解:显存/内存的容量决定模型能不能放下,内存带宽决定生成速度。这也是为什么同样 24GB 的设备,速度可以差很多。更系统的讲解见《显卡与显存怎么选》。
一个假设的例子:用本地模型总结一份保密合同
下面是一个说明用的假设场景,不是真实客户案例。小王是一家公司的法务,手上有一份不能外传的合同,想快速得到条款摘要。
- 他在公司的一台带 24GB 显卡的电脑上安装 Ollama,并下载一个 27B 级别的模型(例如
qwen3.6:27b,文件约 17GB)。 - 他把合同文本粘贴进本地界面,让模型输出条款摘要和风险提示。整个过程中,合同文本只在这台电脑的内存里处理。
- 他把结果当作“初稿”,再自己核对原文,因为任何模型(无论本地还是云端)都可能出错。
这个例子想说明两点:第一,本地模型的价值在“数据不出机”,而不是“比云端更聪明”;第二,无论哪种模型,重要结论都要人工复核。
对本地大模型的五个常见误解
| 误解 | 事实 |
|---|---|
| 本地大模型 = 完全不要钱 | 模型多半免费,但硬件、电费和时间是成本;用量很小时可能比订阅更贵 |
| 本地大模型 = 一定比在线 AI 慢 | 小模型在好显卡上可以很快;大模型放不进显存才会慢 |
| 本地大模型 = 一定更安全 | 只有数据不出本机这一点更有保障;你还需要管好自己的设备、权限和模型来源 |
| 本地大模型 = 和官网同一个模型 | 本地多是缩小或量化版本,规模和能力不同 |
| 本地大模型 = 需要懂编程 | 用 LM Studio 这类图形界面,下载安装即可,见《LM Studio 使用教程》 |
本地大模型和在线 AI 的区别
| 维度 | 本地大模型 | 在线 AI(网页版 / 云端 API) |
|---|---|---|
| 数据去向 | 留在本机(本地模型) | 发送到服务商服务器处理 |
| 能力上限 | 取决于你放得下的开源模型,通常小于最强闭源模型 | 可使用服务商最新最强的模型 |
| 费用结构 | 一次性硬件投入 + 电费,用得越多越摊薄 | 按订阅或按 token 计费,随用量增长 |
| 网络依赖 | 下载模型时需要,之后可离线 | 必须联网 |
| 可控性 | 模型版本、参数、提示词完全自己决定 | 服务商可能升级、限流或下线模型 |
| 维护成本 | 要自己装驱动、更新、排错 | 基本零维护 |
| 速度 | 受硬件限制,小模型很快、大模型可能慢 | 通常稳定且很快 |
| 定制 | 可接入自己的文档、微调、固定版本 | 取决于服务商提供的功能 |
关于数据的一个重要提醒:Ollama 官方 FAQ 说明,本地运行模型时 Ollama 看不到你的提示词和数据;而使用它提供的云端托管模型时,提示词和回答会由其服务器处理。所以“用了 Ollama”不等于“数据一定没出本机”,要看你选的是本地模型还是云端模型。
本地大模型能做什么,不能做什么
比较适合的场景
- 处理敏感资料:合同、病历、内部代码、财务数据,不希望离开本机。
- 本地知识库问答:把自己的文档喂给模型,在本地检索和回答。
- 批量、重复的任务:翻译、摘要、分类、数据清洗。用量大且稳定时,固定成本更容易摊薄。
- 离线或弱网环境:出差、工厂、保密网络。
- 学习与实验:想弄明白模型怎么工作、想试不同的模型和参数。
要有心理预期的地方
- 最强的闭源模型通常更强:在最难的推理、长文档和多模态任务上,本地可跑的开源模型多数仍有差距,差距大小因任务而异,请自己用真实任务试一试。
- 需要硬件投入和一点动手能力:驱动、显存、上下文设置都可能遇到问题,排错见《Ollama 常见报错》。
- “能跑”不等于“好用”:显存不够时,部分模型会落到内存,速度会明显下降。
“开源”到底是什么意思
本地大模型绝大多数是“开放权重”(open-weight)模型:公开了模型参数,可以下载使用,但训练数据和训练代码不一定公开。许可证各不相同,商用前务必读原文。下表是 2026-10-30 在 Hugging Face 模型页上核对的几个例子:
| 模型家族 | Hugging Face 标注的许可证 | 提示 |
|---|---|---|
| Qwen3.6 / Qwen3.8 | Apache-2.0 | 宽松,可商用,仍需保留声明 |
| Gemma 4 | Apache-2.0 | 以官方页面为准 |
| gpt-oss | Apache-2.0 | OpenAI 发布的开放权重模型 |
| DeepSeek-R1 / V4 | MIT | 蒸馏版继承基座模型许可 |
| Llama 3.3 | Llama 3.3 社区许可(自定义) | 有使用条款与限制,商用前请阅读 |
谁适合用本地大模型
| 人群 | 为什么适合 | 建议起点 |
|---|---|---|
| 注重隐私的个人 | 数据不出本机 | 8–16GB 显存,先用 7B–14B |
| 开发者 | 本地接口、可固定版本、调试方便 | 24GB 显存或 32GB 以上 Mac |
| 中小团队 | 内部知识库、避免敏感数据外发 | 先试用现有设备,再评估整机 |
| 爱折腾的玩家 | 乐趣本身 | 现有游戏显卡即可 |
| 只想偶尔问问题的人 | 不太适合 | 直接用在线 AI 更省事 |
如果你属于最后一类,也不必有负担:本地和在线并不互斥,很多人会“日常/敏感任务本地、难题上云”,思路见《本地部署 vs 在线 API》。
需要什么硬件,怎么迈出第一步
一个起点性的对照(来自 Ollama 模型库 2026-10-30 的文件大小,加上第三方估算的经验法则):
| 你的设备 | 大致能跑 | 示例 |
|---|---|---|
| 无独显的普通电脑 | 1B–4B 小模型 | 体验流程 |
| 8GB 显存 | 7B–8B | qwen3:8b(5.2GB) |
| 16GB 显存 / 16GB Mac | 约 14B–20B | gpt-oss:20b(14GB) |
| 24GB 显存 | 27B–32B | qwen3.6:27b(17GB) |
| 48GB 以上 | 70B | llama3.3:70b(43GB) |
最短路径是:安装 Ollama → 运行一条命令 → 与模型对话。具体步骤见《Ollama 安装教程》,配置怎么选见《本地部署大模型入门》。想直接看“哪些模型值得用”,见《本地大模型推荐》。
常见问题(FAQ)
本地大模型是什么?一句话怎么解释?
下载到自己设备上、在本机运行的大语言模型。提问和回答都在本机完成,不必把内容发给服务商。
本地大模型需要联网吗?
下载模型和软件时需要联网,下载完成后运行不依赖网络。注意:如果使用了联网搜索或云端托管模型,则仍需网络,且这部分内容会被相应服务处理。
本地大模型和 ChatGPT 这类在线 AI 比,哪个更好?
没有绝对答案。在线 AI 在最难的任务上通常更强、零维护;本地大模型在隐私、可控、离线和大用量成本上有优势。多数人会按任务混合使用。
本地大模型安全吗?数据真的不外传吗?
只要你运行的是本地模型,并且没有开启联网或云端功能,提示词就在本机处理。Ollama 官方 FAQ 对此有明确说明。但模型文件本身来自网络,请从官方或可信来源下载。
普通笔记本能跑本地大模型吗?
可以跑小模型(1B–4B),速度和效果有限。想要更好的体验,至少需要 8GB 以上显存或 16GB 以上统一内存的 Mac。
本地大模型免费吗?
大多数开放权重模型可免费下载使用,许可证不同,商用请核对。你要承担的是硬件、电费和你自己的时间。
下一步与社区
如果你想把“本地大模型是什么”变成一台真正能用的机器,欢迎先到我们的社区聊聊你的需求和预算(加入社区)。我们在深圳做本地大模型机器的选型、组装与实测,需要时可以给你一份按预算分档的配置建议,不强制购买。
参考来源
- Ollama FAQ(数据与隐私说明)
- Ollama 模型库(模型文件大小,2026-10-30 读取)
- Hugging Face:GGUF 格式说明