Dify 和 RAGFlow 本地部署指南:用 Docker 和 Ollama 搭建团队私有知识库应用
一个人对着几份文档提问,用 Open WebUI 或 AnythingLLM 就够了。可是当团队想要共享的知识库、架在知识库上的客服机器人,或者分好几步调用模型的工作流时,就需要一个应用平台。开源世界里有两个常见选择:Dify 侧重构建 AI 应用和工作流,RAGFlow 侧重解析和检索复杂文档。这篇 Dify 和 RAGFlow 本地部署指南会讲清楚硬件要求、Docker Compose 的步骤、怎样把它们接到 Ollama 或 vLLM 上运行的模型,以及如何在两者之间取舍。建议先读一下本地 RAG 知识库指南。
核对说明:配置要求和命令来自 Dify 的 README 与 Docker Compose 文档、RAGFlow 的 README 与本地模型部署页面,均于 2026-10-30 阅读。写这篇文章时我们没有实际部署这两个平台。两个项目版本更新很快,复制命令前请先确认当前的发布标签;我们对两者特色的描述是对其官方文档的归纳,不是测试结论。
要点速览(更新于 2026-10-30)
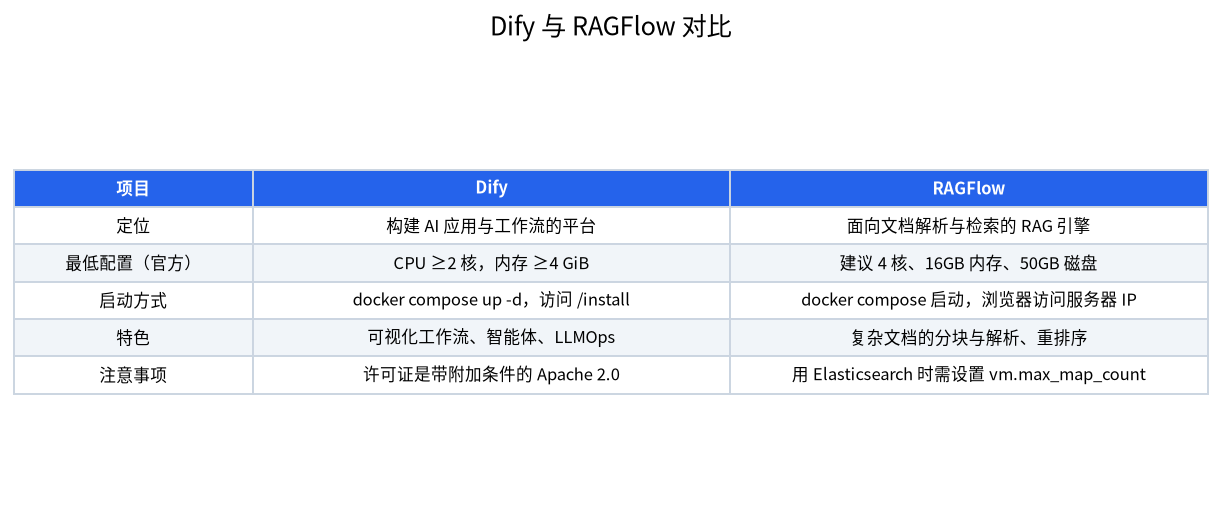
- Dify 文档给出的最低配置是 2 核 CPU 和 4 GiB 内存;RAGFlow 建议 4 核、16GB 内存、50GB 磁盘,并要求 Docker 24.0.0 和 Docker Compose 2.26.1 以上。
两者都是 Docker Compose 部署,并且都使用独立的模型服务器;接到 Ollama 或 vLLM,同时配置对话模型和嵌入模型。
不要把 Ollama 的端口暴露到公网;RAGFlow 官方文档也提醒,发布 11434 端口之前要确认防火墙不允许公网访问。
两个平台各自解决什么问题
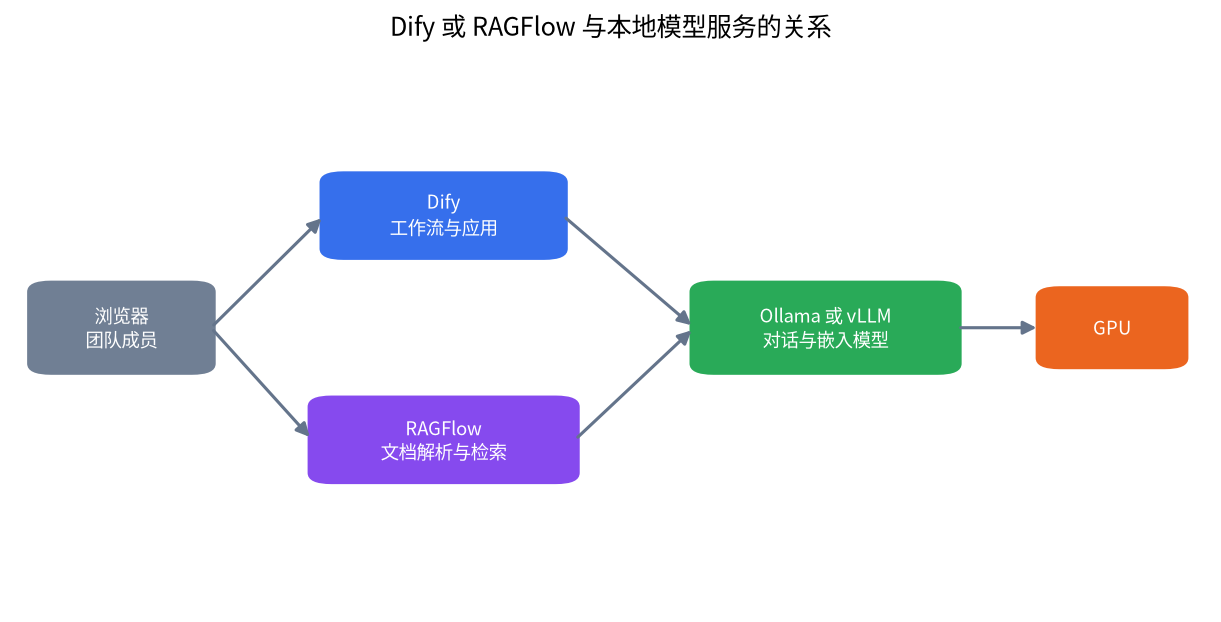
Dify 把自己定位为构建 AI 应用的开源平台。你可以在可视化画布上设计工作流,添加知识库,构建智能体,接入大量模型提供商,并把结果发布成网页应用或 API。RAGFlow 则是一个检索增强生成引擎,重心放在读懂文档:它的 README 强调文档解析、分块和重排序,并说明 1.0 版本里的 DeepDoc 用 CPU 推理来完成版面分析、OCR 和表格识别。简单说,Dify 是更宽的应用构建器,RAGFlow 是更深的文档处理流水线。很多团队会拿同一批文档两个都试一遍,留下答案更满意的那个。
这两个平台本身都不是模型,对话和嵌入都要调用模型服务器,这就轮到 Ollama 或 vLLM 出场了。如果你还在选择模型服务器,可以看vLLM 入门教程和 Ollama 安装指南。
Dify 和 RAGFlow 本地部署的配置要求
| 项目 | Dify | RAGFlow |
|---|---|---|
| 最低 CPU 与内存 | 2 核,4 GiB | 建议 4 核,16GB |
| 磁盘 | 未给出最低要求 | 建议 50GB 可用空间 |
| Docker | Linux 上 Docker 19.03 以上 | Docker 24.0.0 以上 |
| Docker Compose | 2.24.0 以上 | 2.26.1 以上 |
| macOS 说明 | Docker 虚拟机至少 2 个 vCPU 和 8 GiB | 用 Docker Desktop 也可做评估 |
这些数字来自两个项目自己的文档,描述的是平台本身,不含模型。给模型用的显卡是另一回事:平台的容器在 CPU 上运行,所以可以让一台小服务器承载平台,把模型放到有显卡的机器上。模型那一侧的容量可以用显存计算器指南估算。另外,在 RAGFlow 1.0 的文档里,连文档分析模型也跑在 CPU 上,如果要批量解析很多 PDF,核心数要给够。
用 Docker Compose 安装 Dify
Dify 文档建议克隆最新的发布版本,进入 docker 目录,把示例环境文件复制成 .env,然后用 Docker Compose 启动。容器起来之后,在浏览器里打开服务器的安装页面,比如 http://localhost/install,创建管理员账号。命令如下:
git clone --branch <latest-release> https://github.com/langgenius/dify.git
cd dify/docker
cp .env.example .env
docker compose up -d
如果因为查询发布版本返回 null 而克隆失败,按文档说明改用明确的版本号。Dify 的许可证是在 Apache 2.0 基础上增加了附加条件,如果你打算把 Dify 作为服务提供给别人,请先仔细阅读许可证。
用 Docker Compose 安装 RAGFlow
RAGFlow 的 README 要求你先检查一项宿主机设置:如果文档引擎用的是 Elasticsearch,Docker 宿主机上的 vm.max_map_count 至少要是 262144,而且重启后会恢复,需要写进 /etc/sysctl.conf 才能永久生效。README 说明,如果使用它支持的另一个引擎 Infinity,这一步通常不需要。接着克隆仓库,进入 docker 目录,检出 README 里指明的发布标签,再用 Docker Compose 启动。启动完成后,在浏览器里输入服务器的 IP 地址即可,默认的 80 端口可以省略。
用 docker ps 和容器日志确认各个服务都起来了。登录之后,在模型提供商页面添加模型:一个对话模型、一个嵌入模型,以及可选的重排序模型。
连接本地模型服务器
两个平台都支持 Ollama 以及 vLLM 这类兼容 OpenAI 接口的服务器。RAGFlow 的文档给出了典型流程:启动 Ollama,拉取一个对话模型和一个嵌入模型,然后在模型提供商页面用服务器地址添加它们。文档还特别强调,对话模型不是嵌入模型,所以知识库必须另外配一个嵌入模型,它的示例用的是一个小型的 Qwen3 嵌入模型。Dify 里也一样:采用“高质量”索引方式的知识库要用嵌入模型把文本块转成向量,而且 Dify 文档提示,知识库一旦用高质量方式创建,之后就不能切换成经济方式。
因为平台运行在容器里,你填写的地址必须从容器内部能够访问。容器里的回环地址指向容器自己,所以要使用宿主机的局域网地址,或者 Docker 提供的宿主机名称。Ollama 要绑定在可信网络内:RAGFlow 文档提醒,在发布 11434 端口之前,要确认防火墙不允许公网入站访问。想要安全地远程访问,可以参考我们的家用 AI 服务器指南。
规划模型这一侧
平台好不好用,取决于背后的模型,而共享知识库给模型带来的压力比个人聊天大得多。你至少需要两个模型:一个负责写答案的对话模型,和一个把文档与问题转成向量的嵌入模型。嵌入模型小而快;真正需要显存的是对话模型,而且多个用户同时提问会成倍增加上下文所需的内存,vLLM 入门教程里有详细解释。对于五到十人、偶尔提问的团队,一张 16GB 或 24GB 的显卡通过 Ollama 运行 14B 到 32B 的模型,是常见的起点。如果使用更频繁,值得考虑带连续批处理的推理引擎。
还要想好检索步骤每次往提示里放多少上下文。如果知识库每次返回好几段很长的文本块,很容易给每个问题增加几千个 token,所以要相应地设置对话模型的上下文长度,并确认模型真的支持。如果回答看起来无视了检索到的内容,首先要检查的是上下文长度、分块大小,以及嵌入模型是否真正理解你文档所用的语言。
存储、端口和备份
启动之前先规划好磁盘。平台要保存上传的文件、关系数据库、向量或搜索索引和日志,模型服务器还要在磁盘上保存自己的权重。RAGFlow 建议的 50GB 只是起点,不是上限:一万页 PDF 可以生成很大的索引,多放几个模型版本又会多出几十 GB。把 Docker 的数据目录放在速度快的固态硬盘上,因为解析和建立索引非常吃磁盘,从第一周起就要留意剩余空间。
端口也需要同样的关注。两个平台都会在宿主机上监听网页端口,模型服务器有自己的端口。要决定哪些必须能从办公网络访问,哪些只能留在本机。给网页界面前面加一个带 HTTPS 和身份验证的反向代理,比直接开放原始端口安全得多,而模型服务器通常只需要让平台自己访问。最后,给 Docker 数据卷安排备份,并至少在另一台机器上试一次恢复;没试过的备份只是一种希望。
第一天的测试方案
先用一小批有代表性的文档,十到二十份用户真会问到的文件,其中至少有一份带表格的杂乱 PDF。创建知识库,等解析完成,然后看看平台是怎么切分文本的;两个平台都能查看文本块。接着写二十个有标准答案的问题,有些直接引用原文,有些需要改写或综合两段内容。把它们全部跑一遍,把每个答案标成正确、部分正确或错误,同时记下引用的来源是不是对的。每次只改变一件事再重复,比如分块大小、嵌入模型或重排序模型。在选择 Dify 还是 RAGFlow,或者在两个嵌入模型之间取舍时,这张简单的结果表比任何功能列表都有价值。
把这套测试题保存好。平台、模型或文档的每一次升级都可能改变结果,有一份保存下来的问题清单,几分钟内就能发现退步,而不是几周之后。
在 Dify 和 RAGFlow 之间做选择
| 如果你想要 | 优先选择 | 原因 |
|---|---|---|
| 围绕文档搭建聊天机器人或工作流 | Dify | 可视化画布、智能体、丰富的集成 |
| 从扫描件或复杂 PDF 里得到更好的答案 | RAGFlow | 文档解析是它的重点 |
| 在内存很小的服务器上运行 | Dify | 文档给出的最低要求更低 |
| 在同一批文件上两个都试 | 两个依次试 | 用真实问题比较答案 |
| 只给一个人用,越简单越好 | 都不用,选 AnythingLLM 或 Open WebUI | 维护量更小 |
日常运维
团队使用的平台,需要和任何服务器一样的照看。每次升级前,备份保存数据库和向量库的数据卷,并阅读发布说明,因为这些项目变化很快。为用户创建独立账号,在上传敏感文档之前先决定谁能看到哪个知识库。检查你的配置会把什么数据发到外部:如果启用了网页搜索工具、云端模型提供商或遥测,一部分数据就会离开你的网络,我们的隐私指南列出了检查项。最后,用你知道答案的问题测试检索效果,并保留这份清单,以便在每次改动之后对比。
常见错误
- 把对话模型当作嵌入模型。 知识库需要专门的嵌入模型。
- 在容器里使用 localhost。 填写的地址必须能访问到宿主机或模型容器。
- 把 11434 端口或平台暴露到公网。 请使用 VPN 或带身份验证的反向代理。
- 用 Elasticsearch 却跳过 vm.max_map_count。 RAGFlow 的文档引擎可能无法启动。
- 不备份就升级。 两个平台都把状态存在数据卷里,必须保护好。
常见问题
Dify 和 RAGFlow 能完全离线运行吗?
可以,前提是使用本地模型,并关闭云端提供商和网页工具。不过第一次下载镜像和模型时仍然需要联网。
它们需要显卡吗?
平台本身在 CPU 上运行。模型服务器要跑较大的模型并获得不错的速度,则需要显卡。
哪个更容易安装?
两者都用 Docker Compose。Dify 文档给出的最低要求更低;RAGFlow 在使用 Elasticsearch 时需要设置宿主机参数。
两个都能用 Ollama 吗?
可以。两者都能连接 Ollama,RAGFlow 的文档还介绍了 vLLM。
Dify 真的是开源的吗?
仓库使用的是 Dify Open Source License,在 Apache 2.0 基础上增加了附加条件;用于商业用途前请阅读许可证。
嵌入模型该怎么选?
选择支持你文档语言的模型,用样例问题测试,而且尽量不要在之后更换,因为更换之后文档要重新做嵌入。
和我们聊聊
想给团队设计共享知识库?欢迎加入社区,或发邮件到 admin@microaione.com。
参考资料:Dify README、Dify Docker Compose 文档、RAGFlow README、RAGFlow 本地模型指南。