4090 能跑多大的模型?24GB 显存的上限:8B、32B、70B 与 MoE 逐一算清
“4090 能跑多大的模型”看似简单,答案却取决于三件事:量化精度、上下文长度、你愿不愿意把一部分模型放进内存。粗略地说,一张 RTX 4090(24GB 显存)在不依赖内存的情况下,Q4 量化可以放下约 32B 的稠密模型,Q8 约 20B,BF16 约 10B;借助内存卸载可以勉强运行 70B 甚至更大的 MoE 模型,但速度会显著下降。这篇文章把这些结论一步步算出来,并列出每一档的体积、速度上限和适用场景。我们没有在 4090 上逐个实测,所以速度都是由带宽推导的理论上限;体积来自 Ollama 页面和我们此前的计算。
要点速览(更新于 2026-11-04)
- 4090 为 24GB GDDR6X,384 位,带宽 1008 GB/s,满载 450W;实际可用显存约 23.4GB。
留出约 2.4GB 给缓存和运行时后,权重预算约 21GB:BF16 约 10B,Q8_0 约 20B,Q4_K_M 约 34B 参数。
32B Q4 在 8K 上下文时约 22GB,在 16K 时约 24GB,已是单卡极限。
70B Q4 约 43GB,单卡放不下;放一部分进内存,速度上限只有约 4 tokens/s。MoE 模型(例如 122B-A10B、gpt-oss-120b)把专家放内存,速度可用得多,但需要 64GB 至 96GB 以上内存。
两张 4090(共 48GB)可以在 8K 上下文下勉强装下 70B Q4;也可以考虑 5090 32GB 或 96GB 的工作站卡。
4090 能跑多大的模型:先算一个基本公式
权重体积 ≈ 参数量 × 每参数字节数。Q4_K_M 约 0.61 GB 每十亿参数,Q8_0 约 1.0625 字节每参数,BF16 为 2 字节每参数(推导见 Q4_K_M 解读)。
4090 的 24GB 在实际使用中约有 23.4GB 可用,再扣除缓存和运行时开销(我们取约 2.4GB,对应 8K 到 16K 上下文),权重预算约 21GB:
| 精度 | 每参数字节数 | 21GB 能放的最大参数量 | 算式 |
|---|---|---|---|
| BF16 | 2 | 约 10.5B | 21 ÷ 2 |
| Q8_0 | 1.0625 | 约 19.8B | 21 ÷ 1.0625 |
| Q4_K_M | 0.61 | 约 34.4B | 21 ÷ 0.61 |
| 约 2.3 位量化(IQ2 一类) | 约 0.29 | 约 72B | 21 ÷ 0.29,质量明显下降 |
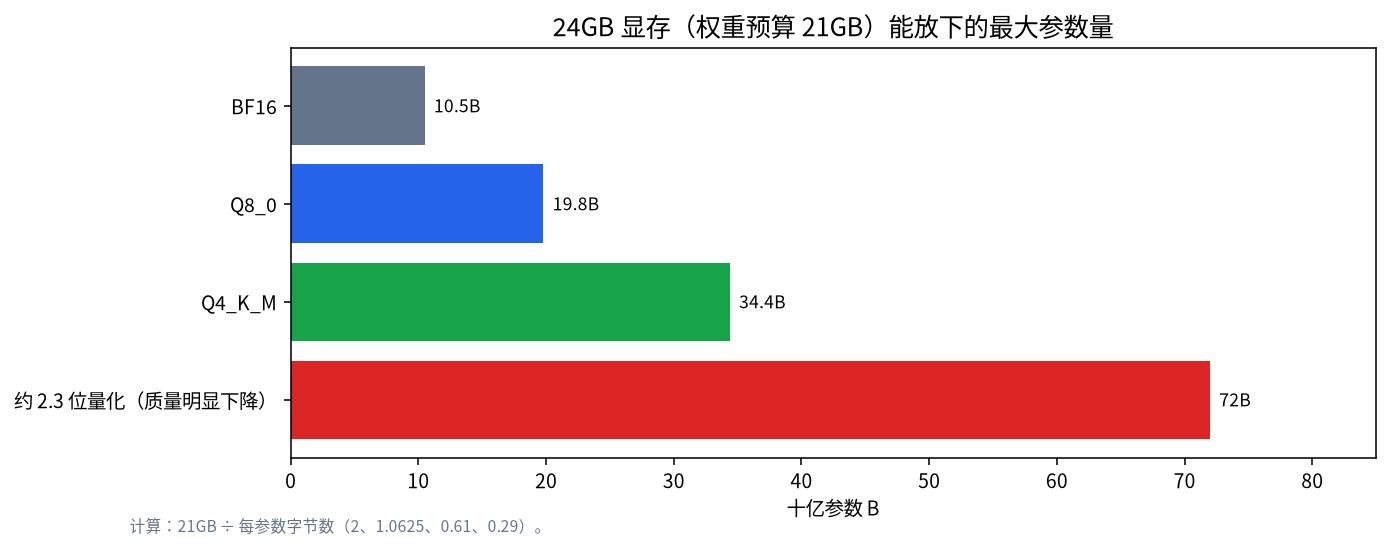
最后一行需要特别说明:把 70B 压到约 2.3 位,权重约 20GB,理论上能塞进 24GB,但 2 位级量化对质量的损失很大,我们没有实测,也不建议把它当成“4090 能跑 70B”的答案。比较稳妥的说法是:4090 单卡的实用上限是约 32B 的 Q4 稠密模型。
适配矩阵:常见型号逐个对照
下表给出各型号 Q4 与 Q8 的权重体积(按上面的每参数字节数推算,27B 和 32B 采用 Ollama 页面的实际值),并判断能否放进单张 4090。
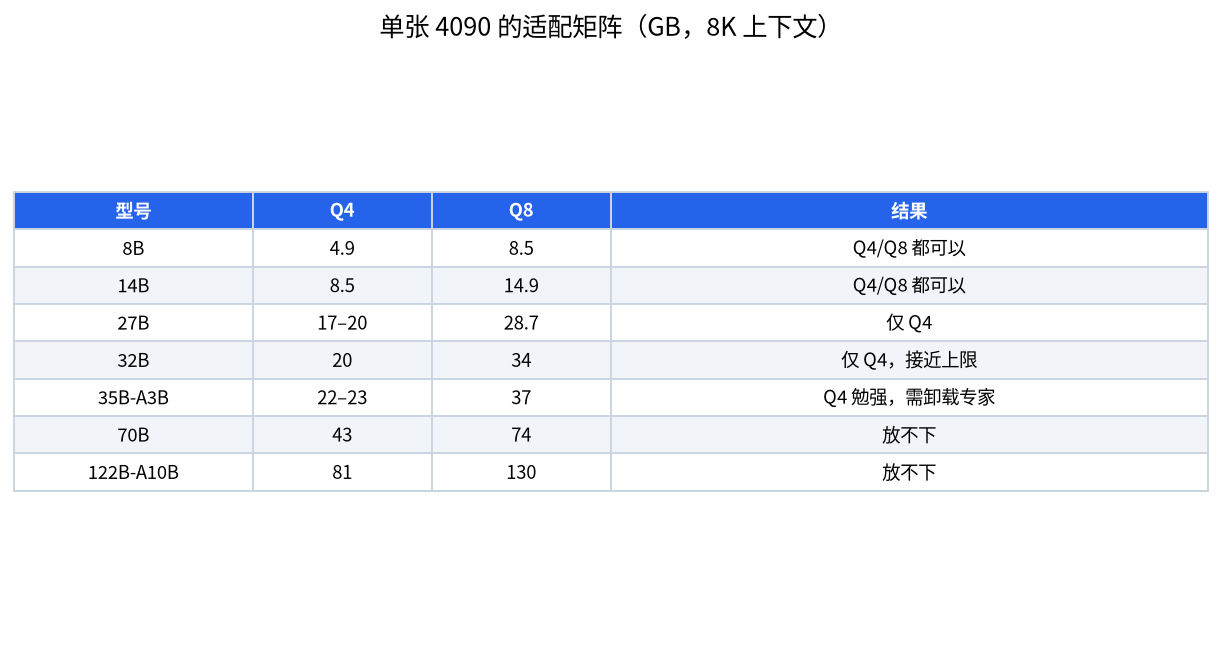
| 型号 | Q4 体积 | Q8 体积 | 单卡 4090(8K 上下文) |
|---|---|---|---|
| 8B | 约 4.9GB | 约 8.5GB | Q4、Q8 都轻松,BF16(约 16GB)也能放下 |
| 14B | 约 8.5GB | 约 14.9GB | Q4、Q8 都可以 |
| 27B | 17 到 20GB | 约 28.7GB | 仅 Q4 可以 |
| 32B | 约 20GB | 约 34GB | 仅 Q4,8K 上下文约 22GB,已接近上限 |
| 35B-A3B(MoE) | 约 22 到 23GB | 约 37GB | Q4 勉强,需卸载部分专家 |
| 70B | 约 43GB | 约 74GB | 放不下,需内存卸载或双卡 |
| 122B-A10B(MoE) | 约 81GB | 约 130GB | 放不下,需大量内存 |
32B 在 24GB 上的实际占用,我们在 DeepSeek R1 蒸馏版大小详解里给过:8K 上下文约 22GB,16K 约 24GB。更多 24GB 显存的实操建议见 24GB 显存能跑什么。
上下文长度会把上限再压低
权重放得下,不代表能用。KV 缓存随上下文增长。以传统的 32B 稠密模型为例,每个 token 的 KV 缓存常常是几百 KiB,16K 上下文就是几个 GiB,所以 32B Q4 从 8K 的约 22GB 增长到 16K 的约 24GB。较新的混合线性注意力模型(例如 Qwen3.6)的缓存小得多:我们在 Qwen 本地部署硬件要求里算过,27B 每个 token 只有约 64KiB。所以同样是“27B 到 32B”,不同架构的实际上限可能差很多。通用的计算方法见 显存计算器使用指南。
一个能对上数的算例:为什么 32B 在 8K 到 16K 就到顶
传统 32B 稠密模型(以 Qwen2.5-32B 一类的配置为例:64 层、8 个 KV 头、头维度 128,我们按公开配置推算,实际以你用的模型卡为准)每个 token 的 KV 缓存是 64 × 2 × 8 × 128 × 2 字节 = 262,144 字节 = 256KiB。8K 上下文是 256KiB × 8,192 = 2GiB,16K 是 4GiB,32K 是 8GiB。权重约 20GB,所以 8K 总计约 22GB,16K 约 24GB,32K 约 28GB,这与前面引用的“8K 约 22GB、16K 约 24GB”完全吻合,也说明在 4090 上跑 32B 想要 32K 以上的上下文就必须压缩缓存或换模型。缓存量化(例如 q8_0)可以把缓存大致减半,代价是质量略有影响。
超出 24GB 怎么办:内存卸载与速度上限
生成每个 token 都要读取被激活的权重,所以速度上限等于带宽除以每个 token 读取的字节数。4090 的显存带宽是 1008 GB/s,DDR5-5600 双通道的理论带宽约 89.6GB/s(5600 × 8 字节 × 2),差了十倍以上。
| 场景 | 每个 token 读取的权重 | 读取来源 | 理论速度上限 |
|---|---|---|---|
| 32B Q4,全部在显存 | 约 20GB | 显存 | 1008 ÷ 20 ≈ 50 tokens/s |
| 70B Q4,23GB 在显存、20GB 在内存 | 约 43GB | 23GB 显存 + 20GB 内存 | 单 token 时间 23/1008 + 20/89.6 ≈ 0.246 秒,约 4 tokens/s |
| gpt-oss-120b(约 117B 参数,约 5.1B 激活,MXFP4 约 62GB),专家在内存 | 约 2.7GB | 内存 | 89.6 ÷ 2.7 ≈ 33 tokens/s |
| 122B-A10B Q4(约 81GB),专家在内存 | 约 6.1GB | 内存 | 89.6 ÷ 6.1 ≈ 15 tokens/s |
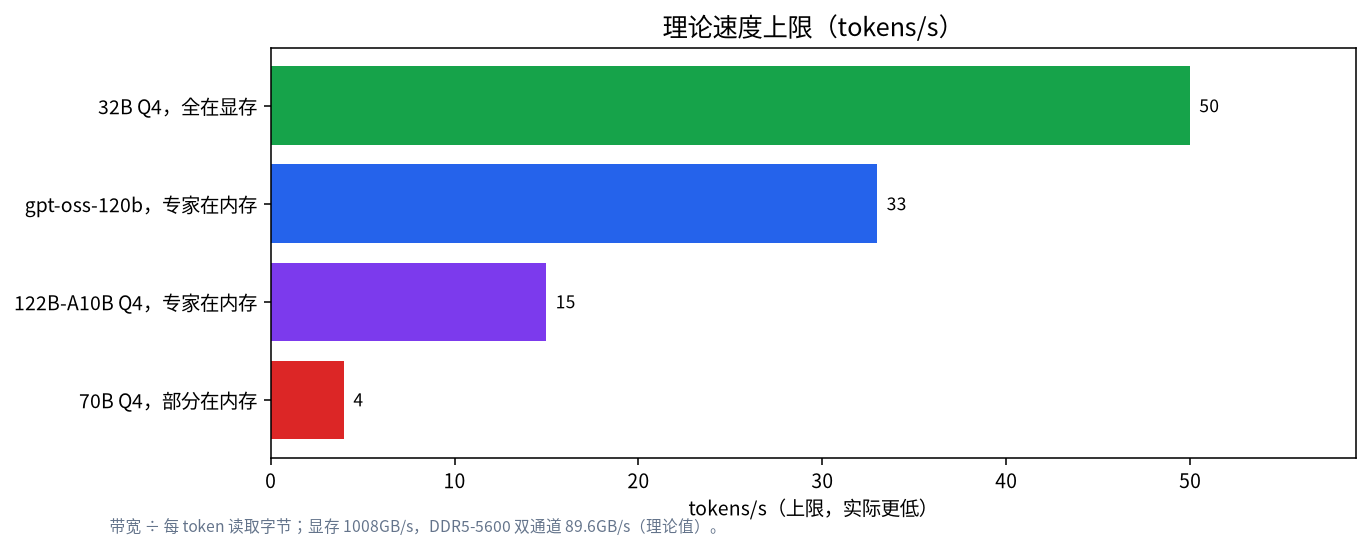
算式示例(70B):权重 43GB,显存放 23GB、内存放 20GB。读一遍显存部分需要 23 ÷ 1008 ≈ 0.0228 秒,读一遍内存部分需要 20 ÷ 89.6 ≈ 0.223 秒,合计约 0.246 秒,也就是约 4 tokens/s。这就是“70B 能跑,但很慢”的数学原因:绝大部分时间花在内存那一部分上。
而 MoE 模型的情况好得多,因为每个 token 只读取被激活的专家:gpt-oss-120b 的体积按 117B 乘 MXFP4 的约 4.25 位估算约 62GB(我们的推算),激活参数约 5.1B,每个 token 读约 2.7GB,因此理论上限约 33 tokens/s;这也解释了为什么这类模型在“24GB 显卡加大内存”的配置上反而比 70B 稠密模型好用。原理见 MoE 本地部署,内存与显存的取舍见 内存与显存的取舍。
注意内存容量:卸载意味着“显存加内存”要装下整个模型。122B-A10B Q4 约 81GB,显存 23GB 加 64GB 内存是 87GB,几乎没有余量,建议至少 96GB 内存;gpt-oss-120b 约 62GB,64GB 内存可行但紧。
怎么在自己的 4090 上验证上限
- 用
nvidia-smi观察显存:加载模型后先看静态占用,再把上下文逐步加到 4K、8K、16K,记录每一步的增长,斜率应接近上面算出的每 token 缓存。 - 用运行时的日志确认有多少层在显存、有多少层在内存:llama.cpp 会在启动时打印卸载的层数,Ollama 的状态命令会显示处理器占比。只要有层落到 CPU,速度就会按前面的公式明显下降。
- 速度测试要固定提示和生成长度,记录生成阶段的 tokens/s,并和带宽上限相比;实测达到上限的六到八成是合理的,低于三成通常说明有层在 CPU 或设置不当。
- 稳定性也要看:长时间满载观察温度和降频,4090 满载 450W,机箱风道和电源冗余(建议 850W)都要到位。
量化精度到底损失多少
Q8_0 通常被认为与 BF16 几乎没有差别,Q4_K_M 在多数评测中仍然可用,Q3 以下的损失会逐步明显,2 位级量化则要逐个模型自测。我们的建议是:在放得下的前提下,优先用“更大的模型加 Q4”而不是“更小的模型加 Q8”,因为参数规模带来的能力提升通常大于 Q8 与 Q4 的差距;但这条经验对不同任务不一定成立,请在你自己的任务上对照测试。具体的量化解读见 量化 Q4_K_M 解读。
两张 4090:48GB 的世界
两张 4090 共 48GB(可用约 46.8GB),70B Q4 权重约 43GB,加 8K 上下文的缓存约需 45.5GB,勉强能装下,但这意味着第二张 4090 的价格(约 26,000 元)加上 1,200W 级的电源、足够的 PCIe 通道和散热。多卡的坑和取舍见 双卡本地大模型整机。如果预算有限,更实用的方向是:
- 单张 RTX 5090 32GB: 权重预算约 29GB,Q4 可放约 47B;价格约 53,500 元(参考价)。
- 96GB 工作站卡: 70B Q8 或更大;见 RTX PRO 6000 工作站。
- 二手 3090 24GB 组双卡: 容量与双 4090 一样,价格低得多,但功耗和噪声更高,见 RTX 5090、4090、3090 对比。
微调与训练:4090 的上限更低
推理只需要权重和缓存,微调还需要梯度和优化器状态。按 Unsloth 公布的最小显存数字,QLoRA(4 位)微调 14B 需要约 8.5GB,27B 约 22GB,32B 约 26GB(单卡 4090 放不下),70B 约 41GB。所以 4090 做 QLoRA 的实用上限约 27B。详见 本地 LoRA 微调显存。
显存之外:内存、PCIe 与散热
做内存卸载时,系统内存的频率和通道数直接决定速度:同样是 64GB,双通道 DDR5-5600 的理论带宽约 89.6GB/s,而单通道只有一半,速度上限也会减半,所以应当插满两条内存条并开启对应的频率。PCIe 带宽对“整层卸载”的影响较小,因为被卸载的层留在内存里由 CPU 计算;对“每个 token 都要把权重搬进显存”的做法影响较大,应尽量避免。散热方面,长时间推理时 4090 的功耗可能低于游戏满载(取决于负载,请自己测),但仍然要保证风道,必要时限制功耗来换取稳定。
怎么选:按任务决定
| 任务 | 推荐 | 原因 |
|---|---|---|
| 日常问答、写作 | 27B 到 32B Q4 | 质量与速度的最佳折中 |
| 长上下文文档分析 | 27B 混合注意力模型(缓存小) | 缓存是瓶颈 |
| 编程助手 | 14B 到 32B,注意量化 | 速度与质量兼顾 |
| 想用最大的开源模型 | MoE 加大内存 | 速度可用 |
| 追求 70B 稠密 | 双 24GB 卡或 96GB 卡 | 单卡太慢 |
选型的更多方法见 模型大小怎么选。
常见问题 FAQ
4090 能跑多大的模型?
单卡实用上限是约 32B 的 Q4 稠密模型,约 20B 的 Q8,约 10B 的 BF16;借助内存可运行更大的 MoE 模型,但速度下降。
4090 能跑 70B 吗?
70B Q4 约 43GB,单卡放不下。把一部分放进内存可以运行,但理论速度只有约 4 tokens/s;用两张 4090 或 96GB 的卡更合适。
4090 能跑 32B 吗?
可以,Q4 约 20GB,8K 上下文约 22GB,16K 约 24GB,已经接近上限;上下文长度越大越紧。
4090 和 3090 跑大模型差多少?
容量一样都是 24GB,所以能跑的模型相同;带宽 1008 对 936 GB/s,速度上限差约 8%。区别主要在价格和功耗,见我们的 对比文章。
内存越大越好吗?
对于卸载场景,内存容量决定能不能装下模型,内存带宽决定速度;容量够用就好,别指望靠大内存让 70B 变快。
4090 能微调多大的模型?
QLoRA 的实用上限约 27B(约 22GB);32B 约需 26GB,单卡放不下。
和我们聊聊
如果你想让我们按你的内存、上下文需求和预算帮你算一遍,欢迎到社区留言,或发邮件到 admin@microaione.com。
参考资料:NVIDIA GeForce RTX 4090 规格、Unsloth 微调显存需求、Ollama 模型库、OpenAI gpt-oss 介绍。数据读取于 2026-10-30 至 2026-11-04,北京时间。