ChatGLM / GLM 本地部署与一键包注意点
「chatglm本地部署」是国内最早一批火起来的本地大模型关键词。ChatGLM-6B 在 2023 年让很多人第一次在自己的显卡上跑起了中文对话模型,随后又有 ChatGLM2、ChatGLM3、GLM-4 等版本,以及今年初开源的 GLM-OCR。问题是,网上至今还流传着大量“chatglm2一键部署包”“免配置整合包”,来源五花八门。本文告诉你现在该选哪个版本、需要多大显存、怎么用官方权重部署,以及怎样识别有问题的一键包。
核对说明:版本信息来自智谱官方 GitHub 与 Hugging Face 上的 zai-org(原 THUDM)组织页面,2026-11-05 查阅。显存为按参数量和精度的估算值,实际以你的上下文长度和推理框架为准。我们不提供、也不推荐任何第三方整合包。
要点速览(更新于 2026-11-05)
- ChatGLM-6B / 2 / 3 属于早期版本,今天主要有学习价值;新项目优先 GLM-4 系列。
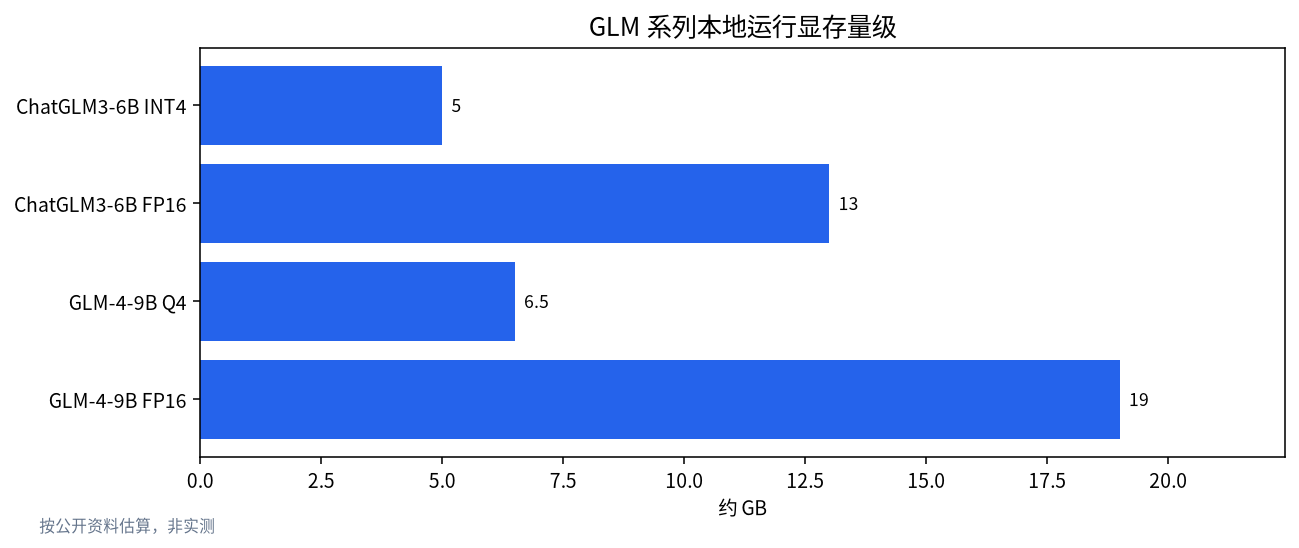
GLM-4-9B 量化后 8GB 显存可跑;FP16 需要约 19GB。
GLM-OCR 是约 0.9B 参数的文档识别模型,MIT 许可,支持 vLLM、SGLang、Ollama。
一键包的最大风险不是“跑不起来”,而是夹带木马、挖矿程序或被改过的权重。
官方权重 + Ollama / LM Studio,已经和一键包一样省事。
chatglm本地部署:先选对版本
很多教程还停留在 ChatGLM-6B 时代,照着做会发现依赖版本对不上、模型效果也明显落后。下面是各代的定位:
| 版本 | 发布时间 | 参数 | 现状 | 建议 |
|---|---|---|---|---|
| ChatGLM-6B | 2023-03 | 约 6B | 已停止更新 | 仅作学习 |
| ChatGLM2-6B | 2023-06 | 约 6B | 已停止更新 | 不推荐新项目 |
| ChatGLM3-6B | 2023-10 | 约 6B | 维护有限 | 老项目可继续用 |
| GLM-4-9B 系列 | 2024 起 | 约 9B | 有对话、长上下文等变体 | 个人本地首选 |
| GLM-4.5 / 4.6 等大模型 | 2025 起 | MoE,体量很大 | 需多卡服务器 | 企业私有化 |
| GLM-OCR | 2026-01 | 约 0.9B | 活跃 | 文档识别 |
“GLM 本地”这个词现在通常指 GLM-4 系列。智谱后续发布的大型 MoE 版本,部署门槛接近我们写过的 Kimi 本地部署,不适合个人电脑。
GLM 系列为什么在国内这么流行
ChatGLM 出自清华大学知识工程实验室与智谱团队,是国内较早开放权重、并且专门针对中文优化的对话模型。在当时,开源模型大多以英文为主,中文能力参差不齐,而 ChatGLM-6B 只要一张六七千元的显卡就能在本地流畅对话,门槛低、中文好,很快成为高校课程、毕业设计和中小企业试水的首选。也正因为用户基数大、很多人不熟悉命令行,各种整合包、懒人包才会层出不穷。
此后智谱把重点转向 GLM-4 系列,统一了模型命名,组织名也从 THUDM 迁移到 zai-org。对于今天的读者来说,最重要的一点是:网上搜到的很多教程写于 2023 年,所用的依赖版本、显存数据和代码接口都已经过时,照抄往往报错。判断一篇教程是否可用,先看它对应的模型版本和发布日期,再去官方仓库核对最新说明。
显存与硬件需求
| 模型与精度 | 大致显存 | 适合的显卡 |
|---|---|---|
| ChatGLM3-6B INT4 | 约 5GB | GTX 1660 / RTX 3050 以上 |
| ChatGLM3-6B FP16 | 约 13GB | RTX 4070 Ti 16GB 以上 |
| GLM-4-9B Q4 量化 | 约 6–7GB | RTX 3060 12GB、4060 8GB |
| GLM-4-9B FP16 | 约 19GB | RTX 3090 / 4090 24GB |
| GLM-OCR | 数 GB 量级 | 大多数 8GB 显卡 |
长上下文会额外占用 KV 缓存,处理长文档时要多留余量。具体算法见 上下文长度与 KV 缓存,不确定自己显卡能跑多大的,可以用 显存计算器。显存不够时,内存加 CPU 也能跑,只是慢,参考 12GB/16GB 显存能跑什么。
用官方权重部署的三种方式
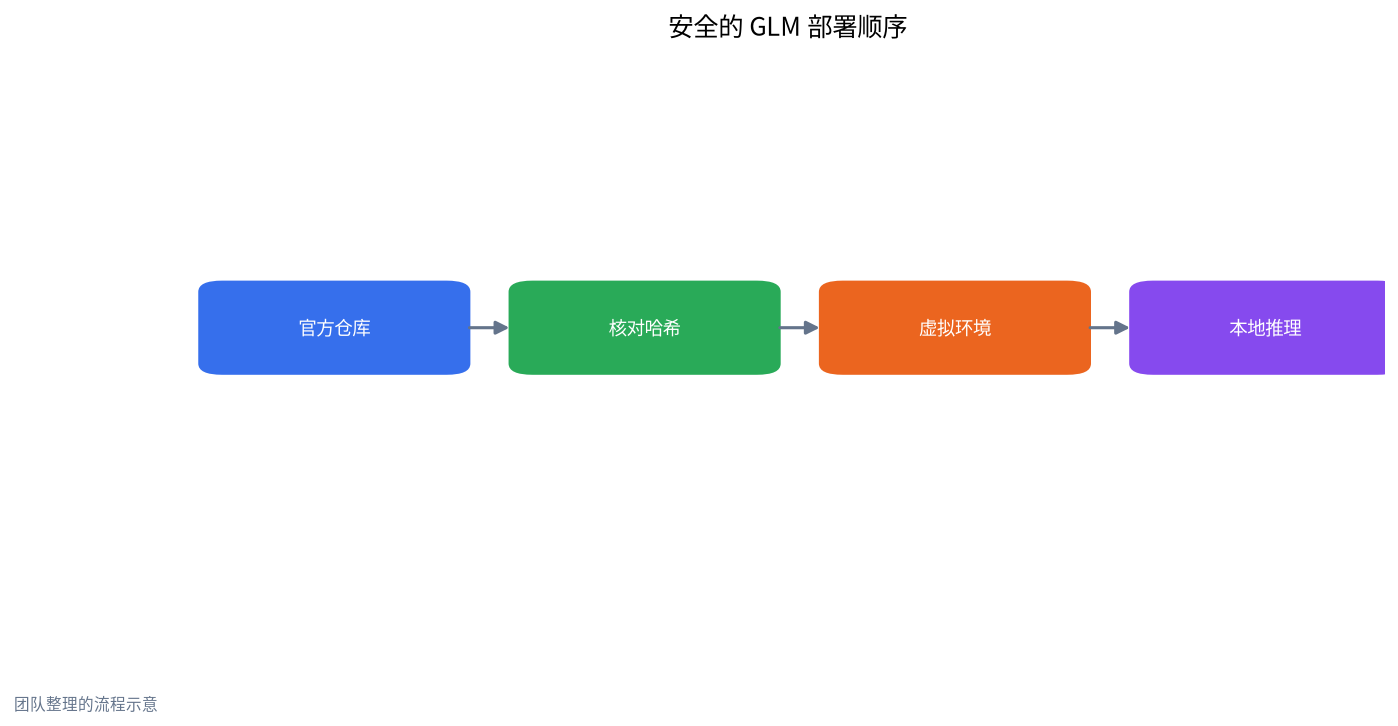
方式一:Ollama / LM Studio(最省事)。 在 Ollama 库里搜索 glm4 等标签,ollama run 一条命令即可,量化、分片和校验都由工具处理。LM Studio 里搜索 GLM,选择 GGUF 量化版本下载,下载前留意发布者是否可信,优先选择下载量大、说明完整的版本。新手推荐这条路,教程见 Ollama 安装 和 LM Studio 教程。
方式二:Transformers 原版推理。 适合要做二次开发的人:
- 新建虚拟环境:
python -m venv glm并激活; - 按模型卡要求安装对应版本的
torch与transformers; - 从官方仓库下载权重,国内可用魔搭或镜像,见 Hugging Face 国内镜像指南;
- 运行模型卡里的示例代码,注意很多 GLM 版本需要
trust_remote_code=True——这意味着会执行仓库里的 Python 代码,所以只对官方仓库这样做。
方式三:vLLM / SGLang 服务化。 需要多人同时使用或接入 Dify 等平台时,用 vLLM 提供 OpenAI 兼容接口,并发和吞吐都更好。入门见 vLLM 与 SGLang。
glm ocr本地部署教程
GLM-OCR 是智谱在 2026 年 1 月开源的文档识别模型,官方模型卡称约 0.9B 参数,采用 MIT 许可,擅长表格、公式、印章和复杂版式。它体积小,非常适合在本地处理合同、发票和扫描件,而不用把文件上传到云端。简要步骤如下:
- 从 Hugging Face 的 zai-org/GLM-OCR 或魔搭对应仓库下载权重;
- 按模型卡安装推荐版本的 transformers,或使用 vLLM / SGLang 启动服务;
- 若用 Ollama,可查找官方或可信来源提供的版本,以 Ollama 库页面为准;
- 输入图片或 PDF 页面,输出 Markdown 或结构化文本;
- 把输出接入本地知识库,实现“扫描件也能被检索”,参见 本地 RAG 知识库。
OCR 结果在财务、法务场景中仍需人工复核,尤其是数字和金额。批量处理时建议先抽样一百页做准确率检查,再决定哪些类型的文档可以直接入库、哪些必须人工校对。扫描件质量对结果影响很大,分辨率过低、倾斜或有阴影的图片,先做简单的预处理再识别,效果会好很多。
chatglm2一键部署包:为什么要谨慎
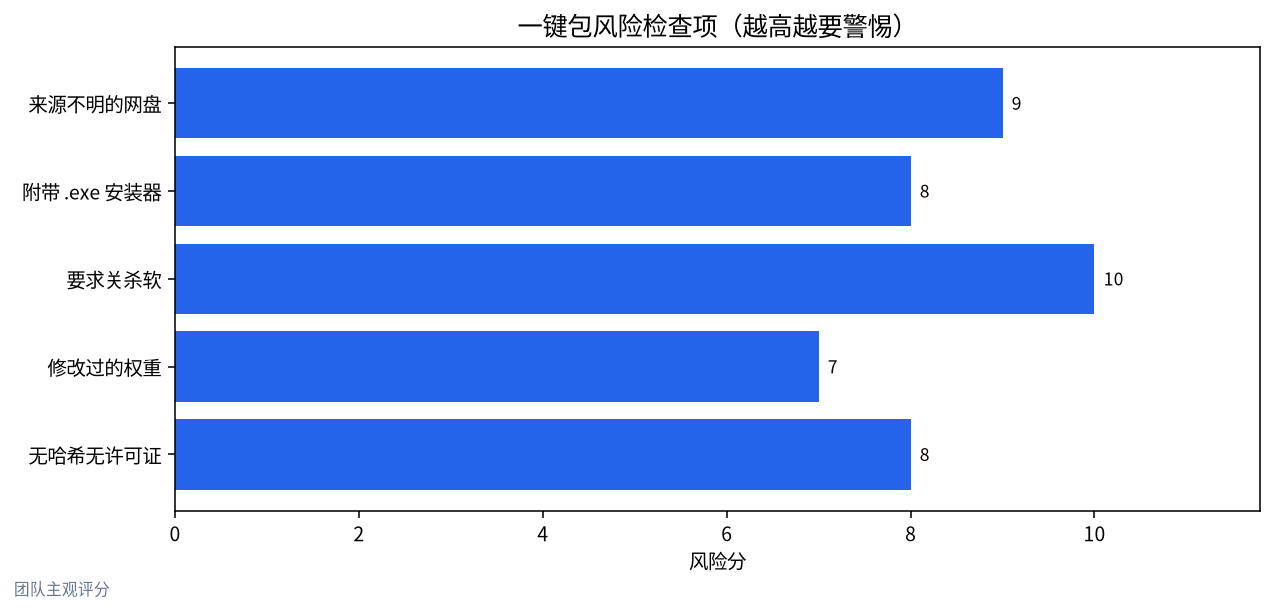
一键包本身不是原罪:有些是热心网友把 Python 环境、依赖和权重打包好,确实方便。但我们收到的求助里,问题集中在下面几类:
| 风险信号 | 可能后果 | 怎么判断 |
|---|---|---|
| 来源是不明网盘或二手群文件 | 文件被替换或植入程序 | 找不到原作者和发布页 |
| 附带 .exe 安装器或“加速器” | 木马、挖矿、广告软件 | 用杀软和 VirusTotal 扫描 |
| 要求关闭杀毒软件或防火墙 | 系统完全暴露 | 正规项目不会这样要求 |
| 权重文件与官方哈希不一致 | 被篡改或植入后门的模型 | 对比官方 SHA256 |
| 没有许可证、没有版本说明 | 无法合规使用,也无法排错 | 查看包内文件 |
| 宣称“破解版”“无限制版” | 违法风险与恶意代码风险叠加 | 直接放弃 |
尤其要提醒:PyTorch 的 .bin(pickle)格式文件在加载时可以执行任意代码,来路不明的权重务必优先选择 safetensors 格式,并核对哈希。所谓“破解版”“无审查版”GLM,我们在 模型泄露与破解说法核查 和 无审查模型的法律与合规风险 里专门分析过,这类东西往往既不合规也不安全。
如果你只是想要一个“不用敲命令”的体验,Windows 无命令行安装本地大模型 里介绍的方法同样是一键安装,但来源是官方。
部署之后:让 GLM 更好用的几个建议
模型跑起来只是开始。想让它真正帮上忙,可以从这几方面入手:
- 写清楚系统提示词:告诉模型它的身份、回答风格和不知道时怎么说,比反复换模型更有效。
- 控制上下文长度:九十亿参数级别的模型在超长对话里容易遗忘前文,长文档交给检索,而不是整篇塞进去。
- 配合知识库:把公司制度、产品手册放进本地知识库,再让 GLM 根据资料回答,准确率会明显提升。
- 定期更新:关注官方仓库的新版本,同一系列的小版本更新往往修复了重复输出、格式错乱等问题。
- 保留评测问题集:准备二三十个你最常问的问题,每次换模型或换量化版本都跑一遍对比,避免凭感觉判断好坏。
- 注意安全边界:对外提供服务时加上内容审核和访问控制,不要追求所谓的“破甲”效果,相关风险我们在越狱科普里讲过。
常见问题(FAQ)
chatglm本地部署现在还值得做吗?
学习和老项目可以,新项目建议直接用 GLM-4 系列或其他新一代模型,效果和生态都更好。
chatglm2一键部署包能用吗?
能跑不代表安全。建议只从官方仓库下载权重,用 Ollama、LM Studio 或自建虚拟环境部署;确需使用一键包,至少要核对来源、扫描病毒并比对哈希。
GLM-4-9B 需要多大显存?
Q4 量化约 6–7GB,8GB 显卡可以跑;FP16 约 19GB,需要 24GB 显卡。长上下文需额外预留显存。
glm ocr本地部署需要什么配置?
GLM-OCR 只有约 0.9B 参数,大多数带 8GB 显存的电脑都能运行,CPU 也能跑但较慢。
可以商用吗?
取决于具体版本的许可证。GLM-OCR 采用 MIT 许可;其他 GLM 版本有各自的模型许可,请以仓库中的 LICENSE 为准。
trust_remote_code 安全吗?
它会执行模型仓库里的代码,只对官方或你审查过的仓库开启,不要对来源不明的模型使用。
部署遇到问题?
欢迎到社区交流,或发邮件到 admin@microaione.com。深圳团队可以帮你核对版本、显存和文件来源。
参考资料:智谱 GLM-4 GitHub、GLM-OCR 模型卡、GLM-OCR 文档、本站 开源大模型下载。