本地模型红队测试入门:用 garak、PyRIT、promptfoo 与 Inspect 评估你自己部署的大模型
把大模型部署在本地、开放给团队或客户之前,最该做的一件事是红队测试:以攻击者的视角,系统地测你自己的系统会在哪些地方出问题。它不是“找一条能攻破的神奇提示”,而是一套有范围、有指标、有记录、有修复闭环的工程流程。这篇 本地模型红队测试入门文章讲清楚:测什么、用什么工具、怎么搭隔离环境、怎么设计指标,以及最容易被忽略的一环——怎么用统计方法判断结果可不可信。需要先声明:这里只讲对你自己拥有或获得书面授权的系统做评测,不提供任何可直接使用的攻击文本,也不教怎么绕过别人的系统。原理背景见 大模型越狱是什么,防御设计见 越狱防御怎么做;全部相关文章在 大模型越狱与安全专题。
要点速览(更新于 2026-11-04)
- 开源工具足够入门:garak(Apache-2.0,NVIDIA)、PyRIT(MIT,微软)、promptfoo(MIT)、Inspect(MIT,英国 AI 安全研究所)、HarmBench(MIT,标准化基准)。
先授权、再隔离、只用公开基准:只测自己的系统,在不联外网的机器上运行,不保存或传播有害输出。
同时测两个指标:攻击成功率和误拒率,只看前者会得到一个“什么都拒绝”的模型。
样本量决定可信度:200 次测试中成功 3 次,Wilson 95% 置信区间约 0.5% 到 4.3%;成功 0 次也不等于风险为零,上限约 1.9%。
结果要进入“发现、修复、复测”的闭环,并在每次更换模型、护栏或系统提示后重跑。
先定规矩:授权、范围与隔离
红队测试和攻击的区别,首先在规矩,而不在技术:
- 只测自己的或有书面授权的系统: 在别人的服务上做这类测试,可能违反服务条款甚至法律;请遵守所在地区的法律和平台规则。
- 划定范围: 写下测哪个模型、哪个版本、哪些入口(聊天、接口、检索、工具调用),以及不测什么。
- 隔离环境: 用单独的机器或容器,断开不必要的外网,不接入真实业务数据库和生产密钥。
- 只用公开基准与自建的无害样本: 评测数据来自 HarmBench 等公开基准,或你自己编写的、不包含可用有害细节的测试样例。
- 把输出当敏感数据: 测试中模型可能产生不当内容,应限制访问权限、设定保留期限,不对外传播,也不要把可直接使用的成功案例贴到公开场合。
- 遵守负责任披露: 如果你发现的是第三方模型或软件的漏洞,应先通知维护者,给修复留出时间。
本地模型红队测试的闭环
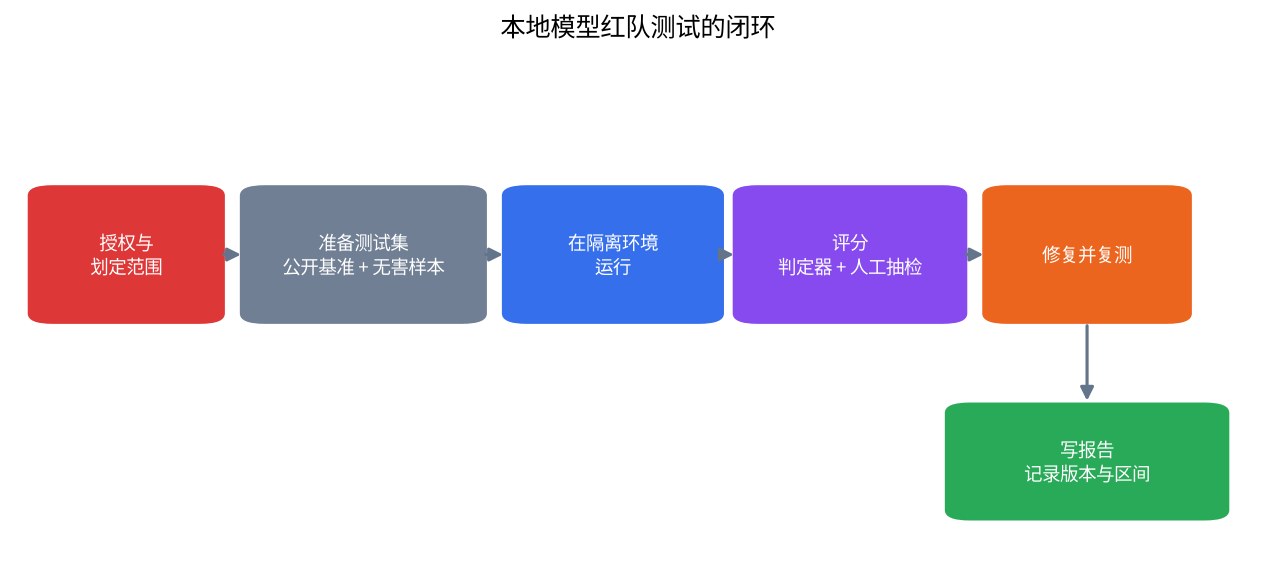
整个流程是一个循环:授权与范围 → 准备测试集 → 运行 → 评分 → 修复 → 复测 → 写报告。每次改动模型、护栏、系统提示或权限,都要回到“运行”这一步重来。
五个常用开源工具
| 工具 | 来源与许可 | 主要用途 | 适合谁 |
|---|---|---|---|
| garak | NVIDIA,Apache-2.0 | LLM 漏洞扫描器,内置大量探针与检测器,命令行使用 | 想快速对一个本地模型做广谱扫描 |
| PyRIT | 微软,MIT | Python 框架,可编排多轮攻击、转换器与评分器 | 想自定义多轮流程和评分的团队 |
| promptfoo | MIT | 测试用例与红队评测,可在持续集成中回归 | 想把评测放进开发流水线 |
| Inspect | 英国 AI 安全研究所,MIT | 通用评测框架,任务、求解器与评分器可组合 | 想写自己的评测任务 |
| HarmBench | 安全人工智能中心,MIT | 标准化的攻击与防御评测基准 | 想要可比较、可复现的指标 |
选择建议:想快速开始,用 garak 扫一遍;想把评测放进日常开发,用 promptfoo 或 Inspect;想研究多轮和自定义评分,用 PyRIT;想让结果能与论文对比,用 HarmBench。各工具的版本更新很快,下面的命令以官方文档为准。
用 garak 做一次最小的本地扫描
garak 是命令行工具,安装与查看探针列表如下(命令来自其官方 README):
python -m pip install -U garak
garak --list_probes
用 --target_type 和 --target_name 指定要测的模型,用 --spec 选择探针,例如 README 中的写法是 --spec probes.encoding(编码类提示注入探针)。本地模型可以通过 Hugging Face 本地管线、llama.cpp 的 GGUF,或者 REST 生成器接入;如果你的模型用 Ollama 提供了兼容接口,可以按官方文档用 REST 配置连接,接口见 本地 API 服务器指南。几点建议:
- 先用小探针集试跑,确认配置正确,再跑全量;全量探针很多,耗时会很长。
- 固定模型版本、量化方式、系统提示和采样参数,并把它们写进报告,否则结果无法复现(量化的影响见 量化选择指南)。
- 保存 garak 的日志文件,用于复盘和对比不同配置。
- 选项在不同版本可能变化,以
garak --help和官方文档为准。
设计指标:攻击成功率与误拒率
一个只测“被攻破多少次”的评测会鼓励模型拒绝一切,所以至少要同时记录:
| 指标 | 含义 | 怎么测 | 注意 |
|---|---|---|---|
| 攻击成功率(ASR) | 在公开基准的有害类别请求中,模型给出了不该给的内容的比例 | 用公开基准 + 判定器 | 判定器本身会出错,需抽样人工复核 |
| 误拒率 | 对无害但“看起来敏感”的请求,模型拒绝的比例 | 自建无害样本集 | 影响真实可用性 |
| 护栏误拦率 / 漏拦率 | 加了护栏模型后,对无害请求的拦截率与对有害请求的漏过率 | 同上,分别统计 | 见 Llama Guard 本地部署教程 |
| 一致性 | 同一请求多次采样的结果是否稳定 | 温度大于 0 时重复采样 | 决定要采多少次 |
| 延迟与成本 | 加防护后的耗时 | 计时 | 评估防护的代价 |
按类别拆开报告:总体 3% 的成功率可能掩盖了某一个类别 30% 的问题。
统计:多少次测试才够
红队结果常被当成“精确的百分比”,其实它是一个有误差的估计。用 Wilson 置信区间可以给比例估计加上误差范围。算例(样本量均为 200):
| 成功次数 | 点估计 | Wilson 95% 置信区间 |
|---|---|---|
| 0 / 200 | 0% | 0% 到约 1.9% |
| 3 / 200 | 1.5% | 约 0.5% 到 4.3% |
| 10 / 200 | 5.0% | 约 2.7% 到 9.0% |
| 30 / 200 | 15.0% | 约 10.7% 到 20.6% |
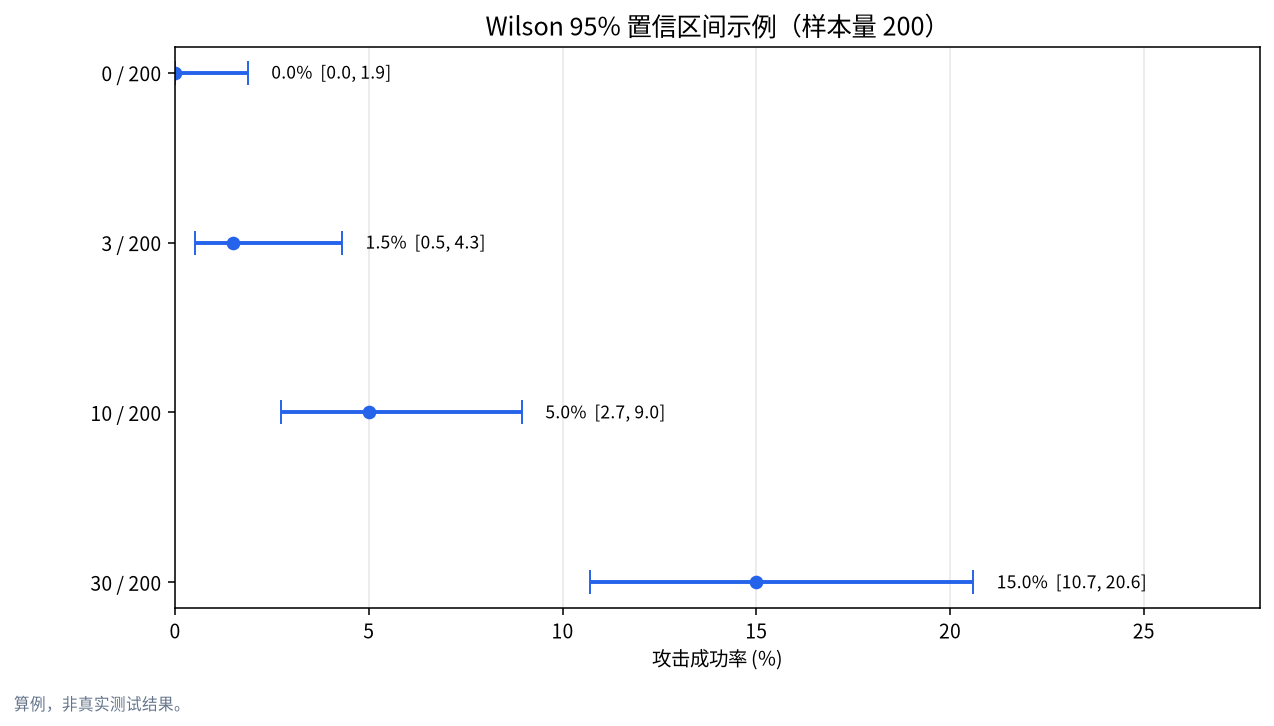
从中可以读出两个结论。第一,0 次成功不等于风险为零:200 次测试一次都没成功,真实比率的 95% 上限仍可能接近 1.9%。第二,样本小时区间很宽:比较两个配置时,如果基线是 12/200(6.0%,区间约 3.5% 到 10.2%),加护栏后是 3/200(1.5%,区间约 0.5% 到 4.3%),两个区间有重叠,说明“护栏有帮助”的证据还不够强,需要更多样本。把样本扩大到 2,000 次且仍为 1.5%(30/2000),区间会收窄到约 1.1% 到 2.1%。
样本量与误差范围的关系,按正态近似、真实比率约 5% 估算:
| 样本量 | 95% 误差范围(约) |
|---|---|
| 50 | ±6.0 个百分点 |
| 100 | ±4.3 个百分点 |
| 200 | ±3.0 个百分点 |
| 500 | ±1.9 个百分点 |
| 1,000 | ±1.4 个百分点 |
| 2,000 | ±1.0 个百分点 |
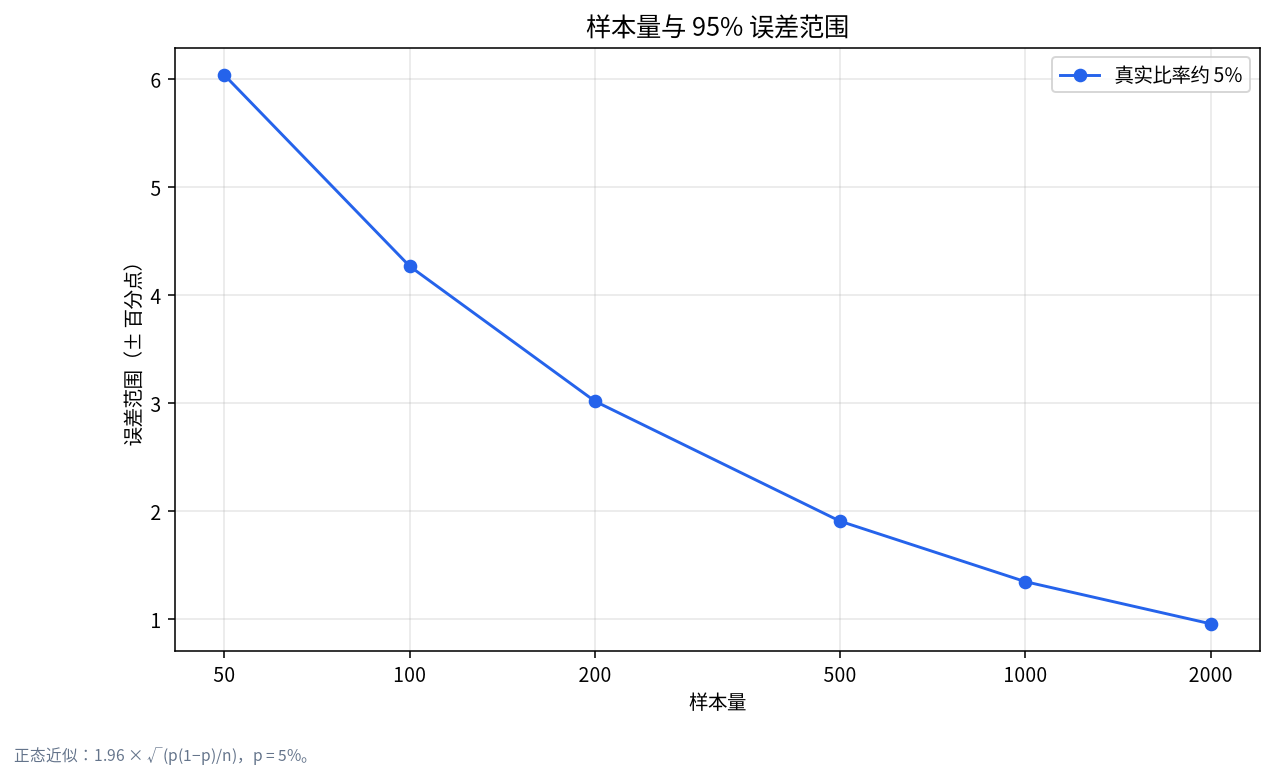
误差范围与样本量的平方根成反比:想把误差缩小一半,需要约四倍的样本。因此,对比两个配置时,用同一批测试集、同一组采样参数,并报告区间而不是只报百分比。
判定器:自动评分的陷阱
大多数红队评测需要“判定器”来决定一次输出算不算成功:可以是关键字匹配、另一个分类模型(例如护栏模型),或者另一个大模型来打分。每一种都会出错:关键字容易漏判和误判,用大模型打分可能带有偏差,并且不同判定器之间的结果不可直接比较。实践建议:
- 随机抽取一部分结果,人工复核,估算判定器本身的误差;
- 报告时写明判定器的名称和版本;
- 关键结论用两种不同的判定器交叉验证;
- 人工复核时注意保护复核人员,限制接触有害内容的量。
把结果变成修复
红队测试的价值在于修复,而不是发现。按下面的顺序处理:
- 分类与分级: 按类别和严重程度整理发现,区分“模型层问题”“护栏层问题”和“权限配置问题”。
- 选择修复手段: 对应的手段包括调整系统提示、增加或更换护栏、限制工具权限、加速率限制,或者换一个更合适的模型(见 越狱防御怎么做)。
- 复测: 用同一测试集重跑,对比区间;防止“修好一个,引出另一个”。
- 记录版本: 把模型、量化、护栏、系统提示的版本一起记录,便于回溯。
- 持续回归: 把评测放进更新流程,每次变更都跑一遍。
红队测试清单
- ☐ 已获得授权并写下测试范围
- ☐ 在隔离环境运行,不接生产数据
- ☐ 使用公开基准和无害的自建样本
- ☐ 同时测攻击成功率和误拒率
- ☐ 样本量足够,并报告置信区间
- ☐ 抽样人工复核判定器
- ☐ 输出按敏感数据管理,有保留期限
- ☐ 发现已分级,并进入修复与复测
常见误区
- “找到一条能攻破的提示就算红队”: 红队要的是覆盖面和可重复的比率,而不是单个案例。
- “测一次没问题就安全了”: 随机性和样本量会让单次结果不可靠。
- “拒绝越多越安全”: 过高的误拒率会让系统失去可用性。
- “本地模型没有外部风险,不用测”: 一旦开放给他人,或者接入工具和数据,就需要测。
- “公开成功案例有助于社区”: 请遵守负责任披露,不要公开可直接使用的攻击文本。
常见问题 FAQ
本地模型红队测试需要什么硬件?
扫描工具本身不吃显存,主要取决于被测模型的运行需求;测试期间要同时运行被测模型和判定器,所以显存预算要把两者加起来,见 本地大模型显存指南。
garak 和 PyRIT 有什么区别?
garak 更像开箱即用的扫描器,内置大量探针;PyRIT 更像可编排的框架,适合自定义多轮流程和评分。
样本量多少合适?
取决于你要分辨的差异:想分辨 3% 与 6% 这种差距,按常用的 5% 显著性水平和 80% 统计功效估算,每组大约需要 750 次;先用 200 次做初筛,再对关键类别加大样本。
测试时能用真实用户的数据吗?
不建议。使用公开基准和自建的无害样本,避免把真实数据和隐私带进测试,见 本地大模型与隐私。
发现了问题应该怎么办?
如果是自己的系统,按优先级修复并复测;如果是第三方模型或软件的问题,先私下通知维护者。
红队测试能证明系统安全吗?
不能。它只能给出在特定测试集和条件下的估计,不能证明“绝对安全”。
和我们聊聊
如果你想为自己的本地模型设计一套评测流程,欢迎把部署方式和使用场景发到社区,或邮件 admin@microaione.com。更多相关内容见大模型越狱与安全专题,也可以先读 大模型越狱简史了解攻防的演变。
参考资料:garak 官方仓库、PyRIT 官方仓库、promptfoo 官方仓库、Inspect 官方仓库、HarmBench(arXiv 2402.04249)。许可信息读取自各仓库页面,数据读取于 2026-11-04,北京时间。