本地大模型编程助手:用 Ollama、Continue 和 Qwen Coder 搭建私有代码助手(2026)
把公司的源代码发给云端服务,对很多开发者和团队来说是不可接受的;即使是个人项目,离线助手也有吸引力:在飞机上能用,也没有按 token 计费的账单。本地大模型编程 可以提供代码问答、行内补全,甚至多文件修改,全部运行在你自己的显卡上。这篇文章给出一个实用的搭建方式:用 Ollama 作为模型服务,用 Continue 扩展接入编辑器;说明 Qwen 编程模型按显存怎么选,补全、聊天和智能体如何用不同模型分工,以及上下文长度和速度这两个最常见的坑。如果还没安装 Ollama,请先看《Ollama 安装指南》。
核对说明:模型名称、体积和上下文窗口来自 Ollama 模型库的 qwen2.5-coder 与 qwen3-coder 页面,配置信息来自 Continue 官方文档,均于 2026-10-30 核对。我们没有自己测试过编程质量或速度,所以不对任何模型与云端助手的差距下结论。显存建议是根据文件体积推算的经验值。
要点速览(更新于 2026-10-30)
- 补全用小而快的模型,聊天用更大的模型;一个模型很少能同时做好两件事。
30B 的 Qwen3-Coder 是混合专家模型,文件约 19GB,每个 token 只激活 3.3B 参数,适合 24GB 显卡或大统一内存。
上下文是隐藏成本:Continue 的默认上下文可能比其他工具更高,要主动设置,并用 ollama ps 检查。
本地大模型编程到底能做什么
编程助手其实是三种不同的工作。补全是在你输入时建议下一段代码,必须在很短的时间内响应;聊天用来解释选中的代码、分析报错、起草函数,等几秒是可以接受的;智能体或多文件编辑要读取多个文件、规划修改再应用,需要最大的上下文和最强的模型。VS Code 和 JetBrains 的 Continue 扩展正好提供这几种模式:智能体、聊天、编辑和自动补全,另有命令行工具。
因为工作不同,最好的设置通常不止一个模型。
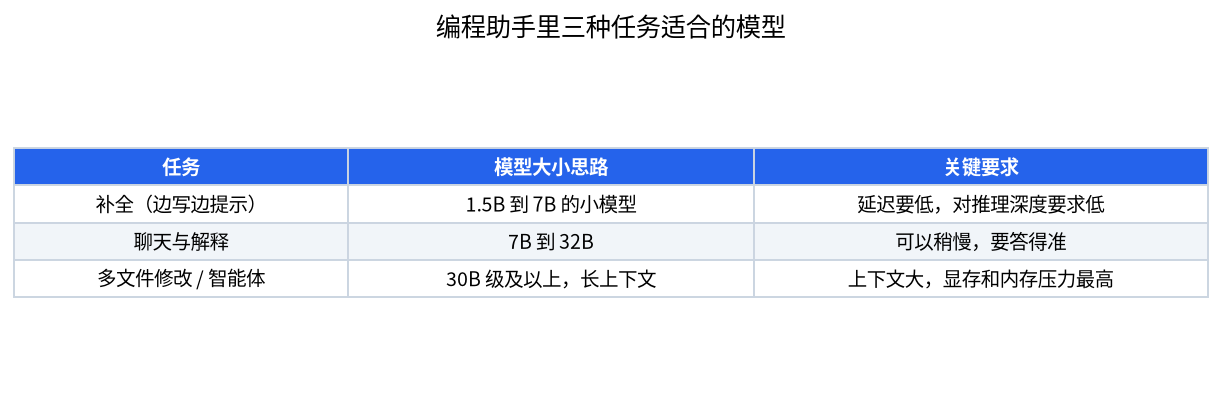
| 任务 | 模型思路 | 受什么限制 |
|---|---|---|
| 补全 | 1.5B 到 7B | 延迟;太慢的模型无法用于行内建议 |
| 聊天与解释 | 7B 到 32B | 回答准确度与显存 |
| 多文件修改与智能体 | 30B 级及以上,长上下文 | 上下文内存与速度 |
按显存选模型
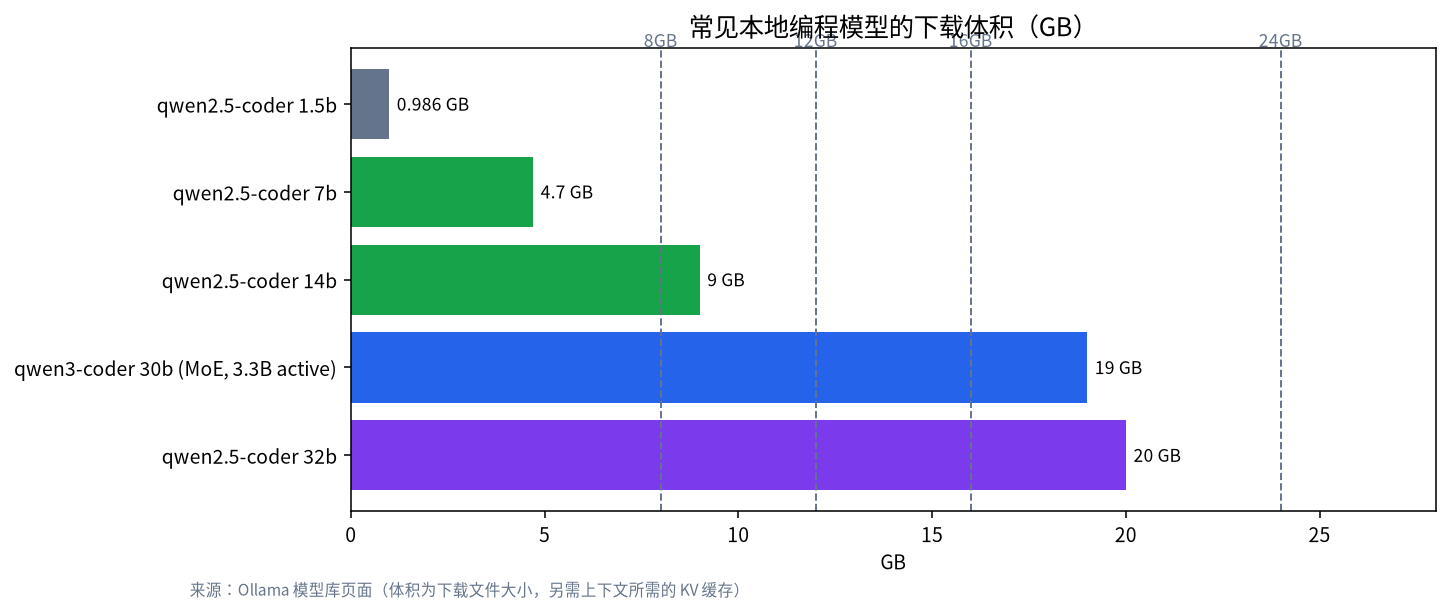
Ollama 模型库里的 Qwen2.5-Coder 有 0.5B、1.5B、3B、7B、14B、32B 六个尺寸,上下文窗口都是 32K,文件体积分别是 398MB、986MB、1.9GB、4.7GB、9.0GB 和 20GB。Qwen3-Coder 有 30B 版本(总参数 30B,激活 3.3B,19GB,上下文窗口 256K),也有 480B 版本(290GB),Ollama 页面说明本地运行至少需要 250GB 的内存或统一内存。480B 对普通硬件来说遥不可及,所以现实的选择是较小的版本。
| 你的显存或内存 | 聊天或智能体模型 | 补全模型 | 备注 |
|---|---|---|---|
| 8GB | qwen2.5-coder 7b(4.7GB) | qwen2.5-coder 1.5b | 只能用短上下文,见《8GB 显存能跑什么》 |
| 12GB | qwen2.5-coder 14b(9.0GB) | 1.5b 或 3b | 要给 KV 缓存留空间 |
| 16GB | 14b,可用更长上下文 | 1.5b 或 3b | 比 12GB 更宽裕,见《12GB 与 16GB 显存方案》 |
| 24GB | qwen3-coder 30b(19GB)或 qwen2.5-coder 32b(20GB) | 1.5b | 长上下文时很紧,见《24GB 显存方案》 |
| 64GB 以上统一内存 | qwen3-coder 30b,可用长上下文 | 7b | 速度取决于内存带宽 |
这些只是经验建议:文件体积只是权重,你的上下文还会增加 KV 缓存。可以用《显存计算器指南》估算不同上下文长度的缓存。
安装 Ollama 与 Continue
Continue 文档建议用 ollama pull 下载模型,而不是 ollama run,因为 run 会启动一个你并不需要的交互会话。要使用模型页面上列出的准确标签,因为默认标签可能和你预期的大小不同。
ollama pull qwen2.5-coder:1.5b
ollama pull qwen3-coder:30b
ollama list
curl http://localhost:11434
最后一条命令应该返回一行说明 Ollama 正在运行的信息。然后在 VS Code 插件市场安装 Continue,并编辑它的配置文件。配置里的一个模型条目要写明提供方、模型标签和可选的补全参数。
name: My Local Config
version: 0.0.1
schema: v1
models:
  - name: Qwen3 Coder 30B
    provider: ollama
    model: qwen3-coder:30b
    defaultCompletionOptions:
      contextLength: 16384
文档还提供预制的模型配置块,但配置块只提供配置,模型本身仍需在本机拉取。如果看到”模型需要更多系统内存”的报错,文档说明 Continue 的默认上下文长度可能比其他工具更高,建议降低 contextLength 或使用更小的模型。如何确认模型跑在哪里,见《Ollama 用不上 GPU 怎么排查》。
上下文长度是隐藏成本
编程助手喜欢大上下文:它们会把当前文件、相关文件和很长的对话一起发送。上下文变大,KV 缓存也随之增长;如果显卡刚好放得下权重,更大的上下文可能把一部分模型挤到 CPU 内存里,速度急剧下降。建议从 8K 到 16K 的适中上下文开始,用 ollama ps 查看模型是否完全在 GPU 上,只有在仍然完全在 GPU 上时才继续增大。要记住:模型支持的长上下文不等于你的硬件能用的长上下文。Qwen3-Coder 原生支持 256K,但你能用多少由显存决定。
混合专家编程模型为什么适合中端硬件
Qwen3-Coder 30B 的页面写明总参数 30B、每个 token 只激活 3.3B。这有两层意义。第一,19GB 的权重仍然要存放在某处,所以显存或统一内存的容量决定它能否放下。第二,由于每个 token 只用到网络的一小部分,只要权重位于高速内存中,生成速度可能比同样文件大小的稠密模型更快。因此 24GB 显卡或统一内存充足的 Mac 是这个模型舒适的家,而 8GB 显卡则不适合。如果一部分权重溢出到普通系统内存,就会损失大部分优势,所以请把 19GB 当作最低值,并给上下文留出空间。
实用工作流程
- 安装 Ollama,拉取一个小的补全模型和一个聊天模型。
- 在 Continue 里分别为聊天和补全设置条目。
- 用真实文件测试:先让它解释,再做一个小重构,再写一个单元测试。
- 观察补全的延迟,建议出现太晚就换更小的模型。
- 记录哪些模型和上下文组合在你的机器上可行。
编程之外的模型选择见《最值得本地部署的模型》和《Qwen 本地部署指南》;如果你有大内存机器并想用 OpenAI 风格的推理模型,见《gpt-oss 本地部署教程》。
调优技巧
显存紧张时,让补全模型一直驻留,聊天模型按需加载;Ollama 在使用后会让模型在内存里停留一段时间,加载大模型需要几秒。代码任务可以降低温度,让回答更可重复。需要修改时,给模型最小而有用的上下文:函数、调用方和失败的测试,比整个目录更好。提示要具体,写明语言、框架版本和想要的风格,因为小模型比大模型更依赖清晰的指令。
隐私与许可
在本地运行意味着提示和代码留在你的机器上,这是很多团队选择这条路的主要原因。但仍要检查编辑器里的每个扩展是否只使用本地端点,并在商用前查看你所用模型的许可证,因为不同模型家族的许可不同。Ollama 常见问题还提到一个设置 OLLAMA_NO_CLOUD=1,可以关闭云端功能,让你确信没有东西离开机器。
怎么判断它够不够用
不要凭一个惊艳的演示就判断编程模型。从真实工作里挑十个小任务,例如解释一个难懂的函数、写一个单元测试、把代码翻译成另一种语言、修复一个失败的测试、在文件内重命名。把每个任务分别交给本地模型和你以前用的工具,记录有多少回答可以直接使用、多少需要小修、多少是错的。换模型或换量化时重复同一份清单,这样才能公平比较。同时也要衡量手感:出现太晚的补全比没有补全更糟,需要一分钟的聊天回答即使正确也会打断思路。许多开发者最终的做法是:私有仓库和快速提问用本地模型,只在最难的问题上保留云端工具。
常见错误
- 一个超大模型包办一切:补全变得太慢,补全应该用小模型。
- 忽视上下文:4K 时完全在 GPU,32K 时一半在 CPU。
- 用 ollama run 下载:它会打开交互会话,应该用 ollama pull。
- 拉错标签:默认标签可能不是你想要的大小。
- 期望云端水平:较小的本地模型有用,但不等于最大的云端模型,请用自己的代码测试。
- 忘了其他工具的隐私设置:只有扩展不把代码同时发给云端,本地模型才真正保护你。
常见问题
本地编程用哪个模型最好?
对 12GB 到 24GB 显存的多数人,Qwen 编程模型是合理的起点:12GB 到 16GB 用 14B,24GB 用 30B 的 Qwen3-Coder 或 32B 的 Qwen2.5-Coder。请用自己的代码测试,因为适用性取决于语言和任务。
本地模型能替代云端助手吗?
很多日常任务够用,尤其是私有代码。但我们没有测过质量,最大的云端模型在难题上通常更强。
需要多少显存?
8GB 显卡可以用 7B 编程模型加短上下文;12GB 到 16GB 适合 14B;24GB 适合 30B 级,上下文长度还会增加内存需求。
补全和聊天要用同一个模型吗?
通常不用。补全需要极低延迟,1.5B 到 7B 的模型更合适,而聊天更适合较大的模型。
为什么助手很慢或提示内存不足?
常见原因是上下文太长。在 Continue 里降低 contextLength,改用更小的模型,并用 ollama ps 检查是否在 GPU 上。
真的私密吗?
模型在你的机器上运行,但你要确认每个扩展只使用本地端点,并考虑设置 OLLAMA_NO_CLOUD=1。
分享你的配置
如果你搭好了本地编程环境,欢迎到社区分享,或者发邮件到 admin@microaione.com,附上你的显卡、模型和编辑器,我们可以帮你调优。
参考:Ollama 模型库:qwen3-coder、Ollama 模型库:qwen2.5-coder、Continue 指南:Ollama、Ollama 常见问题。