RTX 5060 Ti 16GB 跑本地大模型:能把 14B 模型跑好的主流装机方案
对很多人来说,本地 AI 机器不必是一个两万元的工程。16GB 显存的显卡正好处在一个甜点位置:内存够用来跑比 8B 模型有明显提升的 14B 模型,电源是普通规格,价格也在中端电脑预算能承受的范围内。这篇讲 RTX 5060 Ti 16GB 跑本地大模型的指南,会介绍这张卡是什么、16GB 能装下什么、纸面上能有多快、一套完整的参考配置,以及什么时候二手 3090 是更好的答案。想了解更广泛的 12GB 和 16GB 情况,请看12GB 与 16GB 显存指南。
核对说明:显卡规格来自英伟达 GeForce RTX 5060 系列页面,于 2026-10-30 阅读。价格和配置来自我们 2026-10-30 的参考文件,主要是中国市场来源,每天都在变化。速度和显存占用是用带宽和模型大小推算的,不是实测。写这篇文章时我们没有测试过这张卡。
要点速览(更新于 2026-10-30)
- 英伟达标注 RTX 5060 Ti 为 16GB GDDR7、128-bit 位宽、180W 功耗、要求整机电源 600W、最高 GPU 温度 87 摄氏度。
16GB 能舒服地运行 Q4_K_M 的 14B 模型加 16K 上下文,32K 上下文则刚好勉强;24B 和 32B 模型装不下有用的上下文。
用这张卡的参考主流配置约 10,853 元,而围绕二手 3090 的配置为 14,299 元,显存翻倍,带宽超过翻倍。
RTX 5060 Ti 16GB 跑本地大模型:这张卡能提供什么
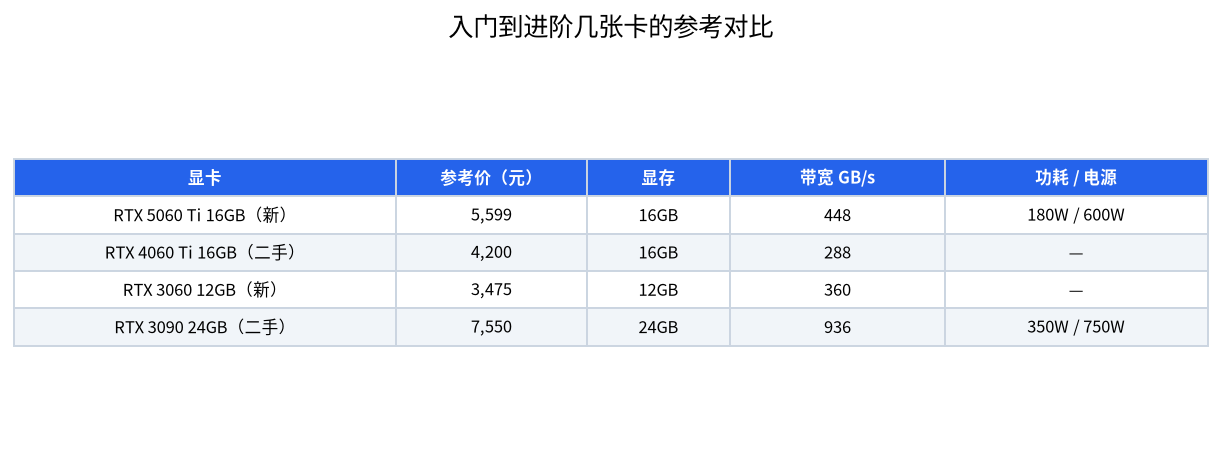
5060 Ti 是一张中端游戏卡,有 16GB 和 8GB 两个版本;对语言模型来说只有 16GB 版本值得关注。英伟达页面标注为 128-bit 位宽的 GDDR7 显存。按我们记录的显存带宽 448 GB/s,它比上一代 RTX 4060 Ti 16GB 的 288 GB/s 快,也比 RTX 3060 12GB 的 360 GB/s 快,但比 936 GB/s 的 RTX 3090 慢得多。180W 的功耗和 600W 的整机电源要求意味着,一般的台式机配 650W 电源就够了,成本和噪音都能保持较低。尺寸因厂商而异,请把你选的卡和机箱对照检查。
因为 token 生成受带宽限制,窄小的 128-bit 位宽是它的主要局限。如果你看重低功耗、新卡保修和 16GB,这张卡很合适;如果你想要最快的聊天速度或 32B 模型,就不合适。
16GB 能装下什么
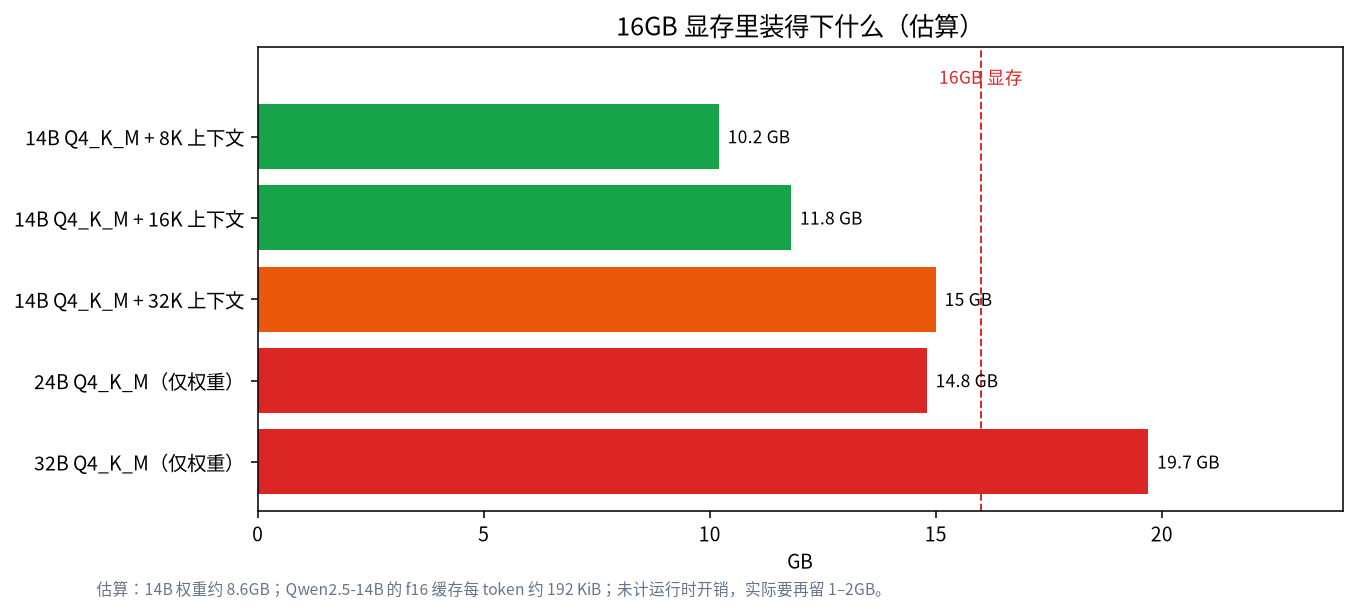
Q4_K_M 模型约每十亿参数 0.61GB,所以 14B 模型约占 8.6GB。缓存要在此基础上增加:Qwen2.5-14B 的 f16 缓存每个 token 约 192 KiB,所以 8K token 约 1.5 GiB,16K 约 3 GiB,32K 约 6 GiB。总量分别约为 10.2GB、11.8GB 和 15.0GB,最后一个没给运行时开销留下空间,所以把 32K 当作边缘。如果像上下文长度指南里介绍的那样量化缓存,更大的上下文装起来会更宽裕。
24B 模型仅权重就约 14.8GB,剩下的空间不够做有用的上下文。32B 模型需要约 19.7GB,在 Q4_K_M 下装不进这张卡。像 gpt-oss-20b 这样的 MoE 模型,Ollama 标注为 14GB,可以带着较小的上下文装下,而且因为每个 token 只激活少量参数,运行得很快,见gpt-oss 指南。实际上,这张卡最适合的是 7B 到 14B 的稠密模型和小型 MoE 模型,比如我们 Qwen 指南里的那些。
推算的速度上限
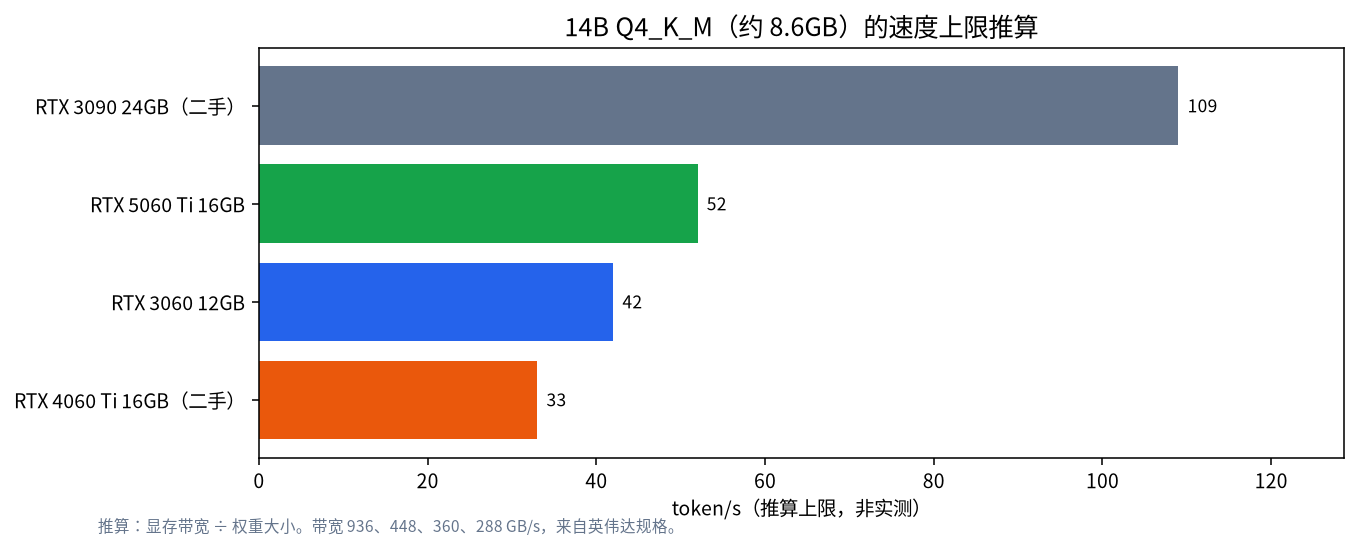
对于约 8.6GB 的 14B Q4_K_M 模型,带宽规则给出这些上限:5060 Ti 约每秒 52 个 token,RTX 3060 12GB 约 42,二手 RTX 4060 Ti 16GB 约 33,二手 RTX 3090 约 109。实际速度更低,我们也没有测过其中任何一张卡。对比显示了关键所在:5060 Ti 比旧的 16GB 显卡快一半以上,而二手 3090 的上限大约是它的两倍。聊天时,每秒 50 个 token 已经比大多数人阅读的速度快,所以对 14B 模型来说 5060 Ti 并不慢;它在长提示词、推理模型或多个用户时才更要紧。
10,853 元的参考配置
| 部件 | 参考价(元) |
|---|---|
| RTX 5060 Ti 16GB,新卡 | 5,599 |
| CPU,Core i5-14600KF 盒装 | 1,300 |
| 主板,B760M DDR4 | 929 |
| 内存,DDR4 32GB(2 × 16GB) | 1,150 |
| 固态硬盘,1TB | 1,025 |
| 电源,650W | 350 |
| 散热器 | 250 |
| 机箱 | 250 |
| 合计 | 10,853 |
合计不含显示器、外设、操作系统授权、运费和组装服务费。它来自我们的参考配置文件,基于 2026-10-30 的中位价,请核对实时报价。650W 的电源高于英伟达标注的 600W 整机要求,留有一些余量。我们用 DDR4 来控制成本,因为对完全放在显存里的模型来说,系统内存速度影响很小。如果你打算把模型卸载到系统内存,请在决定之前阅读卸载指南。
16GB 的卡还是二手 3090?
| 方案 | 显卡价格 | 整机合计 | 显存 | 带宽 | 备注 |
|---|---|---|---|---|---|
| RTX 5060 Ti 16GB | 5,599 | 10,853 | 16GB | 448 GB/s | 新卡,有保修,180W |
| 二手 RTX 4060 Ti 16GB | 4,200 | 约 9,450 | 16GB | 288 GB/s | 更便宜,更慢,有二手风险 |
| 二手 RTX 3090 24GB | 7,550 | 14,299 | 24GB | 936 GB/s | 350W,750W 电源,有二手风险 |
3090 的整机合计来自我们的参考文件;二手 4060 Ti 的数字是我们自己的计算,只替换了主流配置里的显卡,是近似值。比 5060 Ti 的配置多花 3,446 元,3090 配置多出 8GB 显存和约两倍的带宽,能解锁 32B 模型。对想要保修和低功耗的人,5060 Ti 用起来更省心。对想逐步用上更大模型的人,3090 路线通常更划算;二手显卡指南介绍了如何安全地购买,RTX 5090、4090、3090 对比则涵盖了高端部分。
十分钟完成软件设置
安装好驱动后,按照 Ollama 指南安装 Ollama,并拉取一个 14B 模型,例如 ollama pull qwen2.5:14b。用 ollama run qwen2.5:14b 开始聊天,问一个很长的问题,然后打开第二个终端运行 ollama ps。Processor 一栏应该显示 100% GPU。如果显示的是 CPU 和 GPU 的分担,说明模型加上上下文装不下,应当降低上下文或选更小的量化。
想要扩大上下文,可以把环境变量 OLLAMA_KV_CACHE_TYPE 设为 q8_0,Ollama 文档说明它在启用 Flash Attention 的情况下,占用的缓存内存大约是 f16 的一半;q4_0 约占四分之一,质量代价更大。对我们的 14B 例子,q8_0 缓存能把 32K 的情况从约 15.0GB 降到约 11.8GB,装起来就很宽裕。依赖它之前,请在你自己的提示词上测试质量。还要记住,Ollama 会根据显存选择默认上下文:显存低于 24GiB 的显卡默认从 4K 开始,所以需要更多时必须自己调高。
谁应该跳过这张卡
如果你的第一目标是 32B 或 70B 模型,就跳过它,因为 16GB 不经过大量卸载装不下它们,你会失望。如果你已经有一张 12GB 的卡,主要跑 7B 和 8B 模型,也可以跳过;升级带来的好处比看上去少,钱也许留到以后买 24GB 的卡更好。如果你需要用大模型生成高分辨率图像,对内存的需求更高,也可以跳过,ComfyUI 指南有说明。如果你想要一张安静、低功耗、有保修的卡,一个用于编程或写作的 14B 级助手,以及一台也能流畅玩游戏的机器,就可以考虑它。
升级路径
16GB 的卡不会把你锁死。如果需求增长,你可以卖掉它换一张 24GB 的卡,或者在主板和电源允许时,给同一台机器加第二张卡。650W 的电源能带这一张卡,但带不动两张,所以如果打算扩展,一开始就买更大的电源;购买时多花的钱,比以后更换要少得多。机箱和主板的选择也要留有余地:有两个全长插槽的主板和有风道空间的机箱,会让以后的一步更便宜。双显卡指南介绍了扩展需要什么。
让 16GB 发挥最大作用
选择合适的量化。对 14B 模型,Q4_K_M 给上下文留有空间,而 Q6 或 Q8 的文件可能就不行。把上下文设成你需要的大小而不是最大值,因为每多一个 token 就多占一份缓存内存。加载模型之前,关闭其他占用显存的程序,比如开了硬件加速的浏览器和游戏。用 ollama ps 检查模型完全运行在 GPU 上;CPU 与 GPU 的分担会大幅降低速度,卸载指南里有描述。如果你偶尔需要 24B 或 32B 模型,可以考虑量化缓存或使用更小的量化,并接受更低的质量或更短的上下文。
同时计划好第一天的测试。加载一个 8B 和一个 14B 模型,对同样的十条提示词比较质量和耗时。这能告诉你多出来的内存对你的任务是否值得。保持显卡驱动更新,并在长时间生成时留意温度,因为 87 摄氏度是上限,不是目标。
入门档还是主流档?简短的决定
如果你只运行 7B 和 8B 模型,入门装机指南里入门档的 12GB 显卡就够了,还能省约 3,000 元。如果你想要 14B 模型并留有像样的上下文,16GB 是舒适的最低档。如果你预计一年内会想用 32B 模型,现在直接买 24GB 档可能比买两次更便宜。整机配置指南把所有这些配置并排放在一起。
常见错误
- 选了 8GB 版本。 它不适合大多数语言模型。
- 指望 32B 模型。 在 Q4_K_M 下它们需要约 19.7GB。
- 忽略 128-bit 位宽。 带宽比显存容量更限制速度。
- 把上下文设成最大。 缓存内存随每个 token 增长。
- 跳过机箱和插槽检查。 显卡尺寸因厂商而异。
常见问题
RTX 5060 Ti 16GB 适合跑本地大模型吗?
它是一张适合 7B 到 14B 模型和小型 MoE 模型的入门到主流显卡,有新卡保修,功耗适中。
它有多快?
我们没有实测。14B Q4_K_M 模型的推算上限约为每秒 52 个 token,实际速度会更低。
它能跑 32B 模型吗?
在 Q4_K_M 下不能完全放进显存,因为需要约 19.7GB。你需要卸载或更小的量化,并付出速度或质量的代价。
二手 3090 更好吗?
在容量和速度上更好:24GB 和 936 GB/s。它更贵,功耗更高,也没有保修。
我需要什么电源?
英伟达标注要求的整机电源是 600W。我们的参考配置用的是 650W 电源。
跑大模型应该买 8GB 版本吗?
不应该。对语言模型,应该看 16GB 的版本。
和我们聊聊
在规划主流配置,又拿不准显卡?欢迎加入社区,或发邮件到 admin@microaione.com。
参考资料:英伟达 GeForce RTX 5060 系列、Ollama gpt-oss 页面、Qwen2.5-14B 模型卡。