DeepSeek V4.1 Flash 1017 本地部署:最好的开源模型?硬件、量化与成本
“最好的开源模型”是个很容易被夸大的说法,所以我们先用证据来检验 DeepSeek V4.1 Flash 1017:它在 Artificial Analysis 智能指数上拿到 32 分,与 GLM-5.3 并列开放权重模型第一,MIT 许可,上下文 1M。但它的权重规模很大,本地运行需要的是”内存加显存合计 128GB 以上”的机器,不是一张普通显卡。这篇文章把它和同类开放权重模型、和闭源的 Claude Opus 5 做对比,列出各量化版本的体积与内存需求,算清 API 与本地的成本差,并给出一套你可以复现的测试方法。
核实说明:指数数据读取自 Artificial Analysis(2026-11-01);基准成绩来自 DeepSeek 在 Hugging Face 模型卡上的官方表格(厂商公布,对比对象是 Opus 5,不是更新的 Opus 5.5);量化体积、内存需求与量化后得分来自 Unsloth 的官方指南(由量化发布方自测,不是我们实测);API 价格来自 DeepSeek 官方定价页。我们没有在本地跑过这个模型,文中没有自测速度或得分。
要点速览(更新于 2026-11-01)
- Artificial Analysis 指数:DeepSeek V4.1 Flash 1017 为 32,与 GLM-5.3 并列开放权重第一;同一榜单上 Claude Opus 5.5(max)为 58,差距很大。
Unsloth 给出的内存加显存需求:1 比特约 128–145GB,2 比特约 176–205GB,4 比特约 305GB,8 比特约 315GB。
API 价格非高峰为每百万 token 输入 0.15 美元(缓存命中 0.003)、输出 0.60 美元,高峰翻倍;个人使用通常 API 比自建便宜得多,本地部署的理由是隐私、离线和可控。
它真的是”最好的开源模型”吗
按第三方榜单,可以说是”并列最好”。Artificial Analysis 的榜单里,DeepSeek V4.1 Flash 1017(Max 档)和 GLM-5.3(Max 档)都是 32 分;其后是 MiMo-V2.6-Pro 的 30 分;榜单上的 DeepSeek V4 Pro 0813(max)为 23 分,Qwen3.8 27B(xhigh)为 20 分。该榜单共 86 个模型,其中 31 个是开放权重。
| 开放权重模型 | 智能指数 | 说明 |
|---|---|---|
| DeepSeek V4.1 Flash 1017(Max) | 32 | MIT,1M 上下文,约 175 tokens/s(API),单任务成本约 0.60 美元 |
| GLM-5.3(Max) | 32 | 并列第一 |
| MiMo-V2.6-Pro | 30 | 第三 |
| Qwen3.8 27B(xhigh) | 20 | 参数小得多,硬件门槛低得多 |
| DeepSeek V4 Pro 0813(max) | 23 | 同厂上一代 Pro |
| 参考:Claude Opus 5.5(max,闭源) | 58 | 见我们的 Opus 5.5 对比文章 |
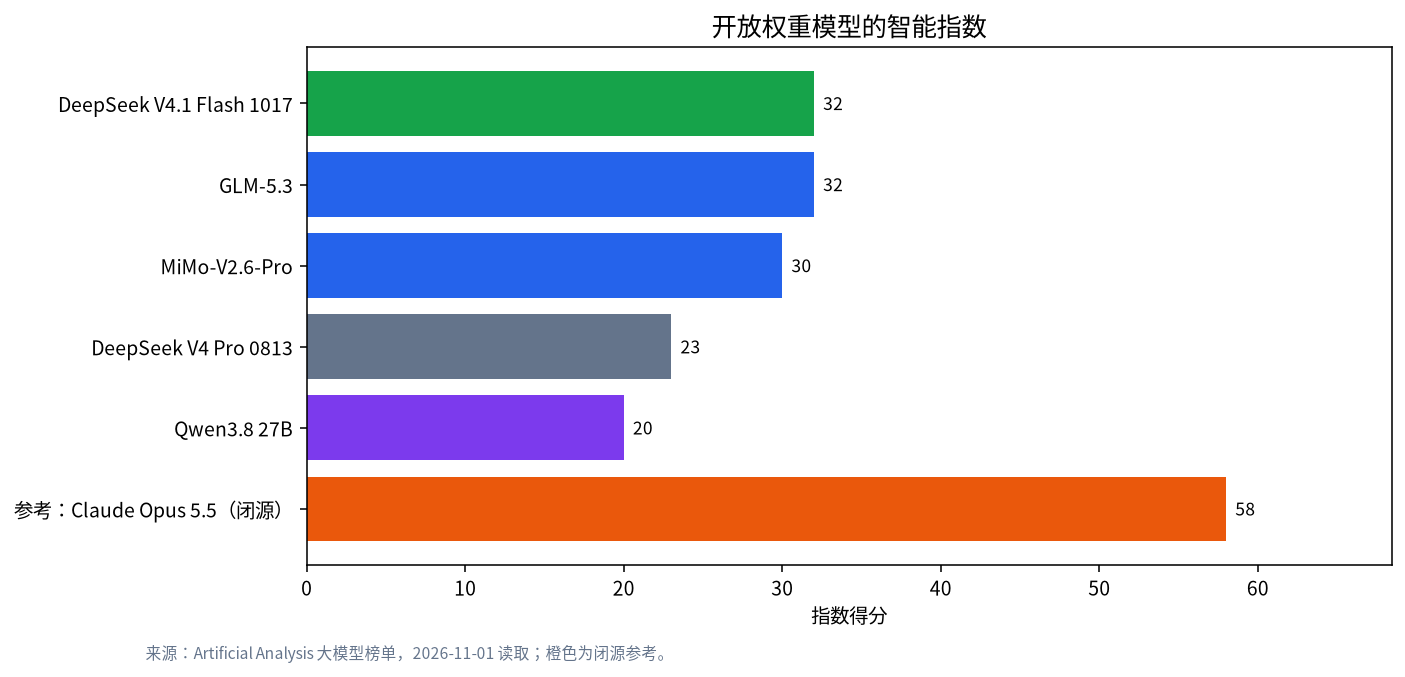
这里有两个要说清楚的地方。一是”并列”:第三方榜单的小数点差异和测试批次都会影响排名,32 对 32 就是同分,不要读成”DeepSeek 更强”。二是”开放”不等于”能在你的机器上跑”:这个模型的 Hugging Face 页面标注约 763B 参数;Unsloth 的指南说它由约 552B 的主干和约 196B 的 Engram 参数组成。对比之下,Qwen3.8 27B 只有 20 分,但体积小得多、硬件门槛低得多(具体显存需求请查模型卡),选择取决于你愿意为分数付出多少硬件。
厂商公布的基准:对比 Opus 5
DeepSeek 在模型卡上给出与 Claude Opus 5 的对比(厂商公布,使用 DeepSeek 自己的评测设置)。
| 基准 | DeepSeek V4.1 Flash 1017 | Claude Opus 5 |
|---|---|---|
| HLE(无工具) | 42.6 | 56.3 |
| Terminal-Bench 4.0 | 42.3 | 51.8 |
| DeepSWE v1.1 | 77.0 | 74.0 |
| ProgramBench | 29.1 | 37.0 |
| NL2Repo | 68.2 | 75.3 |
| AutomationBench v1.0.6 | 60.5 | 50.3 |
| Apex Bench v1.1 | 72.1 | 65.8 |
| Chartography | 83.0 | 84.0 |
八项里,DeepSeek 领先三项(DeepSWE、AutomationBench、Apex Bench),落后五项。要注意:这是 Opus 5,而不是更新的 Opus 5.5;而且这些是厂商自己的数字,和第三方指数相比更乐观。结论是:它不是顶级闭源模型的替代品,但在一部分软件工程和自动化任务上已经接近上一代旗舰。同一份模型卡还给出 Terminal-Bench 4.0 上 GLM-5.3 为 37.9、GPT-5.6 Sol 为 39.9,DeepSeek 为 42.3。
本地部署:体积与内存需求
先说结论:本地跑它的最低门槛,是 Unsloth 的 1 比特动态量化版,官方称在内存加显存合计约 128GB 的机器上可以运行,例如 128GB 的 Mac 或 DGX Spark 一类设备;要得到更稳的质量,需要 256GB 以上。下表来自 Unsloth 的指南。
| 量化版本 | 下载体积(GB) | 粗略的内存加显存需求 |
|---|---|---|
| UD-IQ1_S | 233.0 | 1 比特:约 128–145GB |
| UD-IQ1_M | 250.4 | 1 比特档 |
| UD-IQ2_XXS | 300.5 | 2 比特:约 176–205GB |
| UD-Q2_K_XL | 334.8 | 2 比特档 |
| UD-IQ3_XXS | 394.7 | 3 比特:约 256–290GB(约 256GB 的 Mac Studio 可用) |
| UD-Q4_K_XL | 500.7 | 4 比特:约 305GB |
| UD-Q8_K_XL | 508.4 | 8 比特:约 315GB |
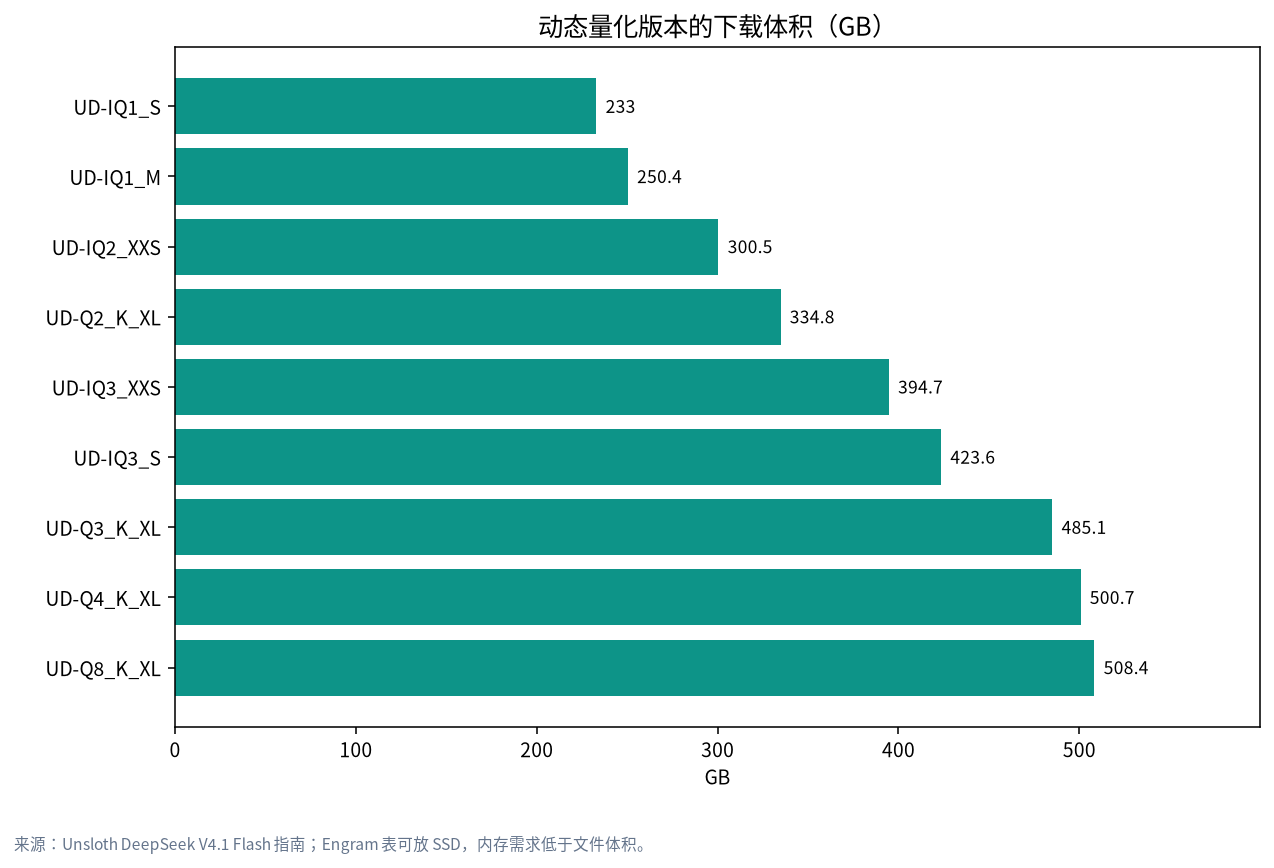
文件体积比”内存需求”大,是因为 Unsloth 说明 Engram 表(约 110.6–202.8GB)可以留在 SSD 上,通过内存映射读取,不必全部装进内存。所以你会看到 233GB 的文件却声称 128GB 内存能跑。这同时意味着一块速度很快的 NVMe 固态硬盘对体验很重要,具体速度我们没有测过。另外 Unsloth 指出,运行它需要其自己维护的 llama.cpp 分支(指南中引用的是 PR #30817),并给出 DSpark 推测解码可以带来 1.3–1.5 倍加速;这些说明读取于 2026-11-01,之后可能已经合并或变化,部署前请再看一遍指南。
量化会损失多少?Unsloth 用六项基准的平均分做了自测:
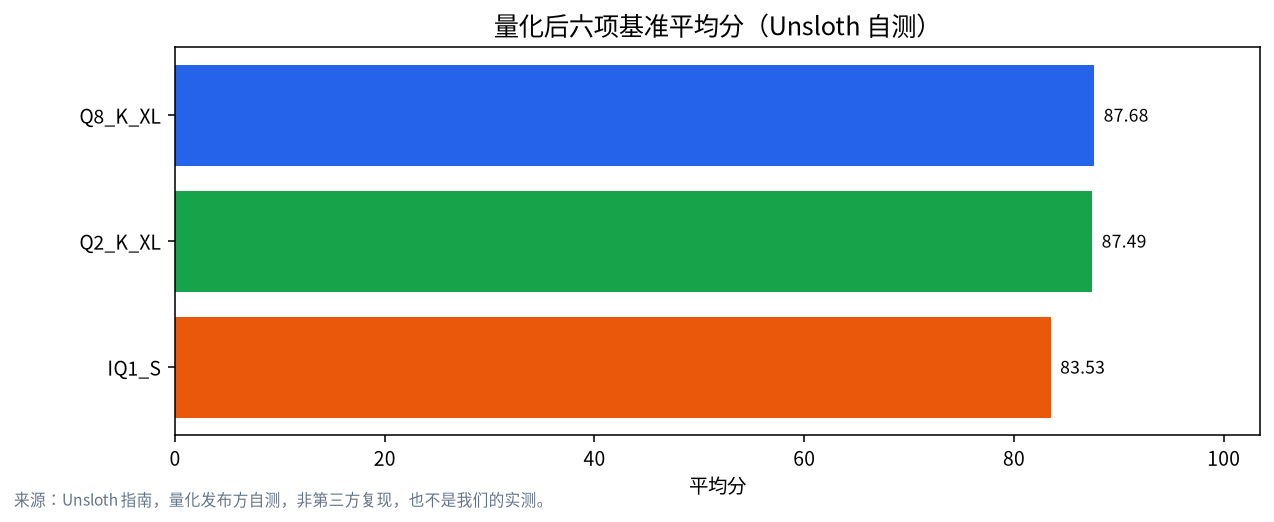
Q8 为 87.68,Q2_K_XL 为 87.49,IQ1_S 为 83.53。也就是说从 8 比特降到 2 比特几乎没掉分,降到 1 比特约掉 4 分。但 Unsloth 同时提醒,量化会让模型的推理输出变长,所以速度和 token 用量也要一起看。这是量化发布方的自测,不是第三方复现。关于量化的基础概念,可以看量化与 Q4_K_M 解读和GGUF 与 llama.cpp 入门。
成本:API 还是自建
DeepSeek 官方定价(2026-11-01 读取):模型名 deepseek-flash 对应 DeepSeek-V4.1-Flash-1017,非高峰每百万 token 输入未命中 0.15 美元、命中 0.003 美元、输出 0.60 美元;高峰时段(工作日 UTC 01:00–04:00 与 06:00–10:00,中国法定节假日除外)价格翻倍。
做一个算例(我们自己的算术):每月输入 5 亿 token,其中 80% 命中缓存,输出 2,000 万 token,全部按非高峰价格计算:命中 4 亿×0.003 美元=1.2 美元,未命中 1 亿×0.15 美元=15 美元,输出 2,000 万×0.60 美元=12 美元,合计约 28.2 美元;若全部落在高峰,约为其两倍,即约 56 美元。对比之下,一台能装下 1 比特或 2 比特版的 128GB 以上内存的机器,价格通常是几千美元以上(我们不引用具体报价,购买前请查当期价格),所以如果只看钱,自建很难回本。选择本地的合理理由是:数据不能出内网、需要离线、要固定版本、要在自己的推理栈里做定制,或者你本来就有这类机器。更多讨论见本地与云端 API 怎么选。
该选哪一档:按硬件对号入座
把上面的数据转成选择,可以参考下表(这是我们基于 Unsloth 公布的需求做的归纳,不是实测,速度未知)。
| 你的机器 | 可考虑的量化 | 需要注意 |
|---|---|---|
| 内存加显存约 128GB(如 128GB 的 Mac 或 DGX Spark 级设备) | UD-IQ1_S | 1 比特,Unsloth 自测平均分约掉 4 分;Engram 表依赖 SSD 读取 |
| 约 176–205GB | UD-IQ2_XXS 或 UD-Q2_K_XL | 2 比特,自测几乎不掉分,是性价比最高的区间 |
| 约 256–290GB | UD-IQ3_XXS | 3 比特,适合 256GB 级整机 |
| 约 320GB 以上 | UD-Q4_K_XL 或 UD-Q8_K_XL | 接近原始精度,成本最高 |
| 低于 128GB | 不建议硬跑 | 改用 API,或换小一档的开放权重模型 |
选档时的思路是:先确定你最多能拿出多少内存加显存,再预留 5–10GB 给运行时与上下文(Unsloth 指南提示实际占用会随上下文长度增加),然后在能放下的档位里选最高的一档。如果你需要长上下文,比如 1M,应当意识到 KV 缓存还会额外占内存,具体可以先读我们的上下文与 KV 缓存显存说明。
还有一个实际的建议:不要一上来就为它采购整机。可以先用官方 API 在你的真实任务上测一周,确认它的输出质量满足需求,再决定要不要为本地化投资。这样即使最后决定不上本地,你也只花了几美元的测试费。
如果显存不够怎么办
大多数读者没有 128GB 以上的内存。常见的降级路线有三条:改用 API,只把敏感部分放本地;改用更小的开放权重模型,例如 Qwen3.8 27B(指数 20),可以参考模型尺寸选择器;或者理解 MoE 模型的内存特点后再决定,见MoE 模型本地运行和内存与显存、CPU 卸载。Mac 用户可以先读 Mac 跑本地大模型,理解统一内存的容量与带宽之间的取舍。更早的 DeepSeek 蒸馏小模型部署,可以看DeepSeek 本地部署教程。
自己复现:测试方法
我们没有实测,下面是你可以自己跑的方法,用来决定该用哪一档量化,或是否值得本地化。
- 准备 20 条自己的真实提示词,包含 5 条编程、5 条长文总结、5 条中文写作、5 条需要多步推理的题。
- 固定采样参数:模型卡建议温度 1.0、top_p 1.0,并为推理预留较大的 max_tokens(卡片建议不低于 256K)。
- 对每个量化档位各跑一遍,记录:答案是否正确(人工评分 0–2)、生成 token 数、每秒 token 数、首 token 延迟、峰值内存。
- 对照 API 版本:用同样提示词跑一遍官方 API,把它当作”满精度参照”,看你的量化版掉多少分。
- 记录推理长度:同一题在不同量化下输出的 token 数,验证 Unsloth 所说的”量化后推理变长”。
请解决下面的问题,先简要思考再给出最终答案。
问题:<粘贴你的真实任务>
要求:最终答案放在“答案:”之后,不超过 200 字。
常见错误
- 把”并列第一”读成”全面领先”:32 对 32 是同分,而且与闭源旗舰的 58 分差距很大。
- 只看下载体积:233GB 的文件不等于需要 233GB 内存,反过来内存够了也不等于速度够,Engram 表在 SSD 上时磁盘速度很关键。
- 忽略量化对推理长度的影响:分数没掉,但输出变长,成本和延迟会变。
- 拿厂商表格当全面结论:DeepSeek 的对比对象是 Opus 5,而且五项落后。
- 没看软件版本要求:这类新模型常常需要特定分支或新版本的推理框架。
相关阅读
常见问题:DeepSeek V4.1 Flash 1017
DeepSeek V4.1 Flash 1017 是最好的开源模型吗?
在 Artificial Analysis 智能指数上,它与 GLM-5.3 并列开放权重第一,都是 32 分。”最好”取决于你的任务,建议用自己的提示词再测。
DeepSeek V4.1 Flash 1017 本地运行需要多少内存?
Unsloth 给出的内存加显存需求是:1 比特约 128–145GB,2 比特约 176–205GB,4 比特约 305GB。Engram 表可以放在 SSD 上,所以下载体积比内存需求大。
一张 24GB 显卡能跑它吗?
单靠 24GB 显存放不下:Unsloth 给出的最低是内存加显存合计约 128GB,所以 24GB 显卡加上足够大的系统内存与 SSD 才有可能,速度我们没有测。24GB 显卡的常规用法见我们的 24GB 显存指南,更适合运行小一档的模型。
API 和本地哪个更便宜?
API 通常便宜得多:按我们的算例,每月 5 亿输入、2,000 万输出约 28 美元(非高峰)。本地的理由是隐私、离线和可控,而不是省钱。
它的许可证是什么?
Hugging Face 模型卡标注为 MIT 许可。部署前请自己再确认一次最新的许可文本。
它和 Claude Opus 5.5 差多少?
第三方指数上是 32 对 58。DeepSeek 自己的表格是和 Opus 5 比,在八项里领先三项;与 Opus 5.5 没有直接的官方对比。
和我们聊聊
在为团队规划 128GB 以上内存的推理机器?欢迎到社区交流,或者发邮件到 admin@microaione.com。
参考资料:Hugging Face:DeepSeek-V4.1-Flash-1017 模型卡、Unsloth:DeepSeek V4.1 Flash 本地运行指南、DeepSeek API 定价、Artificial Analysis 大模型榜单。