大模型为什么需要GPU而不是CPU:显存带宽与算力的通俗解释(含速度上限算例)
打开任何一个本地部署教程,第一句几乎都是“先看你的显卡”。大模型为什么需要GPU而不是CPU? 很多人的第一反应是“GPU 算力更强”,这只说对了一半。真正决定你每秒能生成多少字的,往往不是算力,而是数据搬运的速度,也就是显存带宽。这篇文章用最少的公式讲清两件事:一次回答里有哪两个阶段、各自卡在哪里;以及 GPU 到底比 CPU 快在哪里、快多少、CPU 什么时候其实也够用。文章里的速度全部是按公式推算的理论上限,不是实测,我们会在每个地方标明。想先弄懂显存本身,可以看显卡显存选购指南,想算一个模型要多少显存,用显存计算器指南。
要点速览(更新于 2026-11-04)
- 生成每个新词(解码)要把模型权重从内存读一遍,速度上限约等于“内存带宽 ÷ 模型字节数”,所以是带宽问题。
读完提示词(预填充)是大量矩阵乘法,是算力问题,GPU 的上万个并行核心在这里优势最大。
以 8B Q4_K_M(约 4.9GB)为例:DDR5-5600 双通道理论带宽 89.6GB/s,上限约 18 token/s;RTX 4090 带宽 1008GB/s,上限约 206 token/s。真实速度更低。
70B Q4_K_M(约 43.1GB)一部分放内存,整体速度会被内存部分拖慢:算例中上限从约 23.4 降到约 3.6 token/s。
CPU 不是不能用:小模型、MoE 模型、短提示词、不赶时间的场景,CPU 或 Apple 统一内存都可以接受。
大模型为什么需要GPU而不是CPU:先看一次回答的两个阶段
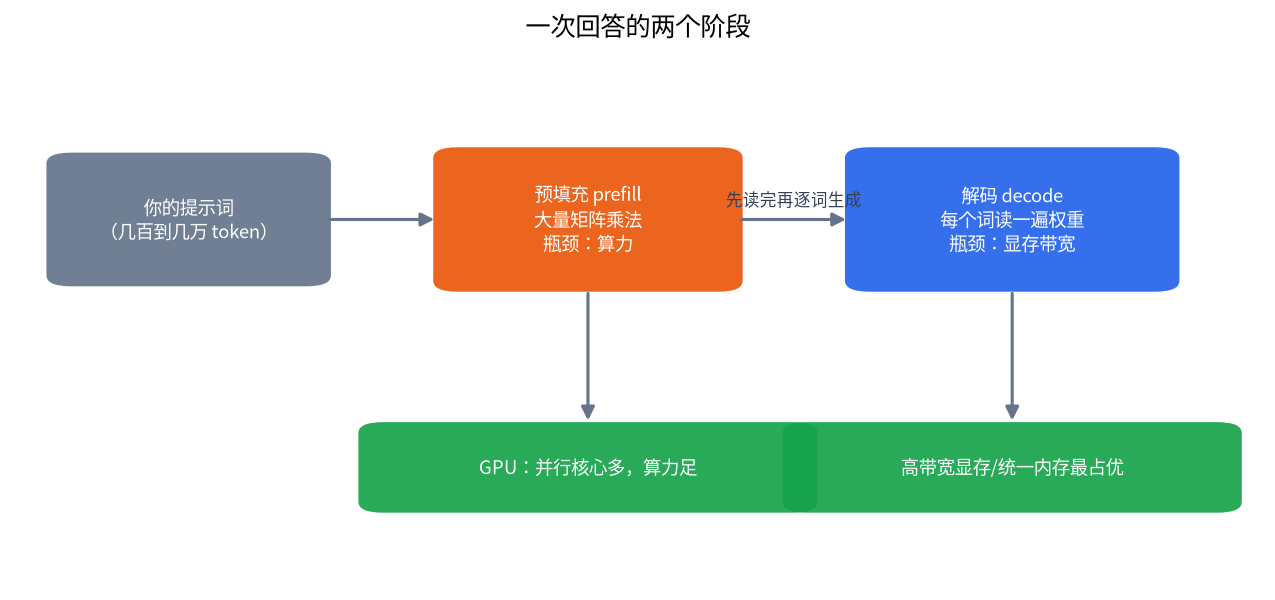
一次完整的回答分成两段,物理瓶颈完全不同。
| 阶段 | 做什么 | 主要瓶颈 | 谁占优势 |
|---|---|---|---|
| 预填充(prefill) | 一次性读完你的提示词,建立上下文 | 算力(矩阵乘法的次数) | GPU:几千到上万个并行核心 |
| 解码(decode) | 一个词一个词地生成回答 | 内存带宽(每个词都要读一遍权重) | 显存带宽高的设备:GPU、Apple 统一内存 |
预填充时,成百上千个词同时进入模型,同一批权重被反复使用,计算量大、数据搬运相对少,所以受限于算力。解码时每次只生成一个词,却仍要把全部(或全部激活的)权重读一遍,计算量小、搬运量大,所以受限于带宽。NVIDIA 在推理优化的技术文章里也是这样区分的:解码阶段是内存受限(memory-bound)。
速度上限怎么算:带宽 ÷ 模型字节数
解码阶段有一个很好用的估算:
每秒生成 token 数的上限 ≈ 内存带宽(GB/s)÷ 每个 token 要读取的权重大小(GB)
对普通的稠密模型,每个 token 要读完整个模型。llama.cpp 官方量化文档给出 Llama-3.1-8B 的 Q4_K_M 约 4.9GB,我们就用 4.9GB 代入。内存带宽取各厂商公布的规格:
| 设备 | 带宽(GB/s) | 8B Q4_K_M 上限(token/s) | 备注 |
|---|---|---|---|
| DDR5-5600 双通道 | 89.6 | 约 18.3 | 5600MT/s × 8 字节 × 2 通道,峰值 |
| RTX 4060 Ti 16GB | 288 | 约 58.8 | NVIDIA 规格 |
| RTX 3060 12GB | 360 | 约 73.5 | NVIDIA 规格 |
| RTX 5060 Ti 16GB | 448 | 约 91.4 | NVIDIA 规格 |
| Apple M4 Pro | 273 | 约 55.7 | Apple 官方规格,统一内存 |
| Apple M4 Max(40 核 GPU 版) | 546 | 约 111.4 | Apple 官方规格,统一内存 |
| RTX 3090 | 936.2 | 约 191.1 | NVIDIA 规格 |
| RTX 4090 | 1008 | 约 205.7 | NVIDIA 官方:16,384 个 CUDA 核心,384 位 GDDR6X |
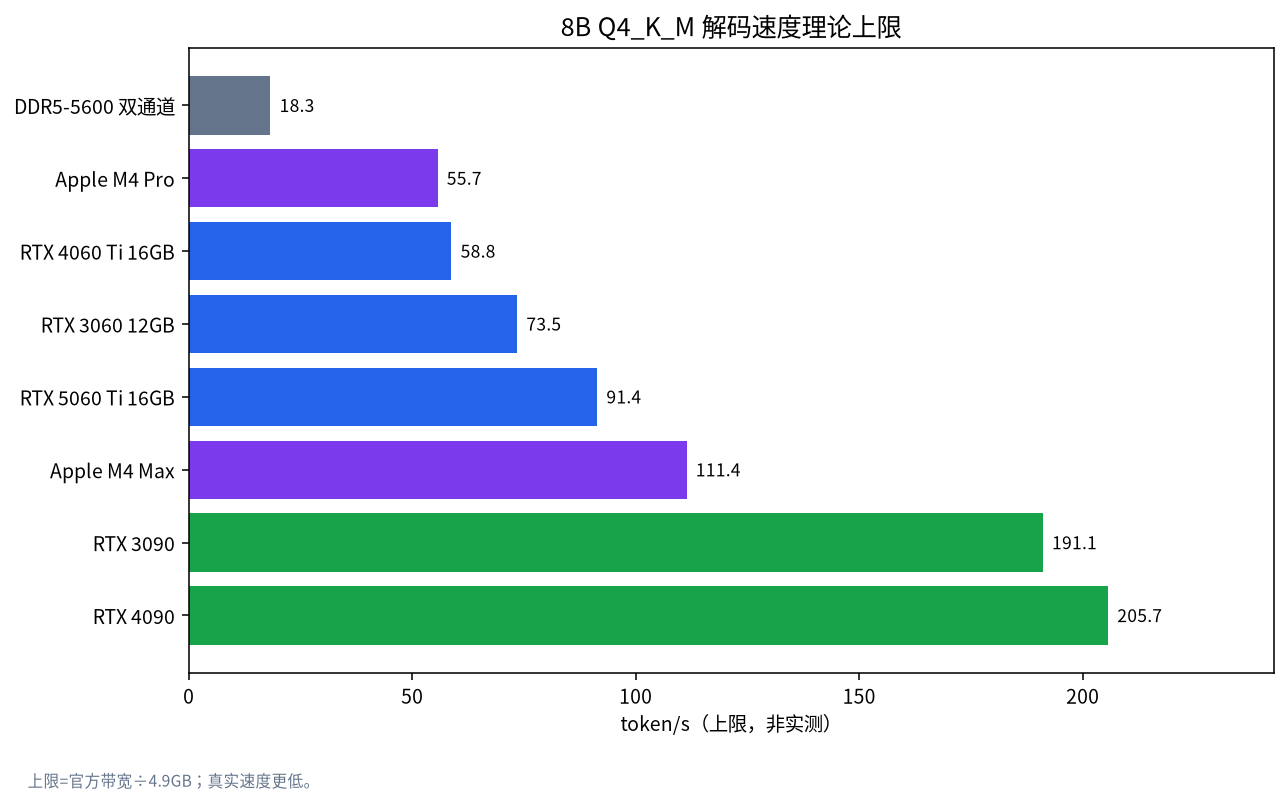
这张表有三个读法。第一,同一个模型,换更高带宽的设备,上限几乎成比例提高:4090 比 DDR5 双通道高出约 11 倍,和带宽比(1008÷89.6≈11.25)一致。第二,显存容量和速度是两件事:RTX 4060 Ti 16GB 比 3060 12GB 容量大,但带宽反而更低,所以小模型上它的速度上限更低。第三,这些都是“理想上限”:实际受内核效率、KV 缓存读取、调度开销影响,通常明显低于上限。我们没有在这些设备上实测,如果要看真实基准怎么读,参考基准测试怎么看。
为什么GPU的并行算力在预填充里最占便宜
预填充的计算量可以粗略估算为:浮点运算次数 ≈ 2 × 参数量 × 提示词 token 数(这是业界常用的近似)。以 8B 模型读 4096 个 token 的提示词为例:
2 × 8×10⁹ × 4096 ≈ 6.55×10¹³ 次运算,也就是约 65.5 TFLOP。
所需时间 = 运算量 ÷ 有效算力。有效算力取决于硬件和软件,我们不拿任何具体型号的数字来编造,改用“假设值”看数量级:
| 假设的有效算力 | 预填充 4096 token 所需时间 |
|---|---|
| 1 TFLOPS | 约 65.5 秒 |
| 10 TFLOPS | 约 6.6 秒 |
| 50 TFLOPS | 约 1.3 秒 |
| 100 TFLOPS | 约 0.66 秒 |
上表的算力是说明数量级用的假设,不是任何产品的测量值。重点在于:提示词越长(文档问答、长上下文),预填充越吃算力,CPU 的体感就是“要等很久才开始出第一个字”,而 GPU 通常在一两秒内就开始输出。核心数的差距是原因之一:RTX 4090 有 16,384 个 CUDA 核心,主流桌面 CPU 通常是 6 到 24 个核心。
放不下显存会怎样:70B 的卸载算例
很多人的实际情况是“显存不够,一部分放内存”。这时速度由最慢的那部分拖住。以 70B Q4_K_M(约 43.1GB)为例,假设一张 RTX 4090(24GB,1008GB/s)放 20GB 权重,其余 23.1GB 放在 DDR5-5600 双通道内存(89.6GB/s):
- 每个 token 的读取时间 = 20 ÷ 1008 + 23.1 ÷ 89.6 ≈ 0.0198 + 0.2578 = 0.2776 秒
- 速度上限 ≈ 1 ÷ 0.2776 ≈ 3.6 token/s
对比两个极端:如果 43.1GB 全在一块足够大的高带宽显存里(比如假设 1008GB/s),上限约 23.4 token/s;如果全放 DDR5 内存、纯 CPU,上限约 2.1 token/s。
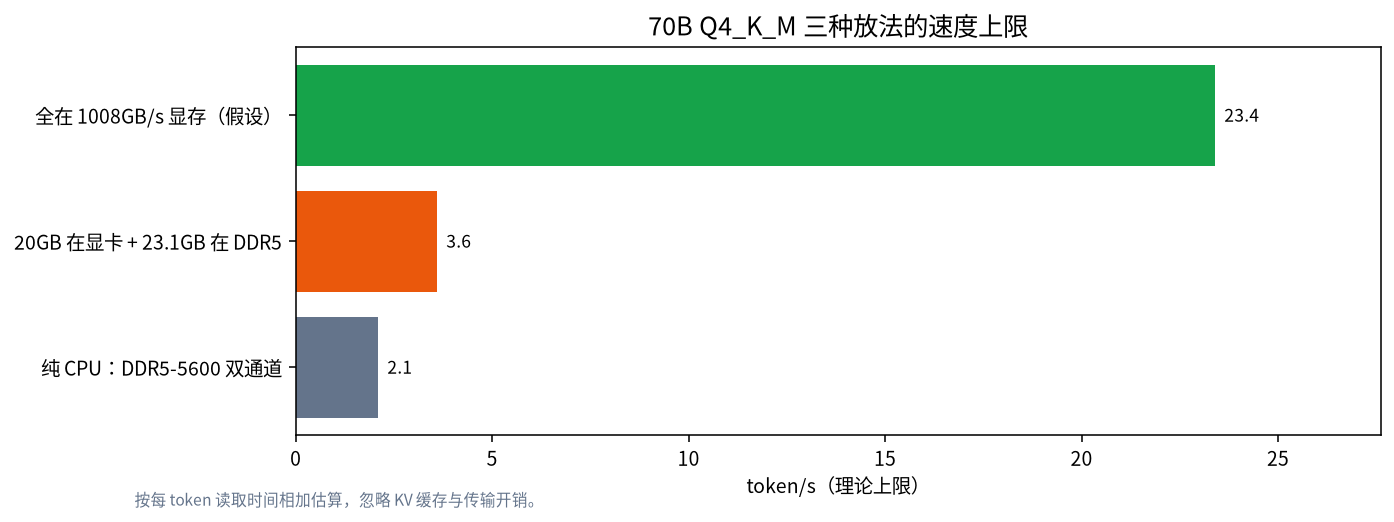
可以看到,放进显卡的比例只有 46%,速度上限却只回到纯 CPU 的 1.7 倍左右,因为慢的那一段决定了总时间。这就是为什么“显存不够,用内存凑”常常很让人失望,也是为什么我们建议先看内存与显存、CPU 卸载的取舍再决定买什么。算例忽略了 KV 缓存与通信开销,真实值会更低。上下文变长时 KV 缓存还会额外吃显存,见上下文长度与 KV 缓存。
CPU 什么时候也够用
“GPU 更好”不代表 CPU 一无是处,下面几种情况 CPU 或统一内存是合理选择:
| 场景 | 为什么可行 | 注意 |
|---|---|---|
| 1B–4B 的小模型 | 文件小,每个 token 要读的字节少,理论上限比 8B 更高 | 回答质量受模型本身限制 |
| MoE 模型 | 每个 token 只读被激活的专家,字节数远小于总参数 | 仍要装得下全部权重,见MoE 本地部署 |
| 短提示词、偶尔使用 | 预填充很短,等待可接受 | 长文档问答会明显变慢 |
| Apple 芯片 | 统一内存带宽高(M4 Pro 273GB/s、M4 Max 546GB/s) | 容量与价格要权衡,见Mac 跑本地大模型 |
| 批量处理、不赶时间 | 夜间跑完即可 | 功耗与时长要算清 |
另外,NPU 与“AI PC”的角色要分开看:它们擅长低功耗的小模型任务,不是大模型解码的带宽解决方案,详见AI PC 与 NPU 解析。多用户同时请求时,GPU 还可以把多个请求合并(批处理),让同一次权重读取服务多个请求,吞吐大幅提高,这是 vLLM 之类服务框架的价值,见vLLM 与 SGLang 入门。
一个小技巧:用公式识破夸张的速度宣传
学会“带宽 ÷ 模型字节数”之后,可以反过来检验任何速度宣传。步骤是:速度(token/s)× 模型文件大小(GB)= 至少需要的有效带宽(GB/s)。例如有人声称在 DDR5-5600 双通道的电脑上,用 CPU 跑 8B Q4_K_M(约 4.9GB)达到 30 token/s,那么隐含的带宽是 30 × 4.9 = 147GB/s,高于该内存 89.6GB/s 的理论峰值,对稠密模型来说这个数字就不可能成立。可能的解释有:模型其实是 MoE(每个 token 只读一部分权重)、量化档位更低、用了投机解码、统计的是预填充速度或批处理总吞吐,或者干脆是测量口径不同。我们不判断具体某个宣传是否属实,只是提供一个自查方法:先算隐含带宽,再看它有没有超过设备的规格上限。 看基准的更多注意事项见基准测试怎么看。
买硬件时的结论:先看显存容量,再看带宽
把上面的内容压缩成选购规则:第一,容量决定“能不能整个放进去”,放不下速度会断崖式下降;第二,在能放下的前提下,带宽决定速度上限,带宽高的卡更快,不能只看显存大小;第三,预填充吃算力,长提示词场景要选算力足的 GPU;第四,别指望纯 CPU 跑 70B 级别的稠密模型,上限只有 2 token/s 左右。具体选型可以回到模型尺寸选择指南与硬件专区。
我们怎么核对,没做什么
带宽数字来自 NVIDIA 与 Apple 的官方规格页,文件大小来自 llama.cpp 量化文档,内存带宽按 DDR5 的传输速率换算为峰值。速度上限与卸载算例是我们按公式自己计算的理论值;预填充表中的有效算力是说明数量级的假设。我们没有在这些设备上做过任何实测,真实速度会更低,且随软件版本、量化类型、上下文长度变化。
常见问题
大模型一定要用GPU吗?
不一定。CPU 也能运行,llama.cpp 等工具都支持纯 CPU。但大模型解码受内存带宽限制,CPU 内存带宽通常只有显卡的几分之一到十几分之一,所以速度明显更慢。
为什么显存带宽比显存容量更影响速度?
容量决定模型能不能放下,带宽决定每秒能读多少次权重。放得下之后,速度上限约等于带宽除以模型大小,所以带宽越高越快。
8B 模型在 CPU 上大概能到多快?
以 DDR5-5600 双通道为例,8B Q4_K_M 的理论上限约 18 token/s,实际会更低。这是公式推算,不是我们的实测。
内存大就能跑 70B 吗?
能装下不等于跑得快。70B Q4_K_M 约 43.1GB,纯 DDR5 双通道的理论上限约 2 token/s,部分卸载到显卡也会被内存部分拖慢。
MoE 模型为什么更适合 CPU?
MoE 每个 token 只激活一部分专家,需要读取的权重字节数少,对带宽的要求相对低,但全部权重仍要装进内存。
NPU 能替代GPU 跑大模型吗?
目前主要用于低功耗的小模型与系统功能,带宽与软件生态不足以替代独立显卡跑大模型,详见我们的 NPU 解析。
想算算你的机器能跑多快?
欢迎到社区交流,或发邮件到 admin@microaione.com,告诉我们你的显卡、内存和想跑的模型,我们按本文的公式帮你估一个上限,并给出选型建议。
参考资料:NVIDIA:LLM 推理优化技术、NVIDIA GeForce RTX 4090 规格、Apple 发布 M4 Pro 与 M4 Max、llama.cpp 量化文档。读取日期 2026-11-04。