DeepSeek R1 蒸馏版尺寸详解:1.5B 到 70B 该按显存怎么选
当有人说在笔记本上跑 “DeepSeek R1” 时,几乎从来不是指那个登上新闻头条的 6710 亿参数的大模型,而是指某个较小的 DeepSeek R1 蒸馏版尺寸:参数量从 1.5B 到 70B 的模型,它们用大模型生成的推理数据微调而成。它们很有用,但是不同的模型,底座家族也不一样,选错尺寸要么浪费内存,要么浪费时间。这篇文章讲每个尺寸究竟是什么、在 Ollama 上下载多大、推理模型为什么比聊天模型更需要上下文,以及怎样按显存选尺寸。安装步骤请看DeepSeek 本地部署教程。
核对说明:模型家族和许可证来自 DeepSeek-R1 在 Hugging Face 上的模型卡,下载大小和默认标签来自 Ollama 库页面,均在 2026-10-30 读取。内存总量是我们根据这些大小和 KV 缓存大小推算的,不是实测。我们不引用任何评测分数,也不判断蒸馏版有多接近完整模型。
要点速览(更新于 2026-10-30)
- 蒸馏版是其他开源模型的微调版本:1.5B、7B、14B、32B 基于 Qwen2.5,Llama 系列基于 Llama 3.1 8B 和 Llama 3.3 70B;在 Ollama 上默认的
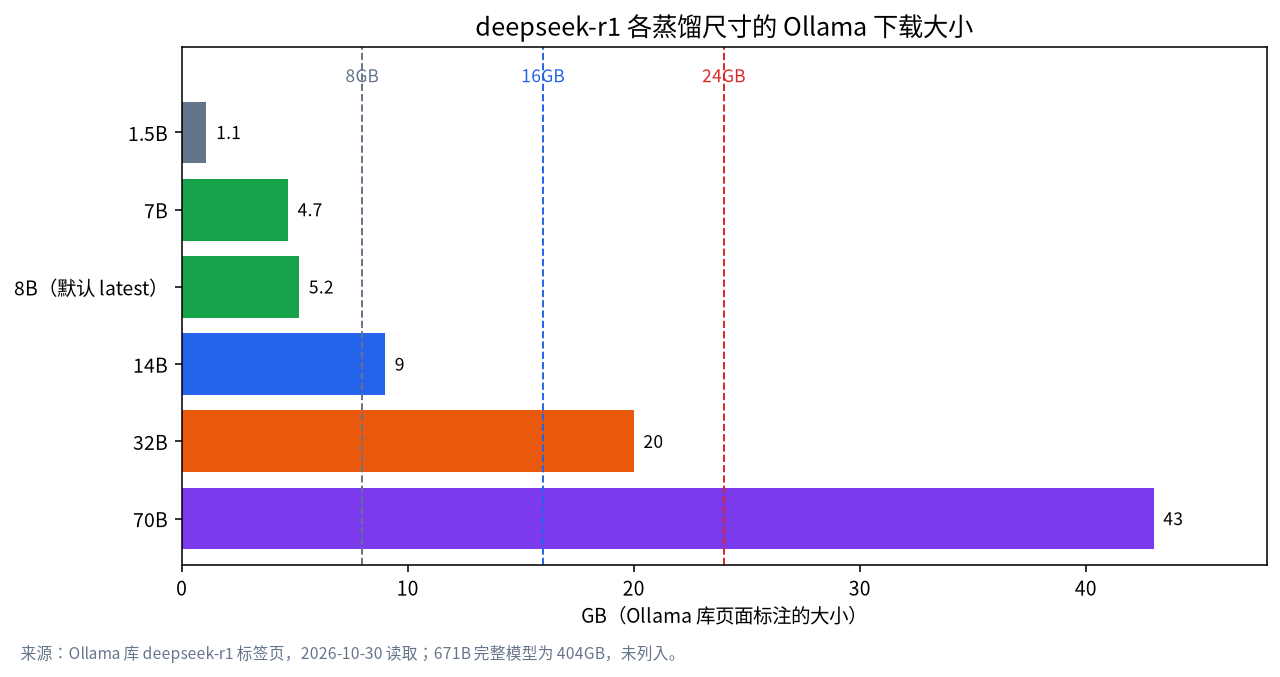
deepseek-r1标签是 8B 模型,库页面说明它已更新为 DeepSeek-R1-0528-Qwen3-8B。Ollama 标注的下载大小:1.5B 为 1.1GB,7B 为 4.7GB,8B 为 5.2GB,14B 为 9.0GB,32B 为 20GB,70B 为 43GB,而完整的 671B 模型是 404GB。
推理输出很长,所以要为上下文留预算:按我们的推算,32B 蒸馏版在 8K 上下文时约 22GB,16K 时约 24GB,在 24GB 显卡上已经很紧。
蒸馏版到底是什么
DeepSeek-R1 的模型卡描述了一个模型家族:拥有 671B 总参数的大型混合专家模型 DeepSeek-R1,以及一组用它整理的约 80 万条样本微调出来的较小稠密模型。模型卡列出了六个蒸馏版及其底座:Qwen2.5-Math-1.5B、Qwen2.5-Math-7B、Llama-3.1-8B、Qwen2.5-14B、Qwen2.5-32B 和 Llama-3.3-70B-Instruct。通俗地说,就是有人拿一个现成的小模型,教它像大模型那样写出很长的推理链。结果是它会把思考过程说出来,这对数学和逻辑有帮助,但回答要等很久才出来,而且很长。
不要把名字理解成“一个小号的 DeepSeek-R1”。蒸馏版保留了底座模型的架构、长处和短处:基于 Qwen 的表现像带着推理习惯的 Qwen,基于 Llama 的则像 Llama。所以光看尺寸不能决定质量,底座和任务同样重要。我们的最佳本地模型指南对模型家族有更广泛的比较。
Ollama 上的命名陷阱
在 Ollama 上,ollama run deepseek-r1 并不会下载 671B 的模型。库页面显示 latest 标签与 8B 标签是同一个镜像,大小 5.2GB,页面的说明写着 8B 蒸馏模型已升级为 DeepSeek-R1-0528-Qwen3-8B。这和 Hugging Face 模型卡里基于 Llama 的原版 8B 不是同一个,所以两篇都说 “R1 8B” 的文章,可能说的是不同的模型。如果需要指定版本,请拉取明确的标签,比如 deepseek-r1:14b,并在标签页核对摘要和日期。完整模型是 deepseek-r1:671b,大小 404GB,远超消费级硬件。
| 标签 | 底座家族 | Ollama 大小 | 现实的硬件 |
|---|---|---|---|
| 1.5b | Qwen2.5 Math | 1.1GB | 几乎任何机器 |
| 7b | Qwen2.5 Math | 4.7GB | 8GB 显存或较新的 CPU |
| 8b | Qwen3(0528 更新) | 5.2GB | 8GB 到 12GB 显存 |
| 14b | Qwen2.5 | 9.0GB | 12GB 到 16GB 显存 |
| 32b | Qwen2.5 | 20GB | 24GB 显存,短上下文 |
| 70b | Llama 3.3 | 43GB | 48GB 以上,或大容量统一内存 |
| 671b | DeepSeek-V3 底座 | 404GB | 服务器级 |
为什么推理模型比大小看起来更吃内存
普通聊天模型几百个 token 就答完了。推理模型先写一大段思考,再给出答案,遇到难题时思考部分可以长达几千个 token。每个 token 都留在 KV 缓存里,所以内存占用随思考变长而增长。模型卡说明其评测把最大生成长度设为 32,768 个 token,可见输出能有多长。
按上下文长度指南里的 KV 大小,f16 缓存每个 token 的开销是:14B(Qwen2.5-14B 架构)约 192KiB,32B 约 256KiB,70B 约 320KiB。得到下面的总量,其中包含 Ollama 的权重大小,但不含运行开销。
| 蒸馏版 | 权重(Ollama) | 8K 上下文总量 | 16K 上下文总量 |
|---|---|---|---|
| 14B | 9.0GB | 约 10.5GB | 约 12GB |
| 32B | 20GB | 约 22GB | 约 24GB |
| 70B | 43GB | 约 45.5GB | 约 48GB |
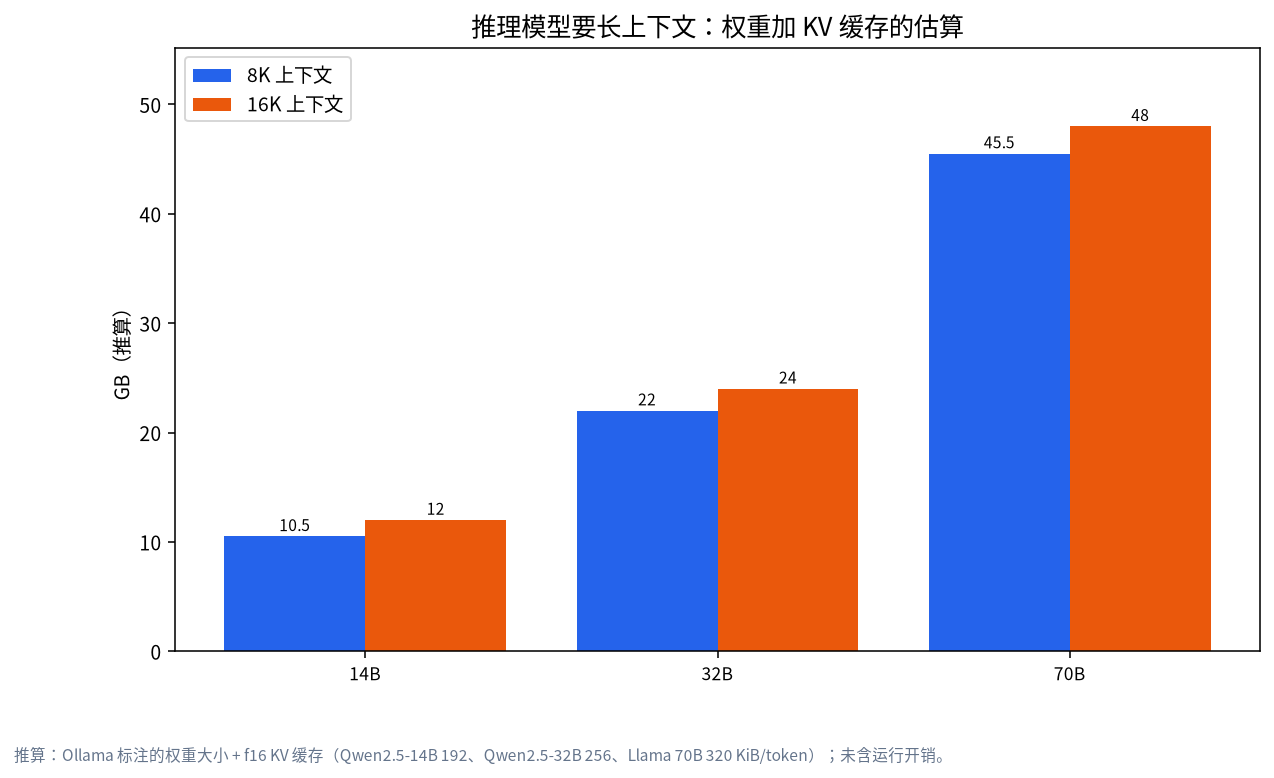
请把它当作提醒而不是保证。32B 蒸馏版只有在上下文较短时才能放进 24GB 显卡,一个又长又难的问题就可能超出,那时它要么报错,要么缩短上下文,要么溢出到系统内存而大幅变慢。如果你用的是 24GB 显卡,怎样装下上下文见24GB 显存指南。
DeepSeek R1 蒸馏版尺寸:什么显存选什么
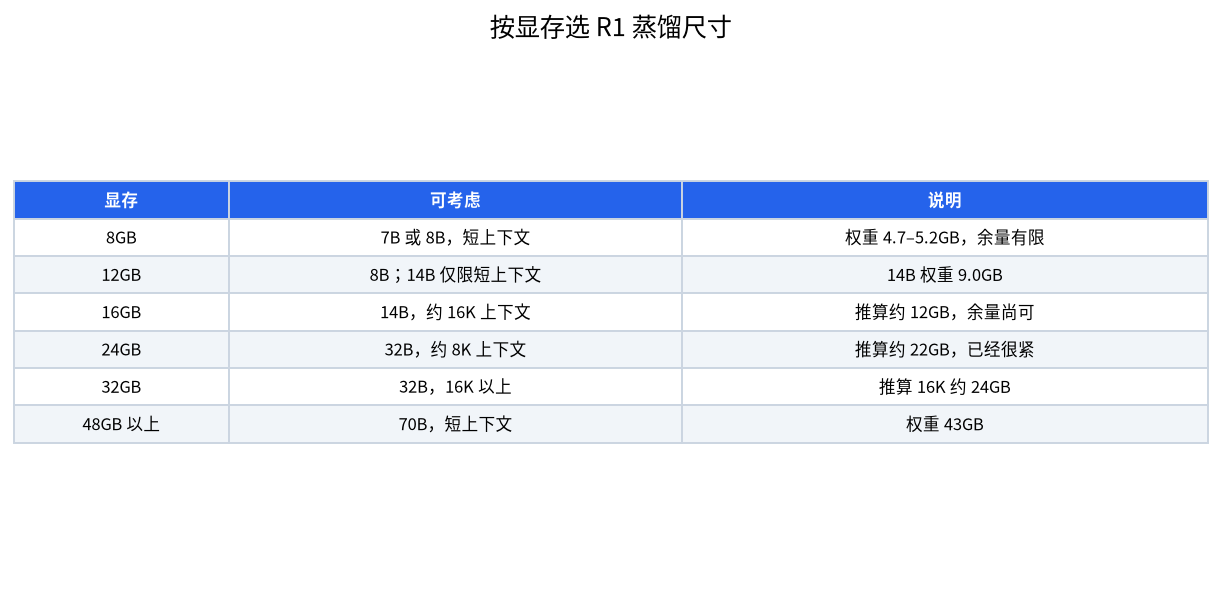
8GB 的显卡上,7B 和 8B 蒸馏版是现实的选择,上下文要短,详见8GB 显存指南。12GB 时,8B 可以从容运行,14B(9.0GB)只有在上下文较短时才放得下。16GB 时,14B 是最合适的,按我们的推算 16K 上下文约用 12GB,这个档位的显卡见12GB 与 16GB 显存指南。24GB 时,32B 可以配大约 8K 的上下文。32GB 时,32B 有空间放 16K 以上。70B 需要约 48GB 或更多,这可能意味着两块显卡,参见双显卡指南,或者一台大容量统一内存的机器。
如果拿不定主意,模型大小选择指南会从你的任务出发帮你选,而显存指南讲了这些表格背后的估算方法。
思考时间:一个可以算出来的速度上限
因为模型在回答之前要写一大段思考,速度比聊天模型更重要:你等的是思考,而不仅仅是答案。粗略的上限来自内存带宽除以每生成一个 token 读取的字节数,稠密模型大致就是权重大小。这些是推算的上限,不是实测的速度,真实结果更低。14B 蒸馏版(9.0GB)在带宽 448 GB/s 的 RTX 5060 Ti 上,上限约为每秒 50 个 token。32B 蒸馏版(20GB)在带宽 936 GB/s 的 RTX 3090 上约 47,在带宽 1,008 GB/s 的 RTX 4090 上约 50。如果模型在回答之前思考 2,000 个 token,在上限下大约是 40 秒,实际会更久。
这就是为什么即使更大的尺寸放得下,小一点的蒸馏版有时反而是更好的选择。如果你要问很多简单快速的问题,思考快的 14B 可能比让你久等的 32B 更合适。对准确度比速度更重要的难题,大一点的也许值得等。没有测试,我们没法告诉你哪个更适合你的任务,我们也不引用分数。
定下尺寸之前先测试
不要只看表格就做选择。从你真实的工作里挑三个问题:一个简单的、一个中等的、一个你知道很难的。先在较小的尺寸上用相同设置跑一遍,再换更大的一档。记下得到最终答案的时间、答案是否正确,以及模型运行时 ollama ps 显示的内存使用情况。如果较小的尺寸三个都答对了,就到此为止。如果只是难题没答对,就判断这类任务是否常见到值得为它多花内存和等待时间。把结果记成一份简短的笔记,新模型出现时可以重复测试。
留意两个说明尺寸对你的硬件太大的信号。一个是 ollama ps 的 Processor 一栏显示 CPU 和 GPU 分担,说明部分模型溢出到了系统内存。另一个是在很长的回答后半段速度突然下降,通常意味着上下文增长到了放不下的程度。解决办法是换更小的尺寸、缩短上下文,或者使用更低精度的缓存,见量化指南。
什么时候不该用推理模型
推理蒸馏版并不是什么都适合。闲聊、简短的改写、翻译或简单查询,用同尺寸的普通指令模型通常更快,也没有那么长的思考部分。把 R1 蒸馏版留给数学、逻辑题、规划和受益于分步思考的代码,其余的用普通模型。许多人在同一个界面里同时挂两种模型,按任务切换,这样也能把上下文预算留给真正需要的任务。
设置上要注意的事
模型卡给出了适用于整个 R1 系列的使用建议。把温度设在 0.5 到 0.7 之间,推荐 0.6,以免无休止的重复或不连贯的输出。避免使用系统提示词,把所有指令都写在用户提示里。对于数学题,模型卡建议要求逐步推理,并把最终答案放进方框。它还指出这些模型有时会跳过思考,如果需要充分的推理,建议强制回答以一个思考标签开头。前端和 Ollama 对这些细节的处理可能不同,所以请核对你用的工具怎么处理思考部分;有的会隐藏它,有的会把它算进上下文。
量化与较小的尺寸
上面所有 Ollama 的大小都是量化后的文件,大致是 Q4_K_M,所以下载大小已经包含了压缩。再往下用 3 位或 2 位的文件可以节省内存,但会牺牲质量,推理模型对此尤其敏感,因为思考早期的一个小错误可能让后面全部跑偏。如果某个尺寸放不下,通常更明智的做法是用标准量化往下降一档,而不是把更大的模型硬塞进更狠的压缩文件。
许可证与商用
模型卡说明权重和代码仓库采用 MIT 许可证,并且该系列支持商用和蒸馏。它还补充说,基于 Qwen 的蒸馏版来自 Qwen2.5,原许可证为 Apache 2.0,基于 Llama 的蒸馏版来自 Llama 3.1 和 Llama 3.3,带有它们各自的许可证。如果打算商用,请阅读具体底座模型的许可证,因为条款不同。
常见错误
- 把所有 R1 变体都叫 “DeepSeek R1”。 蒸馏版和 671B 的原版是不同的模型。
- 拉取
deepseek-r1就以为是基于 Llama 的 8B。 默认标签现在是基于 Qwen3 的 0528 版 8B。 - 只按权重来估算大小。 长推理需要的 KV 缓存远多于普通聊天。
- 使用系统提示词和很低的温度。 模型卡两者都不推荐。
- 指望 32B 在 24GB 上长上下文也跑得好。 即使 16K 也很紧。
- 忽略底座的许可证。 请核对底座模型的许可证。
常见问题
16GB 显存该跑哪个 DeepSeek R1 蒸馏版?
14B。权重约 9.0GB,按我们的估算 16K 上下文时总量约 12GB,还留有空间。
8GB 显卡选 7B 还是 8B?
两个都能在短上下文下放下。Ollama 上的 8B 标签是较新的基于 Qwen3 的模型,可以先试它,再用你自己的任务对比。
家里能跑完整的 671B DeepSeek R1 吗?
Ollama 的下载大小是 404GB,需要服务器级内存,不是消费级显卡的选项。
为什么推理模型遇到长问题就内存不足?
思考文字留在 KV 缓存里,内存随它的长度增长。请缩短上下文或换更小的尺寸。
蒸馏版和完整模型一样好吗?
我们不引用评测对比。它们是用推理数据微调的较小模型,请用你自己的任务测试。
需要系统提示词吗?
模型卡建议避免使用,把指令放在用户提示里。
和我们聊聊
不确定哪个尺寸适合你的显卡?欢迎到社区提问,或者发邮件到 admin@microaione.com。
参考资料:DeepSeek-R1-Distill-Qwen-32B 模型卡、DeepSeek-R1 论文、Ollama deepseek-r1 模型库、Ollama deepseek-r1 标签页。