Kimi 本地部署:要求、步骤与成本(K2/K3)
「kimi 本地部署」最近搜索量很高,尤其是月之暗面在 2026 年 7 月开放 Kimi K3 权重之后。先说结论:Kimi 确实可以在本地或私有机房运行,但它不是一个“显卡够好就能跑”的模型——K2 是约 1 万亿参数、K3 是约 2.8 万亿参数的 MoE 模型,光权重就是 TB 级。本文按官方模型卡整理两代模型的参数、配置要求、部署步骤、许可证要点和成本区间,并告诉你在个人电脑上更现实的替代方案。
核对说明:参数与文件体积来自 Hugging Face 上 moonshotai 官方仓库的模型卡(2026-11-05 查阅)。硬件与成本是团队按公开规格与市场行情做的区间估算,不是报价,也不是实测。Kimi 版本迭代快,部署前请以 Kimi K3 模型卡 和官方部署文档为准。
要点速览(更新于 2026-11-05)
- K2:MoE,总参数约 1T,每个 token 激活约 32B。
K3:MoE,总参数约 2.8T,激活约 104B,原生 MXFP4 权重约 1.56TB,支持 100 万 token 上下文和图像输入。
官方推荐推理引擎:vLLM、SGLang、TokenSpeed,面向多卡服务器。
个人电脑基本跑不动原版;想体验,先用官方 API 或更小的开源模型。
许可证允许商用和微调,但大型 MaaS 业务与超大规模产品有附加条件。
kimi 本地部署前先看清模型规模
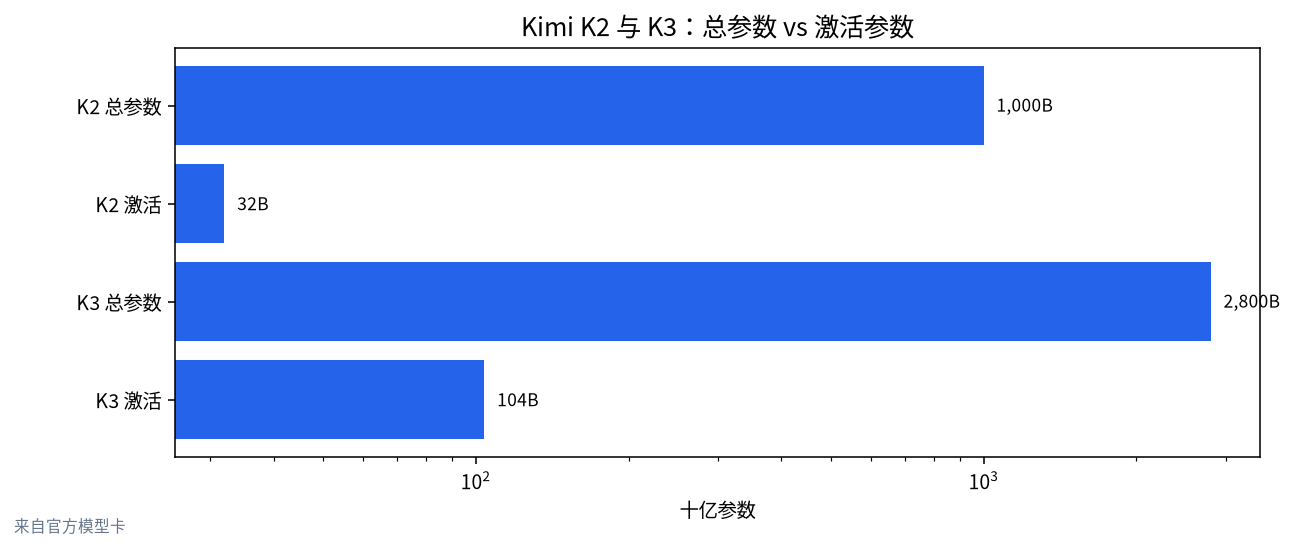
MoE(混合专家)模型的特点是“总参数很大,每次只激活一部分”。激活参数决定了每个 token 的计算量,所以推理速度相对同体量的稠密模型更快;但所有专家的权重仍然要放在显存或内存里,因此存储和内存需求由总参数决定。这就是为什么 Kimi 的计算量看起来像一个百亿级模型,部署门槛却是万亿级。关于 MoE 的显存账,可以参考我们的 MoE 模型本地运行。
| 项目 | Kimi K2 | Kimi K3 |
|---|---|---|
| 架构 | MoE | MoE(KDA + Gated MLA 注意力) |
| 总参数 | 约 1T | 约 2.8T |
| 激活参数 | 约 32B | 约 104B |
| 专家数 / 每 token 选择 | 官方卡为准 | 896 个专家,选 16 个 |
| 上下文 | 以具体版本模型卡为准 | 1,048,576 tokens |
| 模态 | 文本 | 文本 + 图像(视觉编码器约 4 亿参数) |
| 官方权重精度 | 以版本为准(含 FP8、INT4 版本) | MXFP4 权重 / MXFP8 激活(量化感知训练) |
| 官方下载体积 | 约 1TB 量级(版本不同差异大) | 约 1.56TB,96 个分片 |
kimi k3本地部署要求与配置
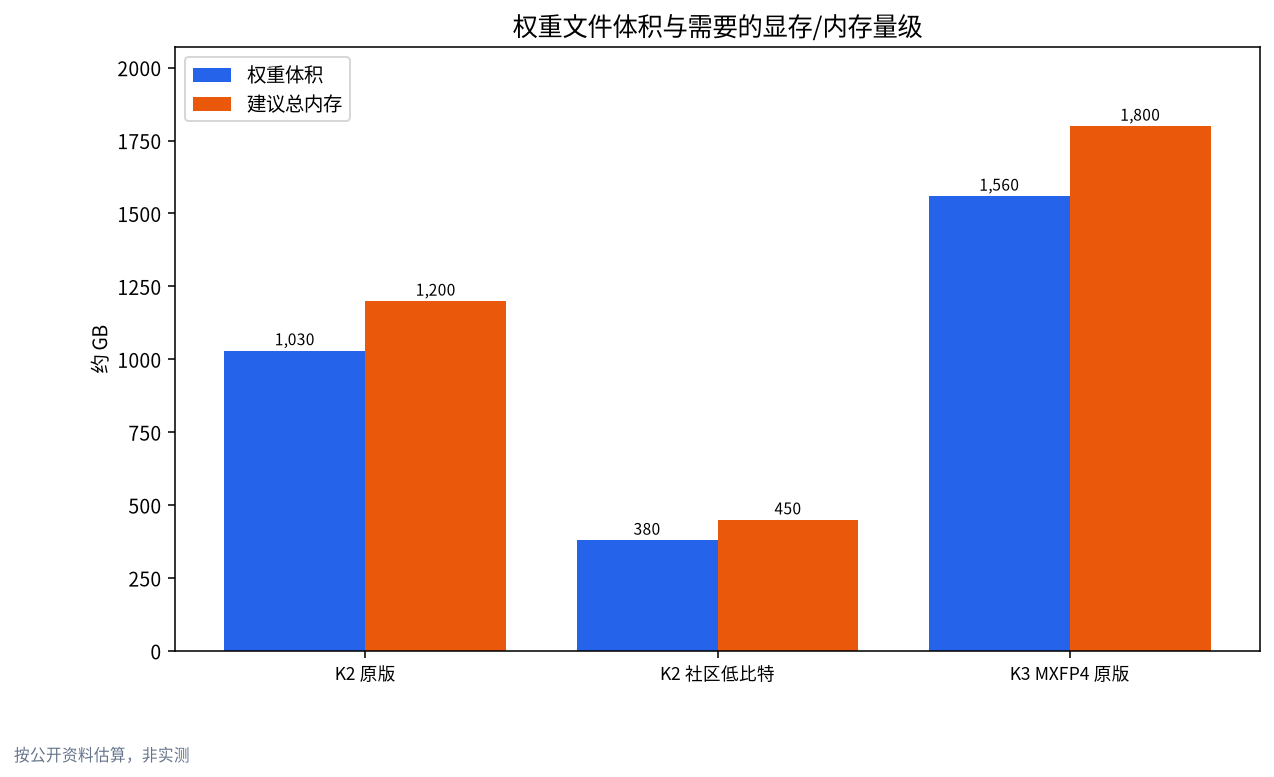
kimi k3本地部署要求的核心是“能装下约 1.56TB 的权重,再加上 KV 缓存和运行开销”。按经验,总显存最好比权重体积多出 15%–30%。由此推出几个量级:
| 部署形态 | 大致配置 | 能否跑 K3 原版 | 备注 |
|---|---|---|---|
| 单卡消费级(RTX 4090/5090) | 24–32GB 显存 | 不能 | 连分片都放不下 |
| 工作站 + 512GB 内存 | 单卡或双卡 + 大内存 | 不能装下 K3 | 社区极低比特 K2 也很勉强 |
| 单节点 8×H200(约 1.1TB 显存) | 数据中心 GPU | 原版装不下 | K2 FP8 量级可以考虑 |
| 单节点 8×B200 / B300 级 | 1.5–2.3TB 显存 | 视显存与上下文而定 | MXFP4 在 Blackwell 上有原生支持 |
| 双节点 16×H200 | 约 2.2TB 显存 | 可以 | 需要高速互联与张量/专家并行 |
所以,kimi k3本地部署配置要求落到现实里,就是一台或两台数据中心级 GPU 服务器。普通开发者能做的,是在大内存服务器上尝试社区做的低比特 K2 量化版本,用 llama.cpp 一类工具把大部分专家放在内存里、少量层放在 GPU 上——能跑,但速度通常只有每秒个位数 token,更适合研究而不是生产。内存与显存怎么分工,可以看 内存 vs 显存与 CPU 卸载。
还要提醒存储:1.56TB 权重至少需要 2TB 以上的 NVMe 空间,下载和加载都很耗时。国内下载可以走魔搭或镜像,方法见 Hugging Face 国内镜像下载指南,硬盘选择见 大模型硬盘容量。
kimi 本地部署步骤(服务器路线)
下面是多卡服务器上的通用流程,具体参数以官方 vLLM/SGLang 配方为准:
- 确认驱动与 CUDA 版本满足推理引擎要求,NVLink/InfiniBand 正常,
nvidia-smi topo -m检查拓扑。 - 准备存储:建议本地 NVMe RAID,避免从网络存储冷加载 TB 级权重。
- 下载权重:
hf download moonshotai/Kimi-K3 --local-dir /data/kimi-k3,国内可设置镜像或改用 ModelScope;下载后核对分片数量与哈希。 - 安装推理引擎:按官方 recipe 安装对应版本的 vLLM 或 SGLang,不要随意混用版本。
- 启动服务:开启张量并行或专家并行,设置合适的最大上下文长度。上下文开到 100 万 token 会显著增加 KV 缓存占用,大多数场景先设 32K–128K。
- 对外提供 OpenAI 兼容接口,再接入 Dify、Open WebUI 或你自己的应用。
- 压测与监控:记录首 token 延迟、吞吐与显存峰值,再决定并发上限。
如果你只需要 Kimi 的能力,而不是“权重必须在自己机房”,官方 API 和认证推理合作伙伴是成本更低的选择。数据出域的合规问题,请参考 企业私有化部署。
kimi k3本地部署成本估算
成本分为一次性硬件和持续运营两部分。下面是团队按 2026 年下半年公开行情做的粗略区间,仅供量级判断:
| 方案 | 一次性投入(区间) | 月运营 | 适合 |
|---|---|---|---|
| 租用云 GPU 节点(按小时) | 无 | 按使用时长,单节点每小时数百元到上千元量级 | 评测、短期项目 |
| 采购 8 卡数据中心服务器 | 数百万元人民币量级 | 电费、机柜、运维人员 | 长期高并发、强合规 |
| 大内存 CPU 服务器跑低比特 K2 | 数万到十几万元 | 电费较低 | 研究、离线批处理 |
| 官方 API | 无 | 按 token 计费 | 绝大多数个人和中小团队 |
买还是租,可以参考我们的 租 GPU 还是买 GPU。一个简单的判断是:如果你的 GPU 利用率长期达不到 50% 以上,自建 K3 级集群几乎一定比 API 贵。
部署后常见的坑
真正把 Kimi 跑起来之后,问题往往出在下面几处,而不是“能不能启动”:
- 冷启动太慢:TB 级权重从机械盘或网络存储加载可能要几十分钟。建议放本地 NVMe,并保持服务常驻,不要频繁重启。
- 上下文开太大:100 万 token 的 KV 缓存会吃掉大量显存,导致并发骤降甚至直接爆显存。先按业务需要设定上限,长文档用检索切片代替整篇塞入。
- 版本混用:推理引擎、驱动、权重修订版本之间强相关。官方配方写了哪个版本就用哪个版本,升级前在测试环境先跑一遍。
- 功耗与散热:8 卡服务器满载功耗可达十千瓦量级,普通办公室的电路和空调都扛不住,必须进机房。我们在 算力机的电源与散热 里讲过基本原则。
- 缺少监控:没有显存、温度和延迟监控,就很难判断是模型慢还是排队慢。上线前接入监控并设置告警。
许可证要点
Kimi K3 的代码和权重都采用 “Kimi K3 License”。它允许使用、修改、微调、分发和商用,同时有几条附加条件:以 MaaS(模型即服务)形式提供给第三方、且年营收超过 2000 万美元的企业,需要先与月之暗面另签协议;月活过亿或月营收超过 2000 万美元的商业产品,需要在界面显著标注 “Kimi K3”;纯内部使用不受这两条限制。请以 官方 LICENSE 原文 为准,重大商业项目建议请法务审阅。月之暗面自己的材料用的是“开放权重”而不是“开源”,这个区别我们在 开源大模型是什么 里解释过。
个人用户的现实替代方案
如果你只有一张 24GB 显卡或一台 64GB 内存的电脑,与其折腾 Kimi 原版,不如:
- 用 Kimi 官方 App 或 API 体验它的长上下文与代码能力;
- 本地跑 Qwen、DeepSeek 蒸馏版、GLM 等 7B–32B 模型,参考 RTX 4090 能跑多大模型 和 模型大小选择器;
- 用 显存计算器 先算清楚,再决定是否为更大的模型升级硬件。
网上自称“Kimi K3 精简版”“Kimi 本地一键包”的东西要格外警惕,官方只在 moonshotai 组织下发布权重,其他来源请先核对哈希。
常见问题(FAQ)
Kimi 可以在个人电脑上本地部署吗?
原版基本不行。K2 和 K3 的权重都是 TB 级,个人电脑的显存和内存都放不下。社区的极低比特 K2 量化版本可以在超大内存服务器上勉强运行,但速度慢、质量有损失。
kimi k3本地部署要求最低是多少?
至少要有能容纳约 1.56TB 权重再加 KV 缓存的总显存,通常意味着 8 卡 Blackwell 级服务器或两台 8×H200 服务器,以官方推荐配方为准。
Kimi K3 是开源的吗?
它是开放权重模型,权重和代码在 Kimi K3 License 下发布,允许商用和微调,但有针对大型 MaaS 业务和超大规模产品的附加条件,不等同于 OSI 定义的开源。
kimi k3本地部署成本大概多少?
自购硬件在数百万元人民币量级,租用云 GPU 按小时计费。对大多数团队,官方 API 的总成本远低于自建。
K2 和 K3 选哪个?
K3 能力更强、支持图像和 100 万上下文,但部署门槛约为 K2 的 1.5 倍以上。硬件有限时,K2 的低比特版本或官方 API 更现实。
Kimi 本地部署需要“破甲”吗?
不需要,也不建议。本站不提供绕过安全机制的方法;企业场景应该加装护栏,参考我们的 本地护栏模型。
想评估你的 Kimi 部署方案?
欢迎到社区分享你的硬件清单,或发邮件到 admin@microaione.com。深圳团队可以帮你估算显存、并行方式和成本。
参考资料:Kimi K3 模型卡、Kimi K3 GitHub、Kimi K3 License、vLLM 文档、本站 vLLM 与 SGLang 入门。