Gemma 本地部署教程:用 Ollama 运行 Gemma 4 与 Gemma 3,按显存选版本
Gemma 是 Google DeepMind 发布的开放权重模型家族,体积从几百兆到三十亿参数级都有,非常适合在个人电脑上运行。这篇 Gemma 本地部署 教程基于 Ollama 官方模型库的页面,讲清楚当前的 Gemma 4 与上一代 Gemma 3 各有哪些版本、体积和上下文长度,怎么按自己的显存挑版本,怎么运行并验证,以及思考模式、采样参数和常见问题。Ollama 本身的安装见《Ollama 安装教程》,量化的概念见《Q4_K_M 量化是什么》。
核对说明:版本、体积、上下文长度、命令和推荐采样参数来自 Ollama 官方模型库的 gemma4 与 gemma3 页面(ollama.com/library,2026-10-30 读取)。模型库的体积会随版本更新,且同一标签在不同量化下有区间,下载前请以页面为准。我们没有对 Gemma 做自己的速度或质量评测,不引用厂商公布的评测分数。
要点速览(更新于 2026-10-30)
- Gemma 4 在 Ollama 上有 e2b、e4b、12b、26b(混合专家,约 4B 激活参数)和 31b(稠密)五档,小模型上下文 128K,大模型 256K。
12GB 显存先试 gemma4:12b(约 7.7–8.0GB),24GB 显存可以考虑 26b 或 31b(约 16–20GB)。
Gemma 4 支持思考模式,系统提示开头加入
<|think|>即可启用;官方建议采样参数为 temperature 1.0、top_p 0.95、top_k 64。
Gemma 本地部署:先认识版本
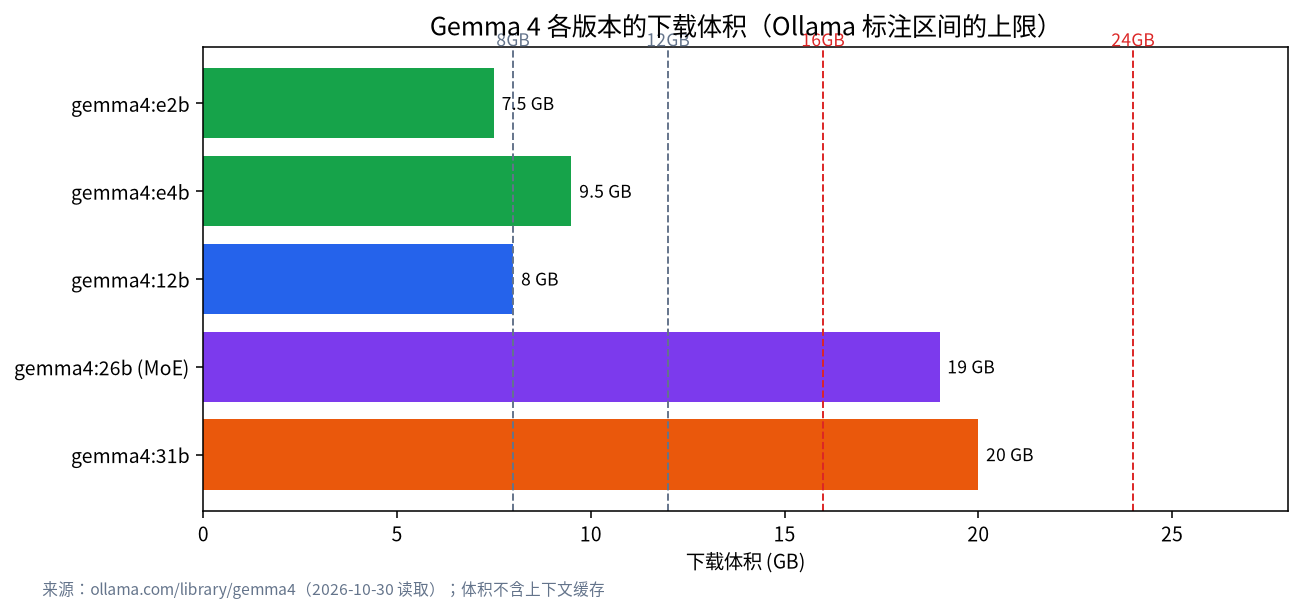
按 Ollama 模型库,Gemma 4 的各个标签如下。下载体积是一个区间,取决于量化版本;”e” 代表 effective(有效参数),面向端侧和小设备。
| 标签 | 下载体积(Ollama 标注) | 上下文 | 输入类型 | 说明 |
|---|---|---|---|---|
| gemma4:e2b | 4.6GB–7.5GB | 128K | 文本、图像(模型卡含音频) | 有效参数约 2.3B,端侧设备 |
| gemma4:e4b(latest) | 6.6GB–9.5GB | 128K | 文本、图像(模型卡含音频) | 有效参数约 4.5B,gemma4:latest 指向它 |
| gemma4:12b | 7.7GB–8.0GB | 256K | 文本、图像 | 工作站档位 |
| gemma4:26b | 16GB–19GB | 256K | 文本、图像 | 混合专家,总参数约 25.2B,激活约 3.8B |
| gemma4:31b | 19GB–20GB | 256K | 文本、图像 | 稠密,约 30.7B 参数 |
上一代 Gemma 3 仍然可用,适合显存很小或者需要旧版兼容的场景:
| 标签 | 下载体积 | 上下文 | 输入类型 |
|---|---|---|---|
| gemma3:270m | 292MB | 32K | 文本 |
| gemma3:1b | 806MB | 32K | 文本 |
| gemma3:4b(latest) | 3.4GB | 128K | 文本、图像 |
| gemma3:12b | 8.2GB | 128K | 文本、图像 |
| gemma3:27b | 17GB | 128K | 文本、图像 |
注意 Gemma 4 的 26b 是混合专家(MoE)模型:总参数约 25.2B,但每个 token 只激活约 3.8B,所以体积按总参数算,速度比同体积的稠密模型更快。这一点在后面讲 MoE 的文章里会详细说明。
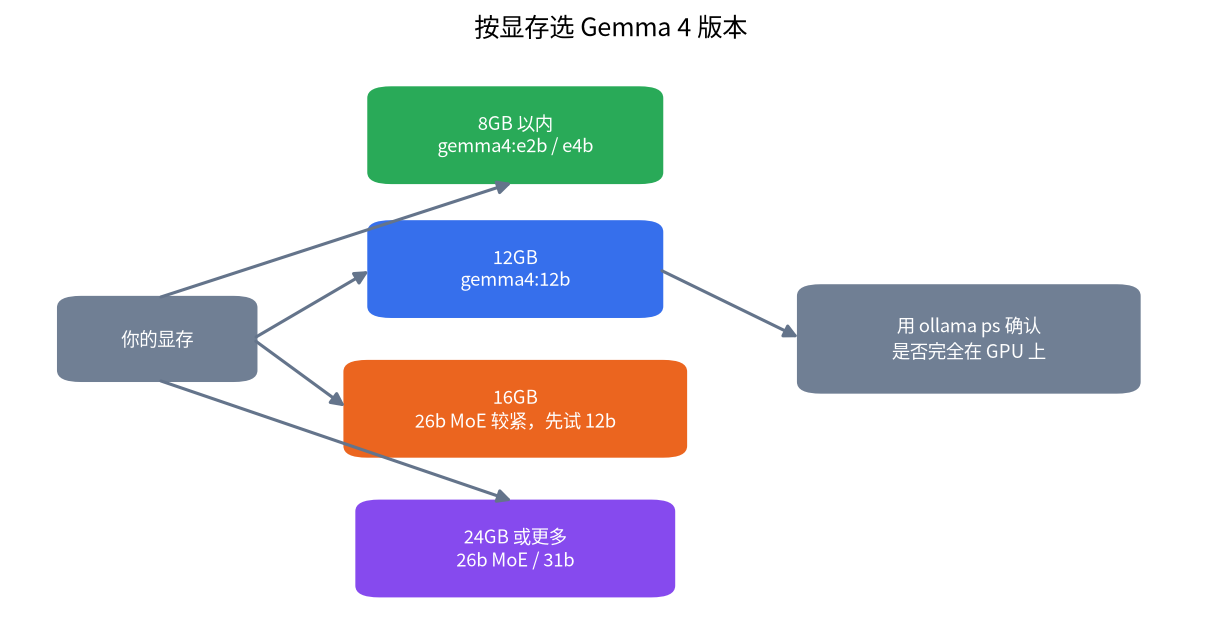
按显存选版本
下载体积只是权重,还要给上下文缓存留出余量。一个简单的规则是:权重体积加上 2GB 到 4GB 的余量,不要超过显存。
| 显存 | 建议版本 | 说明 |
|---|---|---|
| 8GB 以内 | gemma4:e2b 或 e4b,或 gemma3:4b | 参考《8GB 显存能跑什么大模型》 |
| 12GB | gemma4:12b | 体积约 8GB,余量够用于中等上下文 |
| 16GB | 先试 gemma4:12b,再评估 26b | 26b 的 16GB–19GB 体积在 16GB 显存上很紧,参考《12GB 与 16GB 显存跑大模型》 |
| 24GB 及以上 | gemma4:26b 或 31b | 参考《24GB 显存跑大模型》 |
运行与验证
- 更新 Ollama:新版本的模型需要较新的 Ollama,先升级到最新版本。
- 运行:在终端输入
ollama run gemma4:12b,第一次会自动下载。只想下载不运行可以用ollama pull gemma4:12b。 - 用 API 调用:Ollama 模型页给出了
curl http://localhost:11434/api/chat的示例,把 model 改成gemma4即可。 - 验证:另开终端运行
ollama ps,PROCESSOR 一列应显示 100% GPU。如果显示 CPU 占比,说明显存不够或驱动有问题,见《Ollama 不使用 GPU 怎么办》。 - 图像输入:Gemma 4 与 Gemma 3 的 4b 及以上版本支持图像。官方建议在提示里先放图像,再放文字。
思考模式与推荐参数
Gemma 4 的模型页给出了几条使用建议,我们整理如下:
- 采样参数:官方建议所有场景统一使用 temperature=1.0、top_p=0.95、top_k=64。
- 启用思考:在系统提示开头加入
<|think|>令牌即可启用思考;去掉它就关闭思考。 - 多轮对话:历史记录里只保留模型的最终回答,不要把之前轮次的思考内容放回去。
- 系统角色:与 Gemma 3 不同,Gemma 4 原生支持 system 角色。
- 图像预算:Gemma 4 支持可配置的视觉令牌预算,预算越高,细节越多,但算力开销也越大。
这些建议来自 Ollama 页面转载的官方模型卡,Ollama 已经替你处理了聊天模板,所以通常不需要自己拼接令牌格式。
报错与速度排查表
| 现象 | 可能原因 | 处理 |
|---|---|---|
| 下载很慢 | 网络环境 | 参考《Ollama 下载慢怎么办》,换网络或设置代理 |
| 速度很慢 | 部分层落到了 CPU | 换小一档的版本,或缩短上下文 |
| 提示找不到模型 | 标签写错或 Ollama 太旧 | 核对标签,升级 Ollama |
| 回答里出现思考标记 | 思考模式的输出格式 | 在客户端里使用支持思考字段的界面,或关闭思考 |
| 显存不够 | 权重加缓存超过显存 | 换小一档,或缩短上下文 |
权重体积之外:上下文缓存怎么估
Gemma 4 的 12b、26b 和 31b 支持 256K 的上下文,但这只是模型能力的上限,不代表你的显存撑得住。上下文缓存会随着对话长度线性增长,长度越大,占用越多。因此,如果你用 12GB 显存运行 12b 版本,权重约占 8GB,剩下的四五 GB 要同时容纳缓存、显示输出和系统占用,实际能用的上下文会远小于 256K。一个稳妥的做法是先把上下文设在 8K 左右,确认速度和显存都正常,再逐步增加,直到 ollama ps 开始显示部分层落到 CPU,就退回上一档。
Open WebUI 的文档提到,Ollama 在显存低于 24GiB 时默认上下文为 4096,需要时可以调大;调大之前请先确认显存余量。这个思路对所有模型都适用,具体的估算方法见《大模型显存需求怎么算》。
最小验证清单
- 运行
ollama --version,确认已经升级到较新的版本。 - 用
ollama pull下载你选定的标签,核对页面上的体积与实际下载量大致相符。 - 用一个 200 字左右的提示做第一次测试,确认回答正常。
- 运行
ollama ps,确认 PROCESSOR 为 100% GPU。 - 用一张图片加一句提问,确认多模态可用。
- 最后再试一个较长的文档,观察显存和速度是否仍然可以接受。
小模型适合做什么
e2b 和 e4b 这两个端侧版本很适合做轻量任务,比如文本分类、简单的改写、提取要点,或者在没有独立显卡的笔记本上做离线问答。它们的优势是启动快、占用小,劣势是处理复杂推理和长文档时不如大版本。如果你的机器只有 8GB 显存,不要因为追求大参数而勉强上 12b,把 e4b 跑稳、上下文设够,往往比一个勉强装下却频繁换页的大模型更好用。同样的道理也适用于手机和树莓派这类设备,后续的端侧文章会专门讨论。
Gemma 与其他模型怎么选
如果你的任务以多语言、图像理解为主,Gemma 是值得试的一个;如果你更看重代码或中文表现,也可以对照《Qwen 本地部署教程》里的选择。我们的建议是用自己的任务做对比:准备十个真实问题,把 Gemma 和另一个同体积的模型各跑一遍,选回答更符合你需求的那个。更多模型的横向选择见《2026 本地大模型推荐》。
如何做一次公平的对比测试
选模型最可靠的办法,是用你自己的任务做对比。准备十个有代表性的真实问题,覆盖你最常见的用途,例如总结一段文字、改写一封邮件、解释一段报错、回答一个专业问题。每个模型都用同样的提示和同样的采样参数,把回答存成文件,隔几天再回头看,选出最符合自己需要的那个。这样做比看任何排行榜都更贴近你的实际体验,也不用担心被厂商公布的分数误导。
别忘了记录测试时使用的版本号和标签,因为模型库会更新,同一个标签在几周后可能指向不同的量化文件。
部署后的使用习惯
部署成功后,有几个习惯能让体验更稳定。第一,给不同用途建立不同的模型别名:日常聊天用小一些的版本,长文档或复杂推理再切到大版本,这样可以减少等待。第二,上下文并不是越长越好:256K 是模型的能力上限,实际使用时显存会随上下文增长而增加,日常对话把上下文限制在够用的范围即可。第三,定期用 ollama list 清理不用的模型,避免磁盘被占满。第四,如果要把服务提供给别的设备或应用,可以参考《LM Studio 教程》或 Open WebUI 方案,搭配一个更友好的界面。
常见问题
Gemma 4 和 Gemma 3 该选哪个?
优先试 Gemma 4,它在 Ollama 上有更多档位和更长的上下文;如果显存很小或需要旧版兼容,Gemma 3 的 4b、1b 仍然适用。
Gemma 4 的 26b 为什么体积这么大?
它是混合专家模型,总参数约 25.2B,权重体积按总参数计算,但每个 token 只激活约 3.8B 参数。
12GB 显存该用哪个 Gemma?
建议先用 gemma4:12b,体积约 8GB,给上下文留有余量。
Gemma 能看图吗?
能。Gemma 4 全系列支持图像输入,Gemma 3 的 4b、12b、27b 也支持。
怎么开启 Gemma 4 的思考模式?
在系统提示开头加入 <|think|>,去掉即关闭。
能用 LM Studio 或 llama.cpp 运行 Gemma 吗?
可以,原理是一样的,只是需要选对 GGUF 文件和量化版本,见《GGUF 与 llama.cpp 入门》。
需要帮你选版本
如果你不确定自己的显卡该用哪个 Gemma 版本,欢迎到社区告诉我们显卡型号和用途,也可以发邮件到 admin@microaione.com。入门路线见《显存与本地大模型:怎么选 GPU》。
参考与延伸阅读:Ollama:gemma4 模型页、Ollama:gemma3 模型页。