GSQ-RCO DeepSeek V4.1 Flash 1017 魔改版核查:拒答清零、KL 0.02、12GB 显存,哪些站得住
社区里转发了一条消息,说 GSQ-RCO DeepSeek V4.1 Flash 1017 的“魔改版”用“abliteration 2.0 残差投影”把多维拒答率从 85% 以上压到 0%,KL 仅 0.02,“12GB 显存 + 64GB 内存即可本地跑满 763B 大模型”,还附了 Hugging Face 的仓库地址。这条消息里有真东西,也有被压缩、被换了说法的地方。我们这次逐条对照了仓库的模型卡、随附的 rungs.json 和公开的指标数据集,再核对了运行时 Strata 的 GitHub 文档,结论放在下面。我们没有下载这些文件,也没有在自己的机器上跑过,所有数字都来自这些公开页面的自报,已注明口径。若你想先了解同类做法的原理,可以看拒绝方向消融(Abliteration)原理详解;上一轮的 OBLITERATUS 版在这篇分析里。
要点速览(更新于 2026-11-01)
- 仓库真实存在(AtomicChat,MIT 许可,3 档 GGUF,合计约 414 GB),但“GSQ-RCO”是奥地利 ISTA-DASLab 的量化方法,不是去审查方法;AtomicChat 是在 ISTA 的量化文件上做了一次“单方向拒绝编辑”,强度 2.0。“abliteration 2.0”是转发里的措辞错误。
拒答清零基本属实但口径很窄:英文 JailbreakBench 只有 81 题,从 85.2–88.9% 降到 0.0%;思考阶段 30 题里仍有 0–2 题拒答,并出现 0–3 次思考循环。
KL 0.02(0.0207–0.0272)是编辑版相对未编辑的量化档的偏移,不是相对原版模型,而且是 top-64 下界。
“12GB + 64GB 跑 763B”能运行,但厂商自测约 4–6 token/s,且是 2 位量化;“跑满”不准确。详细推算见12GB 显存跑 DeepSeek V4.1 Flash 的 SSD 流式加载实测与推算。
它回答原版会拒绝的请求,风险和合规义务在使用者身上;MIT 许可不等于合规。
先说结论:转发里的六条说法
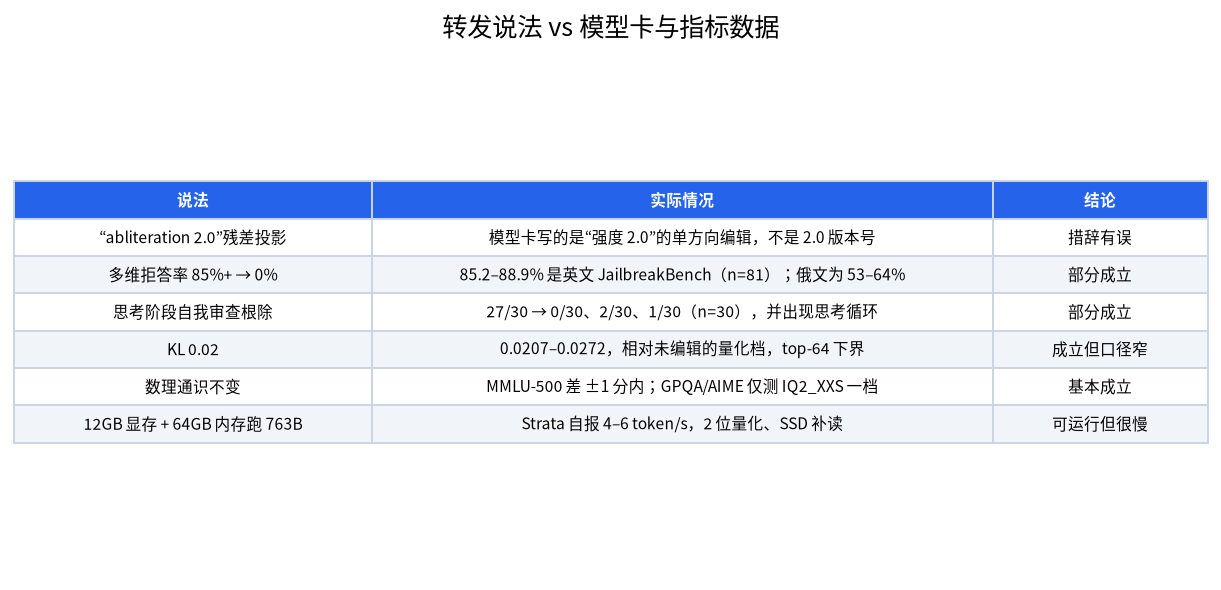
| 转发里的说法 | 模型卡与数据实际显示 | 我们的判断 |
|---|---|---|
| GSQ-RCO 魔改,“abliteration 2.0” | GSQ-RCO 是 ISTA-DASLab 的量化方法;编辑是“单方向拒绝编辑,强度 2.0” | 说法混淆了两件事,“2.0”是强度不是版本 |
| 多维拒答率 85%+ → 0% | 英文 JailbreakBench(n=81)85.2/86.4/88.9% → 0.0%;俄文 53–64% → 0.0% | 部分成立,“多维”言过其实 |
| 根除思考阶段自我审查 | 思考高强度 30 题:27 → 0、2、1 题 | 部分成立,并非每档为零 |
| KL 0.02,数理与通识不变 | KL 0.0207–0.0272,对象是未编辑量化档;MMLU-500 差在 ±1 分内 | 数字真实,口径窄 |
| 12GB + 64GB 本地跑 763B,三档量化 | Strata 自报 RTX 5070 12GB + 64GB 约 4–6 token/s;三档 1.75–2.25 bpw | 能跑,很慢,是极低比特 |
| 只改残差张量,MoE 专家完整,MIT 可商用 | 卡中称路由专家逐字节不变;MIT 许可 | 许可属实,但“仅限科研”是建议,不是条款 |
GSQ-RCO DeepSeek V4.1 Flash 到底是什么:三层来源
理清楚来源,就能看出转发为什么容易误读。第一层是 DeepSeek-V4.1-Flash-1017 本体:MoE 结构,每层 384 个路由专家、每词激活 6 个,另有一份 Engram(n-gram 条件记忆)查找表,ISTA 卡片称其总参数为 763.2B。第二层是 ISTA-DASLab(奥地利科学技术研究所)的 GSQ-RCO 量化:GSQ 负责在给定类型下做精确的标量量化,RCO 负责在大小预算内为每个张量分配量化类型,产出 IQ1_M(1.75 bpw)、IQ2_XXS(2.00)、IQ2_XS(2.25)三档 GGUF。这个仓库发布于 2026-10-23,下载量已超过 229 万。第三层才是 AtomicChat 的仓库:创建于 2026-10-28,最近更新 2026-10-31,我们读到时有 17,384 次下载、121 个赞,许可证写 MIT,卡片把 ISTA 的仓库列为 base model,关系为 quantized。
所以更准确的说法是:这是对 ISTA 的 GSQ-RCO 量化文件做了拒绝方向编辑后重新发布的版本。Engram 表(约 110.6 GB)AtomicChat 没有重新托管,要从 ISTA 仓库另取。三档文件合计约 414 GB(IQ1_M 约 120.7 GB、IQ2_XXS 约 138 GB、IQ2_XS 约 155 GB,均不含 Engram),下载一档加 Engram 的总量约 231–266 GB。
这份编辑到底改了什么
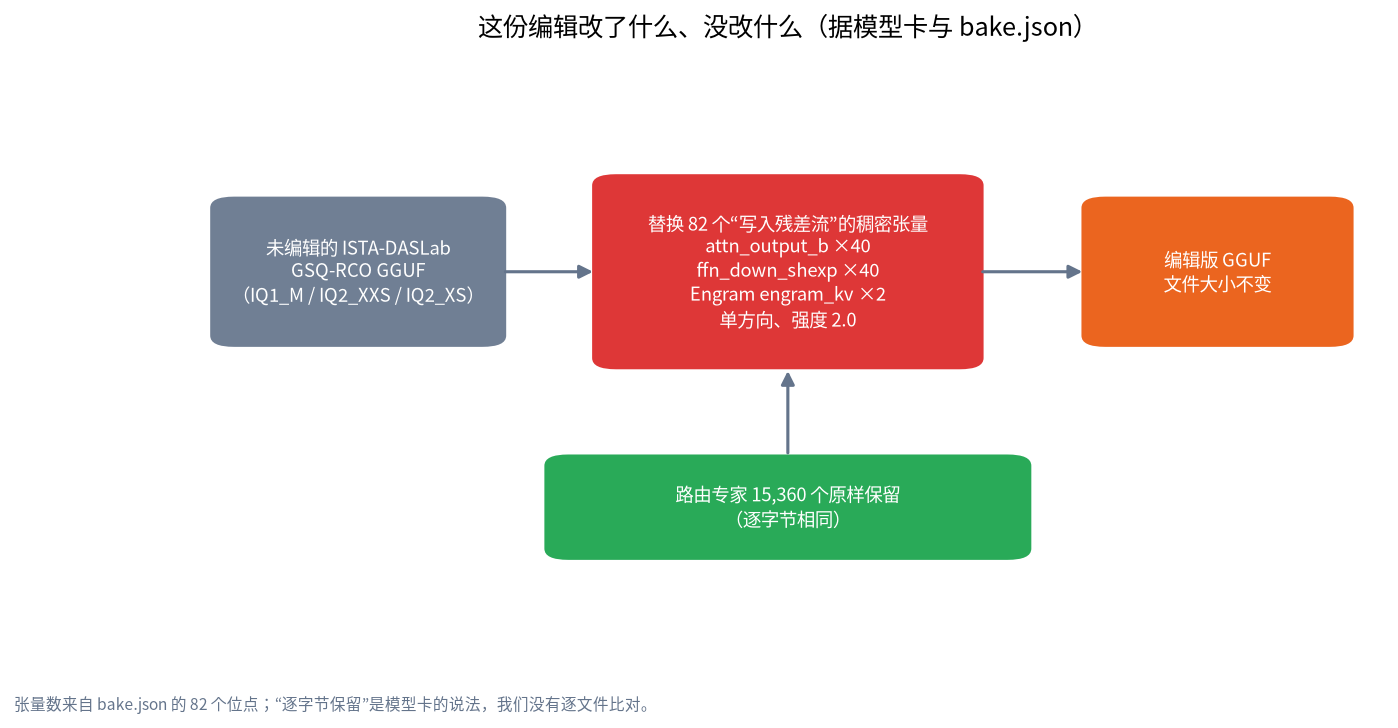
据模型卡和指标数据集里的 bake.json,编辑发生在 82 个“位点”:40 层的 attn_output_b、40 层的 ffn_down_shexp(共享专家的下投影),外加 Engram 的 2 个张量(bake.json 里叫 engram_kv,卡片称值投影)。这些都是“把结果写回残差流”的稠密张量,沿一个拒绝方向做投影,再量化回 ISTA 原有的类型,所以文件大小不变。卡片明确说 15,360 个路由专家保持 ISTA 发布时的样子,逐字节相同。我们没有逐文件比对,这一点属于卡片自述。bake.json 还逐张量记录了一个 projection_after 数值,都在 0.9998 左右(预期值 1.0);我们没有核对它的精确定义,只当作编辑已按设计完成的自报佐证。需要强调的是,“MoE 专家完整”只对路由专家成立,共享专家的下投影是被改了的。
“强度 2.0”是编辑幅度参数,卡片没有展开它的数学含义。转发把它写成“abliteration 2.0”,听上去像一个新版本的方法,这是误读。方法本身仍是单方向的拒绝方向消融,原理见我们的原理详解。卡片自己也列了限制:它在各个话题上一起移除拒绝,没法只保留一部分;拒答分类器只读回答的开头,所以后面才出现的“软拒绝”可能漏判。
拒答清零的数字怎么读
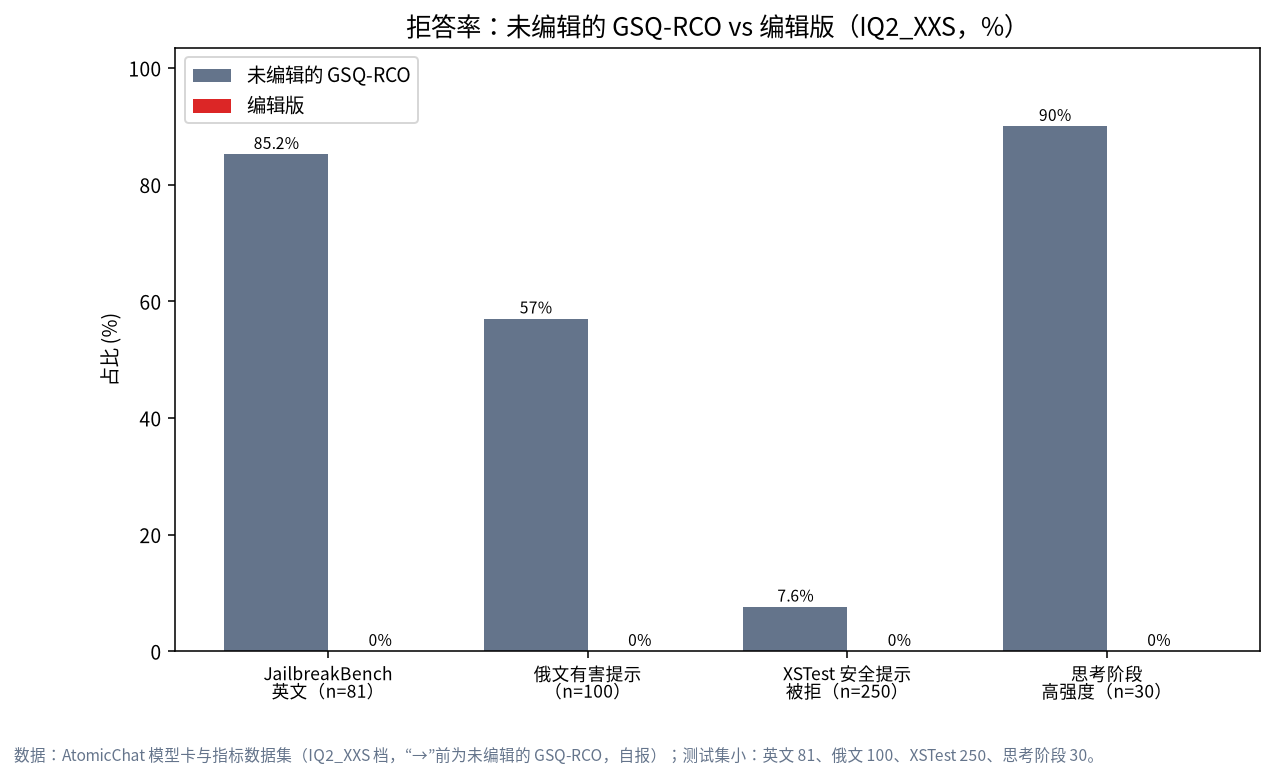
| 档位 | bpw | 总大小 | 英文 JailbreakBench | XSTest 安全提示被拒 | 思考高强度拒答(30 题) | MMLU-500(未编辑 → 编辑) | KL(对未编辑档) |
|---|---|---|---|---|---|---|---|
| IQ2_XXS | 2.00 | 约 249 GB | 85.2% → 0.0% | 7.6% → 0.0% | 27 → 0(3 次思考循环) | 83.8% → 82.8%(p=0.27) | 0.0225 |
| IQ2_XS | 2.25 | 约 266 GB | 86.4% → 0.0% | 4.0% → 0.4% | 27 → 2(2 次循环) | 81.4% → 81.6%(p=1.00) | 0.0272 |
| IQ1_M | 1.75 | 约 231 GB | 88.9% → 0.0% | 4.8% → 0.0% | 27 → 1(0 次循环) | 80.2% → 80.6%(p=0.75) | 0.0207 |
读这张表要注意几件事。第一,测试集很小:英文有害提示 81 条,俄文 100 条,XSTest 250 条,思考阶段只有 30 条,MMLU 抽了 500 题。第二,“0.0%”来自分类器对回答开头的判断;指标数据集里,关闭思考的 256 个 token 限制下,英文 81 条里有 72 条回答在限制处被截断,所以判定主要依据开头。第三,“85%+”只对英文成立;俄文未编辑时是 53–64%。第四,指标文件 rungs.json 把 IQ2_XS 标为 pass: false,卡片也承认“并非每档都通过每个门槛,按实测发布”,但没有说是哪一个门槛。第五,XSTest 里“被拒的安全提示”从 4–8% 降到约 0,这是过度拒答变少,对想研究过度拒答的人是有价值的结果。
关于“思考阶段自我审查被根除”:IQ2_XXS 为 0/30,IQ2_XS 为 2/30,IQ1_M 为 1/30。卡片还提醒,开启思考后,编辑版会为原版会拒绝的请求制定回答计划,计划可能很长,建议加大 token 预算或降低推理强度。这一条我们判断为“大幅下降”,不是“根除”。
KL 0.02 与“能力不变”:口径问题
| 比较对象 | 数值 | 来源与口径 |
|---|---|---|
| 编辑版 vs 未编辑的 GSQ-RCO 量化档 | KL 0.0207–0.0272 | AtomicChat 卡片;Strata 的 teacher-forced 评分,top-64 下界,真实值略高 |
| 未编辑 GSQ-RCO(2.00 bpw)vs 原版模型 | KL 0.170,困惑度 +15.5% | Strata 文档自报 |
| OBLITERATUS 版 vs 原版 BF16 | KL 0.1305 nats | OBLITERATUS 卡片,序列 token 前向 KL |
这就是“KL 0.02”最容易被误读的地方:它衡量的是编辑本身造成的偏移,基准是已经压到 2 位的量化档。量化本身距离原版就有不小的差距(Strata 给 2.00 bpw 档的 KL 为 0.170)。三个 KL 的基准和算法都不同,不能直接比大小,更不能说“0.02 比 0.1305 好 6 倍”。
“数理、通识不变”的证据是:MMLU-500 编辑后差距都在 1 分内且 p 值不显著;仅在 IQ2_XXS 一档,GPQA-Diamond(198 题)为 83.3% 对 83.3%,AIME25(30 题)为 76.7% → 80.0%,卡片称在 n=30 的噪声内。这些比较的都是“编辑版 vs 未编辑量化档”。另一个值得知道的细节:ISTA 自己的卡片写 IQ2_XXS 档在 AIME25 达到 100.00、GPQA-Diamond 90.91,而 AtomicChat 在 Strata 上测同一个未编辑档只得到 76.7% 和 83.3%。两边的测评框架、采样与题数不同,我们没有核实差距来自哪里;此外 Unsloth 的指南称未能复现 GSQ-RCO 的 100% AIME25。因此最稳妥的读法是:编辑本身没有明显破坏能力,但极低比特量化相对原版的损失,转发里一个字都没提。
与 OBLITERATUS 版(A73–A75)的对比
| 维度 | AtomicChat GSQ-RCO 编辑版 | OBLITERATUS 版 |
|---|---|---|
| 形态 | 3 档 GGUF,231–266 GB(含 Engram) | BF16 权重,约 1,509 GB,83 个分片 |
| 起点 | ISTA-DASLab 的 GSQ-RCO 量化档 | DeepSeek-V4.1-Flash-1017 原版 |
| 方法 | 单方向编辑,强度 2.0,改 82 个残差写入张量 | Failspy 预设,1 个 diff_means 方向,除第一层外所有层,不做范数保持,路由器不投影 |
| 报告的拒答 | 英文 81 题 85–89% → 0%,XSTest 4–8% → 约 0 | 838 条提示:完全拒答 81.62% → 4.30% |
| 危害度评估 | 卡片未做 | 3+4 级约 54.06%(原版约 3.94%),LLM 评审标注 |
| KL | 0.02,对量化档,top-64 下界 | 0.1305 nats,对原版 BF16 |
| MMLU | 500 题,差在 ±1 分内 | 2,500 题,87.96% vs 88.08%(p=0.743) |
| 运行方式 | Strata;llama.cpp 见下文 | 卡片没有使用说明 |
| 许可证 | MIT | MIT |
两份报告的测试集、分类器和 KL 基准都不同,所以不能说谁“更干净”。唯一可以直接说的是:OBLITERATUS 的卡片给了危害度分布,显示拒答减少的同时有害回答比例大幅上升;AtomicChat 的卡片没有给这类数据。我们在上一篇分析里对那份数据做过同样的限定。两者在运行门槛上的差别,见OBLITERATUS 版本地部署指南与本批的低显存部署篇。
763B 与 754.6B:两个数字都对,口径不同
转发写的是 763B,这是 DeepSeek 原版的参数规模(ISTA 卡片写 763.2B,其中骨干 551.9B、Engram 196.6B,合计约 748.5B,剩余部分卡片没有逐项拆分)。我们上一批读到的 OBLITERATUS 卡片写 754.6B。我们没有办法从公开信息里对齐这两个数,可能是统计口径(是否含 MTP 层、视觉部分等)不同,在这里只能如实并列,不做推断。
运行与许可:Strata、llama.cpp 与 MIT
AtomicChat 卡片称这些文件用 Strata 加载,并说“带独立 Engram 文件的 DeepSeek-V4.1 还不在 llama.cpp 里”。Strata 是 GitHub 上的开源项目(Niko1221/Strata,MIT 许可,2026-09-24 创建,我们读到时约 3.7 万星),Engram 也确实是 DeepSeek-V4.1 的结构,不是编造。但上游 llama.cpp 在 2026-10-25 已合并 deepseek41 架构,ISTA 卡片也在 10-27 更新,称其文件已采用 llama.cpp 自己的布局,b11870 及以上版本可加载。所以“llama.cpp 不兼容”对 AtomicChat 这批文件(卡片注明基于 ISTA 的某个较早修订)可能仍成立,对 ISTA 的未编辑文件已经过时。编辑版能不能用 ISTA 的转换脚本转过去,我们没有验证。
许可证方面,仓库、ISTA 的 GGUF 和 DeepSeek 原版都标 MIT,MIT 本身不禁止商用,所以转发里“MIT 支持科研与商用”在许可文本上没错。但“仅限科研、禁止公网商用”是转发者的建议,我们也同意这个建议,只是模型卡里并没有这样的条款。
风险、合规与负责任使用
这个模型被编辑成“基本不拒绝”,意味着它会回答原版会拒绝的请求,包括可能造成伤害的内容。我们不复现任何此类回答,也不提供使用它获得有害信息的方法。使用者应当明白:第一,MIT 许可只回答“版权上能不能用”,不回答“法律上能不能这样提供服务”。在中国面向公众提供生成式 AI 服务,要遵守《生成式人工智能服务管理暂行办法》(2023-08-15 起施行)等规定;在欧盟,高风险与通用模型的义务见 Regulation (EU) 2024/1689。以上只是一般信息,不是法律意见,实际义务请咨询合规人员。第二,更合理的用途是:红队测试与安全研究、研究“过度拒答”对任务的影响、小说与角色扮演等内部创作。第三,不要直接对公网开放。若用于内部研究,建议在输入输出两侧加分类器护栏(例如 Meta 的 Llama Guard 4)、记录日志、限制访问人群,并保留人工复核。
我们做了什么,没做什么
我们读取并交叉核对了:AtomicChat 的模型卡、cards/rungs.json、指标数据集中的 bake.json 与各档结果文件,ISTA-DASLab 的卡片,Strata 的 README 与 DeepSeek 文档。我们没有做的:没有下载任何权重,没有在任何硬件上运行,没有逐字节比对被编辑与未编辑文件,也没有验证 Strata 的下载包。所有“已验证”都指“与公开页面一致”,不是“我们复现了”。
常见问题
GSQ-RCO 是去审查方法吗?
不是。GSQ-RCO 是 ISTA-DASLab 的量化方法,用来把 DeepSeek-V4.1-Flash-1017 压成 1.75–2.25 bpw 的 GGUF。去拒绝的部分是 AtomicChat 之后加上的单方向编辑。
“abliteration 2.0”是新方法吗?
卡片写的是“单方向拒绝编辑,强度 2.0”,强度是参数,不是方法版本。这与我们在原理详解里介绍的拒绝方向消融同属一类。
拒答率真的降到 0 了吗?
在作者自己的测试里,英文 81 题、俄文 100 题基本为 0,XSTest 里 IQ2_XS 档仍有 0.4%。测试集小,分类器只看回答开头,所以不要把它理解为“任何提示都不会拒绝”。
KL 0.02 说明几乎无损吗?
只说明编辑本身对已量化的模型改动很小。基准是未编辑量化档,相对原版,2 位量化已有明显偏差(Strata 报 KL 0.170,困惑度 +15.5%)。
能在 12GB 显卡加 64GB 内存上用吗?
厂商自测 RTX 5070 12GB + 64GB 约 4–6 token/s,是未编辑的 2.00 bpw 档,需要约 250 GB 的固态硬盘空间。详细推算见我们的低显存部署篇。
可以公开商用吗?
许可证是 MIT,没有禁止商用的条款,但这不代表合规。面向公众提供服务要满足所在地的生成式 AI 规则,我们建议只用于内部研究并加护栏。
想核对自己的硬件和用途?
欢迎到社区交流,或发邮件到 admin@microaione.com,把你的显卡、内存和用途告诉我们,我们帮你判断这类模型是否值得折腾。
参考资料:AtomicChat 模型卡、ISTA-DASLab GSQ-RCO GGUF 卡片、Strata 项目、Llama Guard 4、EU AI Act。数据读取于 2026-11-01,均为各页面自报。
延伸阅读:拒答率评测详解;模型泄露与破解传闻的核查方法