Qwen 本地部署硬件要求:按型号算显存、内存与 KV 缓存,从 4B 到 122B 怎么配
“Qwen 本地部署硬件要求”是我们收到最多的问题之一,但通用答案“24GB 显存就够”经常是错的:同样叫 Qwen,4B 只要 3GB 左右,122B 要 80GB 以上,397B 要两百多 GB。更麻烦的是,权重只是显存需求的一部分,长上下文的 KV 缓存还会再吃掉几 GB 到几十 GB。这篇文章按官方模型卡里的结构参数,一步步算出各型号的权重体积、KV 缓存和速度上限,再给出分档的硬件建议。算式全部写出来,你可以直接替换成自己的型号和上下文。我们没有逐个型号实测,所以文中的体积来自 Ollama 页面和本站此前读取的数据,速度只给“带宽上限”这样的理论值。
要点速览(更新于 2026-11-04)
- 权重体积(Q4_K_M)约为 0.61 GB 每十亿参数:4B 约 2.4GB,27B 约 17–20GB,35B-A3B 约 22–23GB,122B 约 81GB,397B 约 240GB 以上。
Qwen3.5 以后的型号大量使用线性注意力(GDN)层,KV 缓存比传统架构小得多:Qwen3.6 27B 每个 token 约 64KiB,262K 上下文约 16GiB;35B-A3B 每个 token 只有约 20KiB。
24GB 显卡的实际可用显存约 23.4GB:27B Q4 加 32K 上下文约 21GB 可以跑;35B-A3B 光权重就逼近上限,需要把一部分专家放进内存。
- 速度上限 ≈ 显存带宽 ÷ 每个 token 要读取的权重字节数。27B 稠密模型在 4090 上理论上限约 54 tokens/s,实际要低;MoE 模型每个 token 只读激活参数,速度上限高得多。
先看结论:Qwen 本地部署硬件要求按显存分档
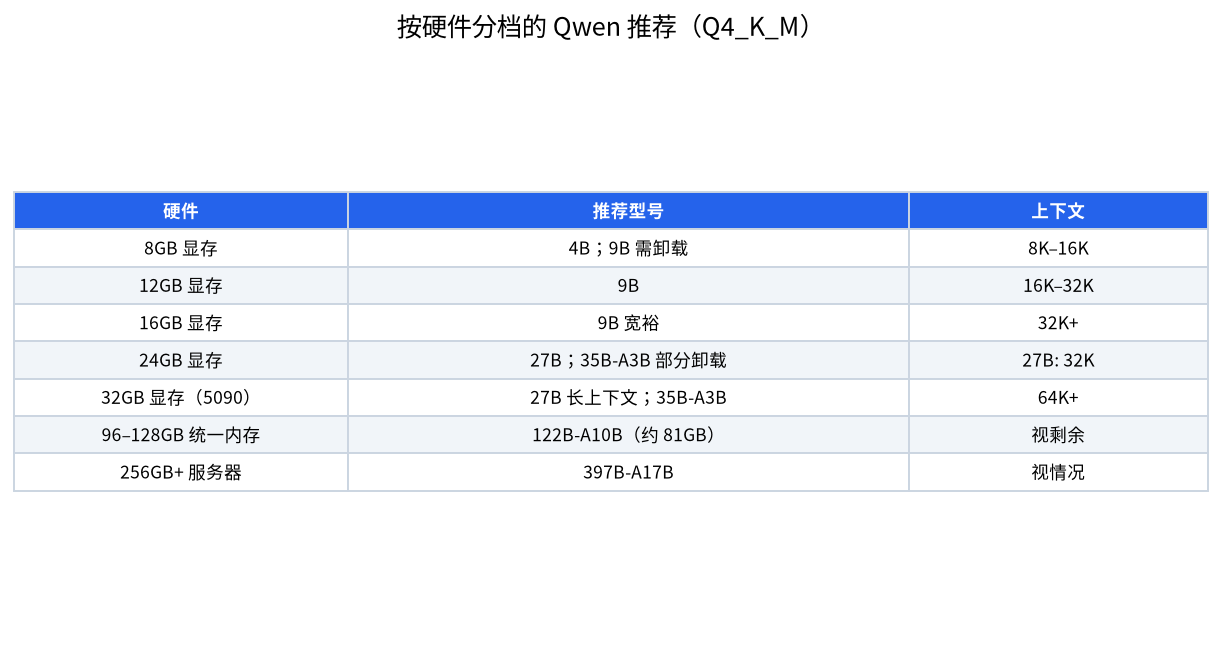
| 可用显存或内存 | 推荐型号(Q4_K_M) | 上下文建议 | 备注 |
|---|---|---|---|
| 8GB 显存 | 4B;9B 需压缩上下文并接受部分内存卸载 | 8K 到 16K | 9B 权重约 6.6GB,加缓存很紧 |
| 12GB 显存 | 9B 较舒适 | 16K 到 32K | 见 12GB 与 16GB 显存指南 |
| 16GB 显存 | 9B 宽裕;27B 不够 | 32K 以上 | 27B 权重 17–20GB 放不下 |
| 24GB 显存 | 27B;35B-A3B 需部分卸载到内存 | 27B:32K;更长要降缓存精度 | 详见 24GB 显存能跑什么 |
| 32GB 显存(5090) | 27B 长上下文;35B-A3B 全放显存 | 64K 以上 | 权重 22–23GB 加缓存 |
| 96GB 或 128GB 统一内存 | 122B-A10B(约 81GB) | 视剩余空间 | 速度取决于内存带宽 |
| 256GB 以上内存的服务器 | 397B-A17B | 视情况 | 非家用场景 |
下面解释这张表是怎么来的。
第一步:权重体积怎么算
量化后的权重体积 ≈ 参数量 × 每参数字节数。Q4_K_M 平均约 0.61 GB 每十亿参数(我们在 Q4_K_M 解读里给过推导),Q8_0 约 1.0625 字节每参数,BF16 是 2 字节每参数。
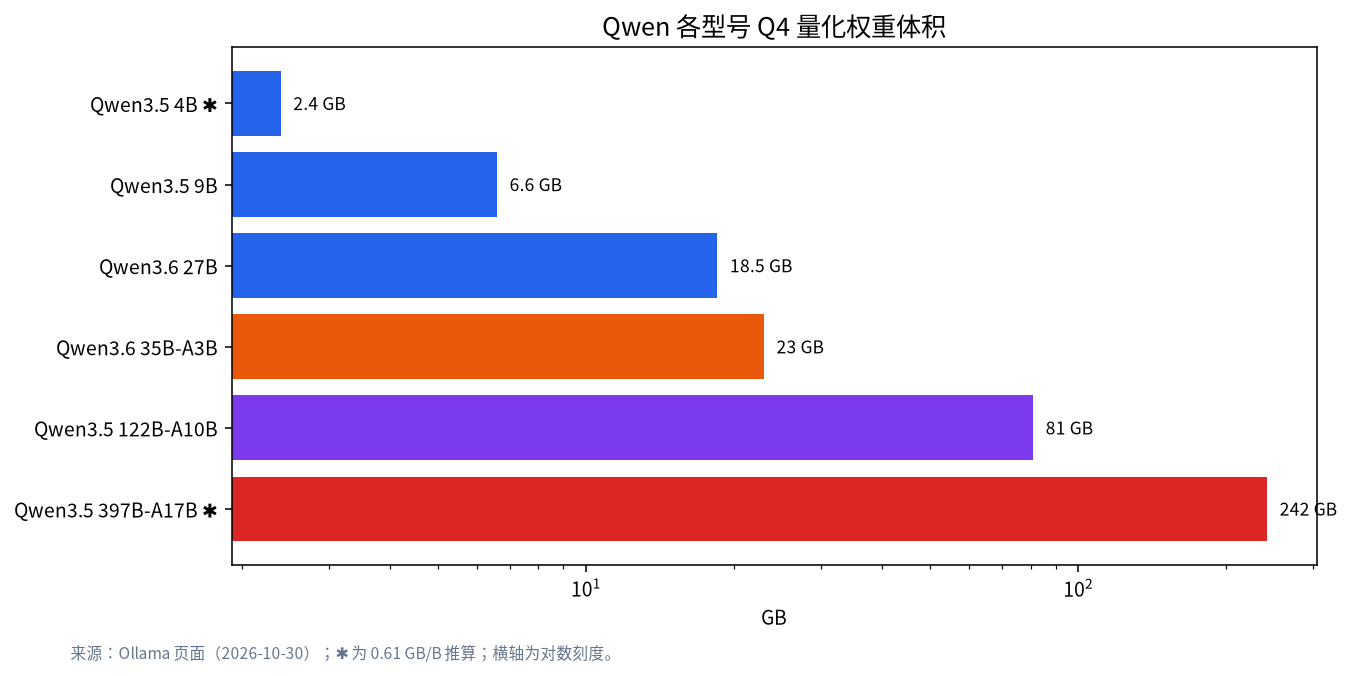
| 型号 | 参数量 | Q4 权重体积 | 来源 |
|---|---|---|---|
| Qwen3.5 4B | 4B | 约 2.4GB ✱ | 0.61 × 4 推算 |
| Qwen3.5 9B | 9B | 约 6.6GB | Ollama 页面 |
| Qwen3.6 / 3.8 27B | 27B | 17 到 20GB | Ollama 页面,随版本不同 |
| Qwen3.6 35B-A3B | 35B(激活约 3B) | 22 到 23GB | Ollama 页面 |
| Qwen3.5 122B-A10B | 122B(激活约 10B) | 约 81GB | Ollama 页面 |
| Qwen3.5 397B-A17B | 397B(激活约 17B) | 约 242GB ✱ | 0.61 × 397 推算 |
| Qwen3.8 2.4T-A95B | 2.4T(激活约 95B) | 约 1,464GB ✱ | 0.61 × 2,400 推算 |
最后一行的结论很直接:2.4T 不是本地模型,它需要多机集群;397B 也已经是服务器范畴。官方 GitHub 列出了这些型号的发布时间和参数,请以 QwenLM 官方仓库为准。需要补充的是,体积是“下载文件”的大小,实际显存还要加缓存和运行时开销,我们的估算习惯是预留约 0.6GB 的系统占用:8GB 卡可用约 7.4GB,12GB 约 11.4GB,24GB 约 23.4GB。
第二步:KV 缓存怎么算
KV 缓存是模型“记住”上下文所需的显存。传统注意力的 KV 缓存按层数、KV 头数、头维度和每个数值的字节数计算:
每个 token 的 KV 字节数 = 全注意力层数 × 2(K 和 V)× KV 头数 × 头维度 × 每数值字节数。
Qwen3.5 之后的型号混合使用线性注意力(Gated DeltaNet,GDN)和少量完整注意力层,而线性注意力层保存的是固定大小的状态,不随上下文增长。所以只需要计算“完整注意力层”。我们读取的官方模型卡参数如下:
| 型号 | 总层数 | 完整注意力层 | KV 头数 | 头维度 | 每 token KV(FP16) |
|---|---|---|---|---|---|
| Qwen3.6 27B | 64(16 组,每组 3 个 GDN 加 1 个完整注意力) | 16 | 4 | 256 | 64KiB |
| Qwen3.6 35B-A3B | 40 | 10 | 2 | 256 | 20KiB |
| Qwen3.8 2.4T-A95B | 92 | 23 | 4 | 256 | 92KiB |
算式示例(27B):16 × 2 × 4 × 256 × 2 字节 = 65,536 字节 = 64KiB 每 token。上下文 32K(32,768 token)时:64KiB × 32,768 = 2GiB;128K 时 8GiB;262K 时 16GiB。35B-A3B 的同样算式是 10 × 2 × 2 × 256 × 2 = 20,480 字节,即 20KiB;262K 时约 5GiB。
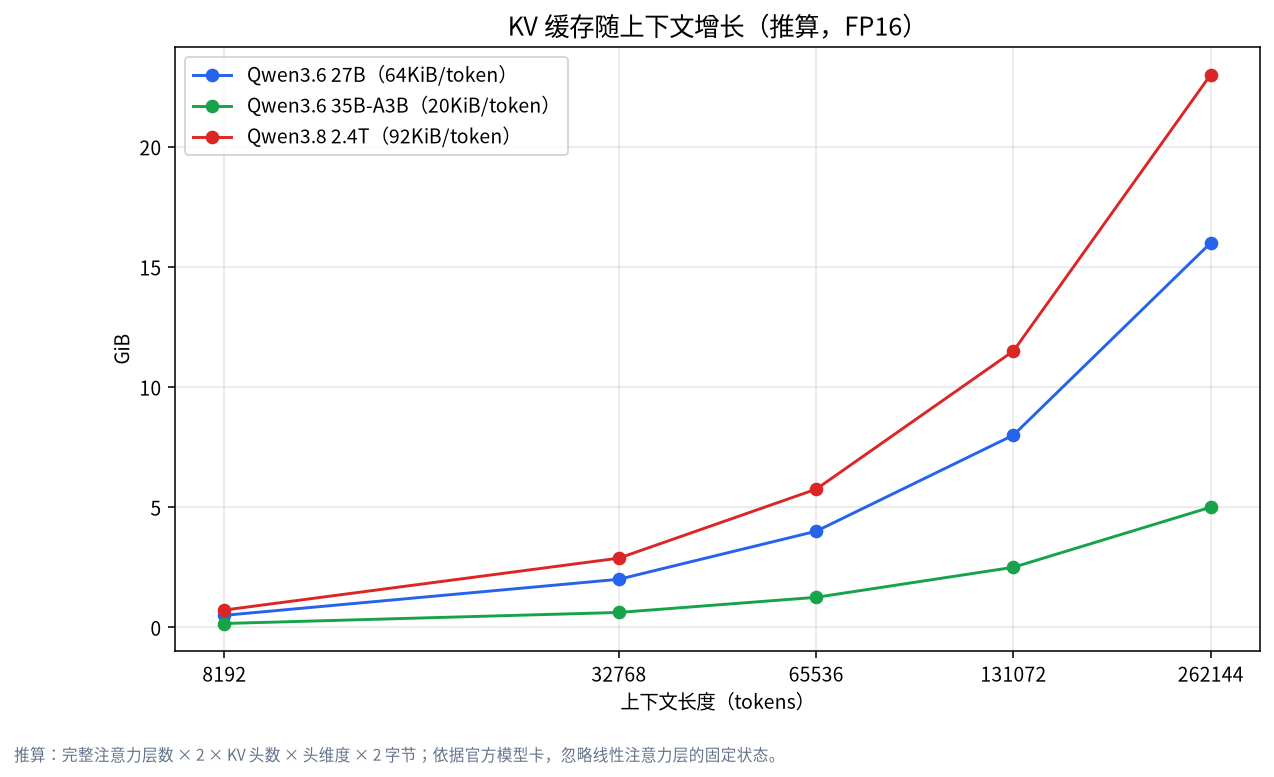
这些是推算值:它忽略了线性注意力层的固定状态、激活值、运行时缓冲区,所以实际占用会更高一些;而 llama.cpp 等运行时的缓存量化(例如 q8_0)可以把 KV 缓存大致减半,但会略微影响质量。通用的原理见 上下文长度与 KV 缓存。
第三步:把权重和缓存加起来
以 24GB 显卡(可用约 23.4GB)为例,预留约 1GB 给运行时开销:
| 场景 | 权重 | KV 缓存 | 运行时预留 | 合计 | 能否放进 24GB |
|---|---|---|---|---|---|
| 27B Q4,32K 上下文 | 约 18.5GB | 2GiB | 约 1GB | 约 21.5GB | 可以 |
| 27B Q4,128K 上下文,FP16 缓存 | 约 18.5GB | 8GiB | 约 1GB | 约 27.5GB | 放不下 |
| 27B Q4,128K 上下文,q8_0 缓存 | 约 18.5GB | 约 4.25GiB | 约 1GB | 约 23.8GB | 极限,不稳 |
| 35B-A3B Q4,32K 上下文 | 约 23GB | 约 0.62GiB | 约 1GB | 约 24.6GB | 放不下,需要卸载部分专家 |
注意第四行:35B-A3B 虽然每个 token 只激活约 3B 参数,但所有专家的权重都要放在某个地方。把一部分专家放进系统内存,是 MoE 模型在 24GB 显卡上的典型做法,原理和取舍见 MoE 本地部署和 内存与显存的取舍。
第四步:速度上限怎么估
生成每个 token 都要把被激活的权重从显存读一遍,所以速度的理论上限是:
上限(tokens/s)≈ 显存带宽 ÷ 每个 token 读取的权重字节数。
RTX 4090 的显存带宽是 1008 GB/s。27B 稠密模型 Q4 约 18.5GB,每个 token 都要读完:1008 ÷ 18.5 ≈ 54 tokens/s,实际会低于这个值(经验上常常只有理论上限的一部分,我们没有实测)。35B-A3B 每个 token 只读激活的约 3B 参数,Q4 约 0.61 × 3 ≈ 1.8GB,如果全放显存,上限是 1008 ÷ 1.8 ≈ 550 tokens/s;如果被激活的专家在系统内存里,DDR5-5600 双通道理论带宽约 89.6GB/s(5600 × 8 字节 × 2),上限降到约 89.6 ÷ 1.8 ≈ 50 tokens/s。
这个差别说明:对 MoE 模型,“专家放哪”比“总参数多大”更决定速度。122B-A10B 的 Q4 约 81GB,在 128GB 统一内存的机器上,如果内存带宽约 250GB/s,每个 token 读约 6GB(0.61 × 10),上限约 40 tokens/s;这只是理论值。
按预算的推荐显卡
| 预算(参考价) | 显卡 | 适合型号 | 提示 |
|---|---|---|---|
| 约 3,500 元 | RTX 3060 12GB(新卡) | 4B、9B | 入门 |
| 约 5,600 元 | RTX 5060 Ti 16GB | 9B 宽裕 | 见 5060 Ti 16GB 评测 |
| 约 7,550 元 | 二手 RTX 3090 24GB | 27B | 二手风险见相关指南 |
| 约 26,465 元 | RTX 4090 24GB | 27B,速度更快 | 同样 24GB 容量 |
| 约 53,500 元 | RTX 5090 32GB | 27B 长上下文、35B-A3B | 建议 1000W 电源 |
| 数万元 | 96GB 工作站卡或 128GB 统一内存整机 | 122B-A10B | 见 RTX PRO 6000 工作站 |
价格是我们 2026-10-30 的参考价,购买前请核对。同样 24GB,二手 3090 和 4090 的区别主要在速度和价格,容量决定“能不能跑”,带宽决定“多快”。
四个常见误区
误区一:参数量等于显存占用。 35B-A3B 的“A3B”指每个 token 激活约 3B 参数,影响的是速度,不是容量;所有专家的权重仍然要放得下。
误区二:显存够放权重就行。 缓存和运行时开销同样占显存。权重 22GB 放进 24GB 卡看似可行,一加上下文就会溢出到内存,速度骤降。
误区三:带宽不重要。 同样是 24GB,二手 3090 的带宽是 936 GB/s,4090 是 1008 GB/s,差距不大;但用 DDR5 内存(约 90GB/s)当“显存”时,速度会降到十分之一量级。
误区四:越大的量化越好。 对 27B,Q8_0 约需 29GB(27 × 1.0625),已经超过 24GB;多数情况下 Q4_K_M 加更长上下文,比 Q8 加极短上下文更实用。
一个完整算例:为 27B 配一台机器
目标:本地跑 Qwen3.6 27B,上下文 64K,单人使用。
- 权重:Q4 约 18.5GB。
- KV 缓存:64KiB × 65,536 token = 4GiB(FP16);用 q8_0 缓存约 2.1GiB。
- 运行时预留:约 1GB。
- 合计:FP16 缓存约 23.5GB(超出 24GB 卡可用的 23.4GB 一点点,不稳);q8_0 缓存约 21.6GB,可行。
- 速度上限:4090 约 54 tokens/s,3090 为 936 ÷ 18.5 ≈ 51 tokens/s;两者差别不大,二手 3090 的性价比更高。
- 配置:二手 3090 整机参考价约 14,299 元,4090 整机约 33,214 元,价差主要换来更快的预填充和更好的能效。
这个算例说明:选卡先看容量,再看带宽,最后才看品牌代际。
怎么自己验证
不要只相信算式。运行后用 nvidia-smi 查看实际显存占用,对比我们的推算;调整上下文长度,观察占用的增长斜率是否接近每 token 64KiB。如果实际值明显更大,说明运行时给缓存分配了更多空间或启用了更大的批处理,可以按文档调小相关参数。
速度也一样:先用同一个提示、同样的上下文长度,记录生成阶段的 tokens/s,再与前面的带宽上限相比。如果实测接近上限的六到八成,说明配置合理;如果只有两三成,大概率是部分层或专家落到了内存,或者线程、批大小、驱动设置不对,应当先排查这些,而不是急着换显卡。把你的实测值和命令发到社区,我们可以帮你对照。
内存、硬盘与其他配置
- 系统内存: 全放显存的场景下,16GB 内存够用;需要卸载专家或层到内存时,建议 64GB 起,122B 需要 128GB。
- 硬盘: 模型文件 5GB 到 80GB,建议 NVMe 固态,并预留多个版本的空间。
- 电源: 4090 整机建议 850W,5090 整机建议 1000W,参考价目表中也是这样配的。
- 系统: Windows 通过 WSL2 或原生运行时均可,见 Windows、WSL2 与 Docker。
常见问题 FAQ
通义千问本地部署配置需求是什么?千问本地部署硬件要求怎么估?
通义千问本地部署配置需求(千问本地部署硬件要求 / 千问本地部署要求)按参数量与量化档估算显存:同系列越大越吃显存,MoE 还要看激活参数。先定目标模型,再选显卡,算例见正文。
Qwen 本地部署硬件要求最低是多少?
最小的几个型号(0.8B、2B、4B)在 8GB 内存的电脑上也能跑,甚至不需要独立显卡。要有实用的质量,建议从 9B 开始,需要约 8GB 到 12GB 显存。
Qwen3.6 27B 需要多少显存?
Q4 量化权重约 18 到 19GB,加 32K 上下文的 KV 缓存约 2GiB,再加运行时开销约 1GB,总计约 21.5GB,所以 24GB 显卡可以跑。
24GB 显卡能跑 Qwen3.6 35B-A3B 吗?
权重约 22 到 23GB,几乎占满显存,需要把一部分专家放进系统内存才稳定。得益于每个 token 只激活约 3B 参数,速度通常仍然可用,但取决于内存带宽。
为什么 Qwen 的长上下文占显存这么少?
因为较新的型号只有四分之一左右的层使用完整注意力,其余层用线性注意力,状态大小固定。我们算出 27B 在 262K 上下文下的 KV 缓存约 16GiB,传统架构同样规模会大得多。
Qwen 3.8 2.4T 能本地部署吗?
不现实。按 Q4 约 1.46TB,需要多机集群,家用硬件无法承载。
Mac 可以跑 Qwen 吗?
可以,统一内存的大容量让 Mac 适合跑 27B 到 122B 级别,速度取决于内存带宽,见我们的 Mac 本地大模型指南。
和我们聊聊
如果你想让我们按你的显卡、内存和上下文需求算一遍,请在社区留言你的配置和想跑的型号,或发邮件到 admin@microaione.com。更完整的部署步骤见 Qwen 本地部署教程;如果你关心 Qwen 本地部署是否要“破甲”,见 Qwen 本地部署需要破甲吗。
参考资料:QwenLM 官方 GitHub、Ollama Qwen3 页面、llama.cpp。型号参数读取于 2026-11-04,体积读取于 2026-10-30,北京时间。