Requisitos de hardware de Strata: cuánta RAM, VRAM y SSD necesitas, con configuraciones por presupuesto
Actualizado 2026-11-04. No hemos ejecutado Strata nosotros mismos. Cada requisito de abajo viene de los documentos del proyecto o de un probador con nombre, y cada velocidad es suya.
Los requisitos de hardware de Strata son la razón por la que esta herramienta resulta interesante: un modelo de 125.000 millones de parámetros en una tarjeta gráfica de 12 GB parece imposible hasta que ves dónde está realmente el peso. El resumen honesto es que la GPU es la parte más pequeña de la factura. La mayor parte del modelo vive en la RAM del sistema, una parte menor en el SSD y la GPU guarda una caché de los expertos que más usa. Este artículo convierte la documentación y los informes de los probadores en números con los que planificar un PC, esboza niveles de configuración y dice dónde no adivinaríamos. Si aún no conoces la herramienta, lee primero qué es Strata.
La respuesta corta sobre los requisitos de hardware de Strata
| Pieza | Mínimo práctico | Cómodo |
|---|---|---|
| GPU | NVIDIA RTX serie 20 a 50 de 12 GB (las tarjetas antiguas usan un motor CUDA 12); AMD, Intel Arc y Apple Silicon tienen sus propias guías | 16 a 24 GB, o dos tarjetas |
| RAM | Unos 48 GB para los dos tamaños más pequeños | 64 GB para cualquier tamaño; más con contextos largos |
| SSD | Unos 80 GB libres, mejor NVMe | 1 TB para conservar varios tamaños |
| CPU | x86-64 moderna; el motor tiene rutas de código AVX2 y AVX-512 | AVX-512 ayuda, según los probadores |
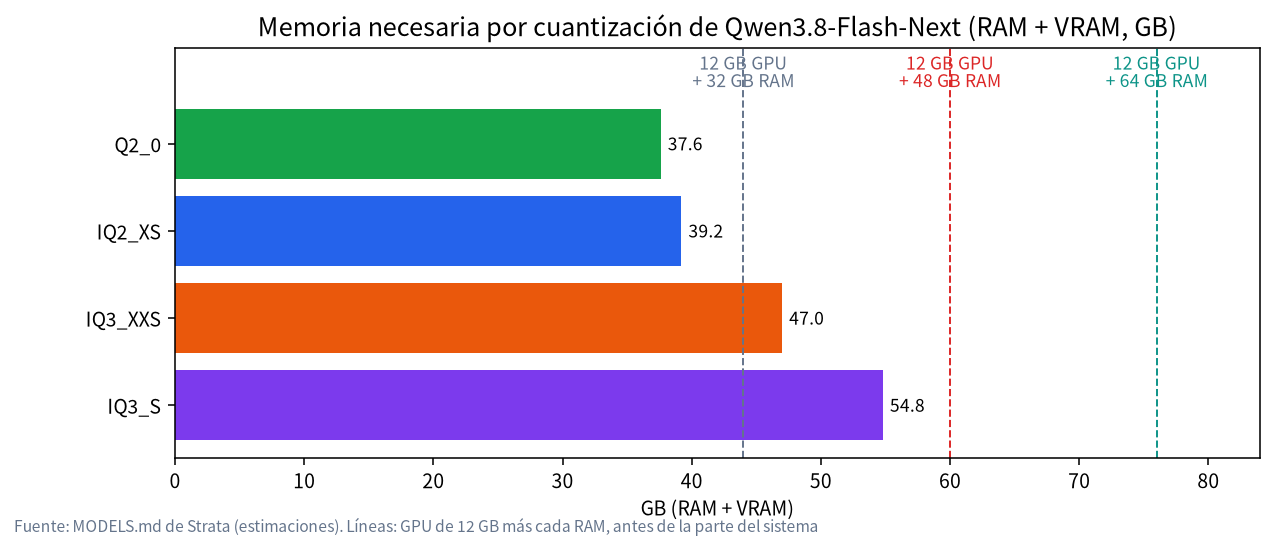
La página de modelos del proyecto da los pesos como RAM más VRAM: 37,6 GB para Q2_0, 39,2 para IQ2_XS, 47,0 para IQ3_XXS y 54,8 para IQ3_S. Dice que dejes espacio para el sistema operativo y que las cifras son estimaciones. Un analista de AkitaOnRails escribió que el mínimo declarado por el proyecto es de 32 GB de RAM y VRAM combinadas, que eso solo ejecuta la versión más comprimida y que el IQ3_S que puntuó bien en sus pruebas pedía unos 64 GB de RAM.
Qué hace cada pieza
GPU y VRAM. Según el documento HOW_IT_WORKS del proyecto, la tarjeta guarda las capas de atención, los enrutadores, los expertos compartidos, la caché KV y una caché de expertos que llena la VRAM restante, con unos 700 expertos por gigabyte adicional. Una caché mayor significa que más tokens se calculan en la GPU. PC Watch midió unos 3.031 expertos en una tarjeta de 12 GB y un 72 % de aciertos con IQ2_XS, frente a 1.104 expertos y un 56 % con IQ3_S. El número de peticiones paralelas también sigue a la VRAM: 1 con 12 GB, 2 con 20 GB, 3 con 24 GB y 4 con 32 GB o más.
RAM. Los 24.576 expertos están en memoria fijada y la CPU calcula los que la GPU no tiene. La capacidad de RAM decide qué tamaño puedes ejecutar, y la velocidad de la RAM y las instrucciones de la CPU deciden la rapidez de los fallos. PC Watch señaló el ancho de banda de DDR4 y la falta de AVX-512 en su CPU de prueba como factores que frenan, y otro probador japonés dijo lo mismo de una CPU sin AVX-512.
SSD. Una tabla n-gram de 28,8 GB se lee unas pocas filas por token. Si falta RAM, un modo opcional lee expertos desde el disco, lo que la documentación dice que funciona pero es mucho más lento. En un portátil con 30 GB de RAM, el analista de arm1.ru midió unos 6,9 TB leídos del SSD en una prueba de 1,3 horas (1,4 GB/s de media).
CPU. No es una especificación de titular, pero hace trabajo real en cada fallo de caché. El motor tiene rutas de código separadas para CPU con y sin AVX-512.
Niveles de configuración, con lo que reportaron los probadores
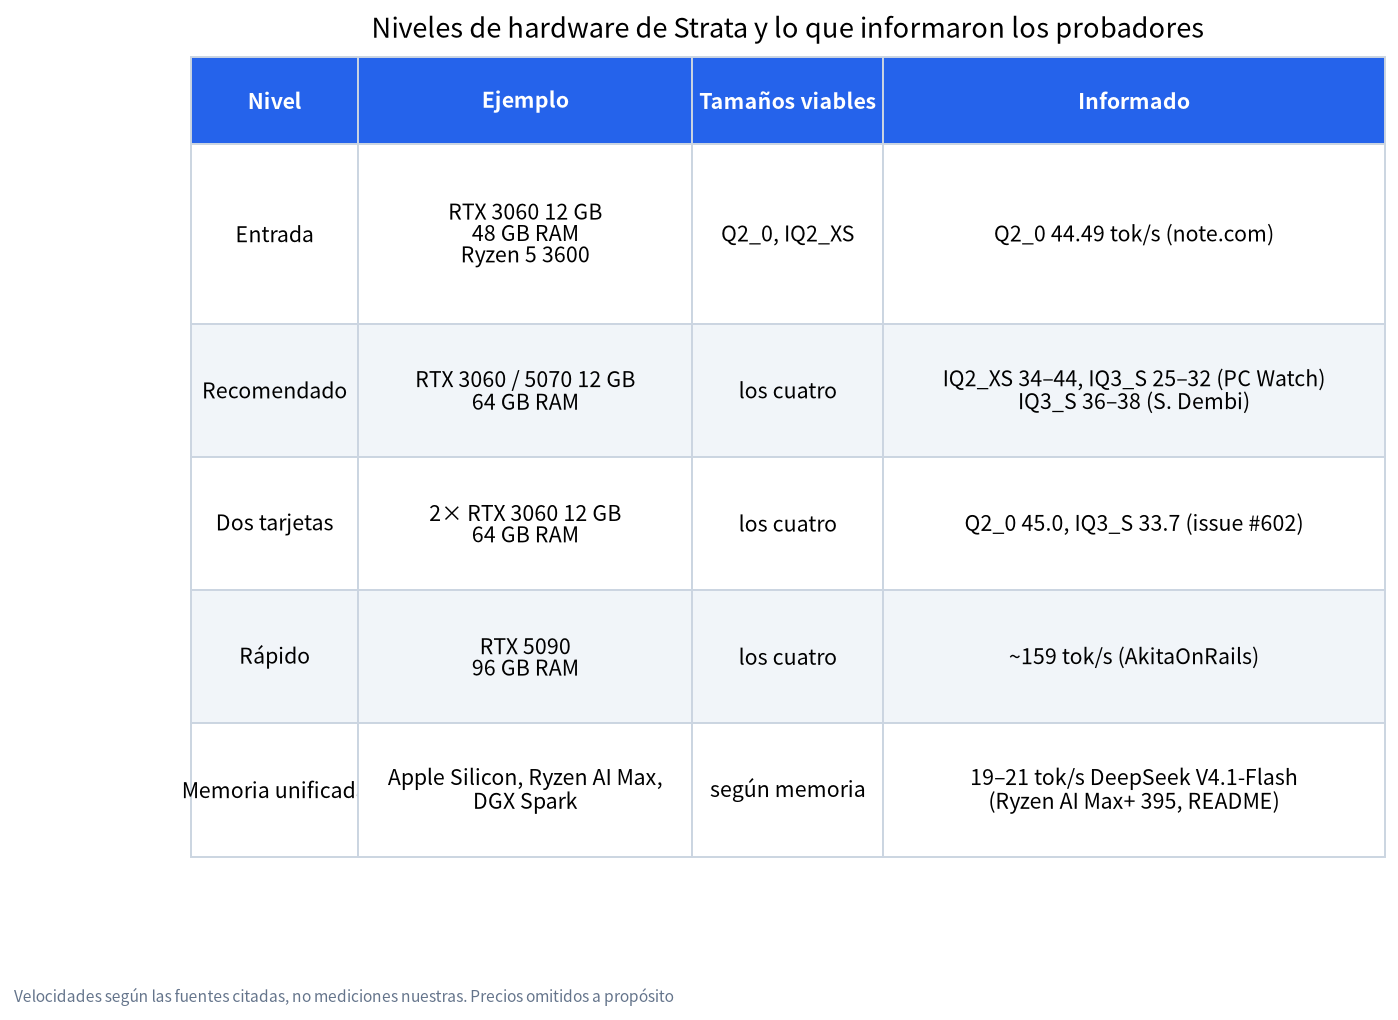
| Nivel | Piezas de ejemplo | Tamaños que caben | Lo que reportaron las fuentes |
|---|---|---|---|
| Básico | RTX 3060 12 GB, 48 GB de RAM, Ryzen 5 3600 | Q2_0, IQ2_XS | Q2_0 a 44,49 tok/s de generación, 326,68 tok/s de prefill (note.com) |
| Recomendado | RTX 3060 o RTX 5070 de 12 GB, 64 GB de RAM | Los cuatro | IQ2_XS de 34 a 44 e IQ3_S de 25 a 32 tok/s (PC Watch); IQ3_S de 36 a 38 tok/s con unos 50 GiB de RAM (Dembi) |
| Dos tarjetas | 2× RTX 3060 de 12 GB, 64 GB de RAM | Los cuatro | Q2_0 45,0 e IQ3_S 33,7 tok/s (incidencia del proyecto #602); el multi-GPU reparte por capas y no necesita NVLink |
| Rápido | RTX 5090, 96 GB de RAM, CPU potente | Los cuatro | Unos 159 tok/s y una puntuación de 91 en el benchmark del propio autor (AkitaOnRails) |
| Memoria unificada | Apple Silicon (macOS 15+), Ryzen AI Max, DGX Spark | Según la memoria | El propio README del proyecto reporta de 19 a 21 tok/s (código) para DeepSeek V4.1-Flash en un Ryzen AI Max+ 395 con 128 GB |
Hemos dejado fuera los precios de esta tabla a propósito. Los precios de GPU y memoria cambian cada semana, y las fuentes anteriores no daban precios fechados que pudiéramos comprobar. Nuestras guías de precios fechadas son mejor punto de partida: configuración básica, configuración con GPU de 24 GB, comprar GPU de segunda mano y GPU baratas para LLM.
Planificación de disco y SSD
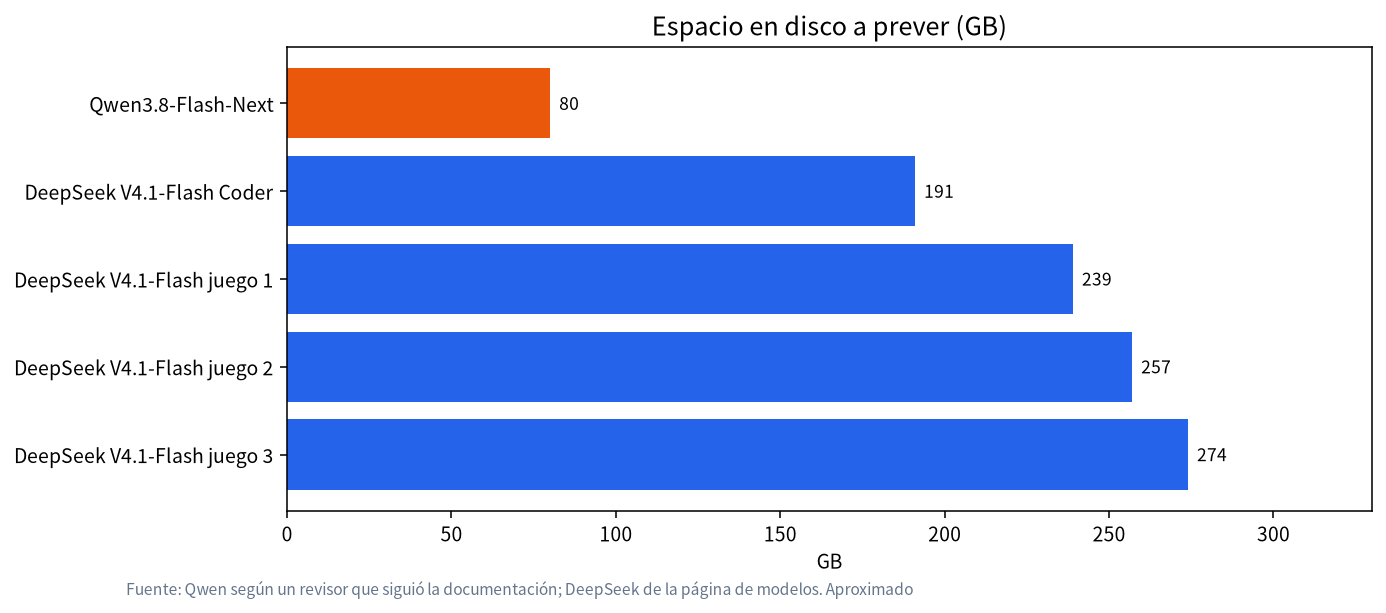
Para Qwen3.8-Flash-Next cuenta con unos 80 GB libres, sobre todo porque la descarga incluye los expertos cuantizados, archivos auxiliares y la tabla n-gram. DeepSeek V4.1-Flash necesita de 191 a 274 GB según el conjunto; nuestro artículo DeepSeek V4.1 Flash en 12 GB trata ese caso. Las lecturas no desgastan un SSD, pero una unidad ocupada ralentiza todo lo demás, así que si puedes, pon la carpeta de Strata en un disco NVMe que no sea el del sistema.
Portátiles, WSL2 y memoria unificada
Los portátiles son el caso incómodo. El analista de arm1.ru ejecutó el modelo de 125B en una GPU de portátil RTX 5080 con 30 GB de RAM y vio que funcionaba, pero la memoria iba justa: Strata usó unos 21 GB de RAM y de 4 a 5 GB de swap, y por eso llamaríamos a 32 GB de RAM un truco y no un plan. Windows con WSL2 también funciona, como muestra el índice comunitario con una RTX 5060 Ti, aunque la documentación señala que con los controladores gráficos de Windows solo se fija una parte de la memoria de expertos en ejecuciones multi-GPU. En máquinas de memoria unificada como Strix Halo, la memoria gráfica y la RAM son el mismo conjunto, así que una cifra de 128 GB sustituye a los números separados de VRAM y RAM de las tablas anteriores.
Más resultados del índice de benchmarks del propio proyecto
El repositorio mantiene un índice comunitario de benchmarks con ejecuciones enviadas por usuarios. Son autoinformadas, usan versiones distintas (de v0.1.40 a v0.1.43) y longitudes de prompt distintas, y no hemos reproducido ninguna, así que toma la tabla como una idea del rango y no como una clasificación.
| Hardware (según lo enviado) | Tamaño | Generación, tok/s |
|---|---|---|
| RX 9070 16 GB, Ryzen 7 5800X3D, 64 GB de RAM | IQ3_XXS | de 57,9 a 58,7 |
| RTX 5060 Ti 16 GB (WSL2), Ryzen 7 3700X, 128 GB de RAM | IQ3_S | de 47,7 a 48,2 |
| 2× Tesla P40 24 GB, Xeon E5-2699 v3, 125 GB de RAM | IQ3_S | 35,0 |
| Tesla V100 32 GB, Threadripper 2990WX, 96 GB de RAM | UD-IQ4_XS | de unos 28 a 33 |
| Portátil Strix Halo, 128 GB unificados, 70 W | UD-IQ4_XS | de 42 a 59, según la longitud del prompt |
Destacan dos cosas. Las tarjetas de 16 GB del índice reportan velocidades mayores que las cifras de 12 GB de arriba para tamaños comparables, lo que encaja con el diseño de caché de expertos, aunque las CPU y las versiones difieren. Y las viejas tarjetas de estación de trabajo de 24 GB aún funcionan a una velocidad útil si la RAM es grande. Ambas cosas concuerdan con el orden de mejora de abajo, pero son envíos individuales, así que no las leas como garantías.
Estima tu propio equipo
Suma VRAM y RAM y resta el tamaño del modelo: lo que queda es el espacio para el sistema operativo, el navegador, la caché KV y todo lo demás. Es aritmética simple sobre las cifras del proyecto, no una medición.
| Configuración (VRAM + RAM) | Total | Margen con IQ2_XS (39,2 GB) | Margen con IQ3_S (54,8 GB) |
|---|---|---|---|
| 12 GB + 32 GB | 44 GB | unos 4,8 GB, muy justo | no cabe |
| 12 GB + 48 GB | 60 GB | unos 20,8 GB | unos 5,2 GB, muy justo |
| 12 GB + 64 GB | 76 GB | unos 36,8 GB | unos 21,2 GB |
Cuanto menos margen, más probable es que acabes haciendo swap como el portátil de arm1.ru, y la velocidad se resiente. Nuestro consejo es no perseguir el mayor tamaño en un equipo «justo»: elige un tamaño menos y guarda el margen para contextos largos y el uso diario. La misma aritmética te dice qué memoria comprar: decide primero el tamaño y calcula hacia atrás, en vez de comprar primero y esperar que quepa.
Orden de mejora, según leemos los documentos
Es una inferencia nuestra de cómo el proyecto describe su diseño, no una clasificación medida.
- RAM hasta 64 GB. Ahí viven todos los expertos, así que decide qué tamaños puedes ejecutar. Suele ser el paso grande más barato.
- Más VRAM. Cada gigabyte añade unos 700 expertos en caché, y una mayor tasa de aciertos supone menos cálculos de CPU.
- Una CPU con AVX-512 y memoria más rápida. Ayuda con los fallos, según dos probadores.
- Almacenamiento NVMe. Importa más si hay que leer expertos desde el disco.
Para los compromisos de memoria detrás de esto, consulta nuestra guía de RAM vs VRAM y descarga a CPU y nuestra guía de VRAM de GPU.
Cuándo tiene sentido un PC a medida
Comprar piezas es lo difícil: casar una tarjeta de 12 o 24 GB, suficientes ranuras de RAM, una unidad NVMe, una fuente de alimentación y refrigeración. Si prefieres no hacerlo, nuestro equipo en Shenzhen monta y prueba máquinas para LLM locales, y la guía de máquinas y soluciones explica cómo funciona. Dinos tu modelo objetivo, presupuesto y límites de ruido y te propondremos una lista de piezas con precios fechados. No hemos medido Strata en ninguna máquina, así que pídenos una prueba en la configuración concreta que estés considerando en lugar de dar por buenas las cifras de arriba. La potencia y el calor se tratan en nuestra guía de potencia y refrigeración.
Lo que hicimos y lo que no
El 2026-11-04 leímos los documentos MODELS, HOW_IT_WORKS y multi-GPU del proyecto y los informes de los probadores enlazados arriba. No montamos ninguna máquina, no ejecutamos ningún benchmark y no citamos precios. Cuando una cifra viene de una sola persona, la nombramos.
Preguntas frecuentes (FAQ)
¿Puedo ejecutar Strata con una GPU de 8 GB?
La vía oficial recomienda 12 GB o más. El índice comunitario del proyecto lista dos Quadro RTX 4000 de 8 GB con 96 GB de RAM ejecutando IQ2_XS a de 18 a 23 tokens/s de generación con prompts muy largos, pero son dos tarjetas y mucha RAM, y no lo hemos verificado.
¿Bastan 32 GB de RAM?
Es justo. Los pesos solos necesitan de 37,6 a 54,8 GB de RAM más VRAM, así que 12 GB de VRAM y 32 GB de RAM apenas cubren el tamaño más pequeño sobre el papel, antes de la parte del sistema operativo. La variante del proyecto centrada en código figura con unos 32 GB de RAM. Para los tamaños estándar, 48 GB es el mínimo práctico y 64 GB es lo cómodo.
¿Importa la velocidad de la RAM?
Sí, porque la CPU calcula los expertos que no están en la GPU. Los probadores señalaron el ancho de banda de DDR4 y la falta de AVX-512 como factores, pero no tenemos una comparación controlada.
¿Necesito un SSD NVMe?
Para la vía estándar necesitas sobre todo espacio, unos 80 GB. NVMe importa más si falta RAM y Strata debe leer expertos desde el disco.
¿Puedo usar AMD, Intel o un Mac?
El proyecto lista tarjetas AMD Radeon compatibles, Intel Arc en Linux, Apple Silicon con macOS 15 o posterior, Ryzen AI Max y DGX Spark, cada una con su propia guía. Consulta la guía de instalación de tu tarjeta.
¿Son mejores dos GPU pequeñas que una grande?
Un probador midió dos tarjetas RTX 3060 a 45,0 tokens por segundo con Q2_0, frente a cifras de los 40 en tarjetas únicas de otros probadores, así que la ganancia no es evidente en ese tamaño. Puede ayudar más con tamaños mayores, pero no encontramos una comparación controlada.
Habla con nosotros
¿Planeas una configuración en torno a una GPU, RAM y presupuesto? Únete a la comunidad o escribe a admin@microaione.com y cuéntanos lo que tienes.