Strata Hardware-Anforderungen: Wie viel RAM, VRAM und SSD Sie brauchen, mit Ausbaustufen
Aktualisiert 2026-11-04. Wir haben Strata nicht selbst ausgeführt. Jede Anforderung unten stammt aus den Dokumenten des Projekts oder von einem namentlich genannten Tester, und jedes Tempo ist dessen Wert.
Die Strata Hardware-Anforderungen sind der Grund, warum dieses Werkzeug interessant ist: Ein Modell mit 125 Milliarden Parametern auf einer 12-GB-Grafikkarte klingt unmöglich, bis man sieht, wo das Gewicht tatsächlich liegt. Die ehrliche Zusammenfassung lautet: Die GPU ist der kleinste Posten der Rechnung. Der größte Teil des Modells liegt im Arbeitsspeicher, ein kleinerer Teil auf der SSD, und die GPU hält einen Cache der am häufigsten genutzten Experten. Dieser Artikel macht aus Dokumentation und Testerberichten Zahlen, mit denen Sie einen PC planen können, skizziert Ausbaustufen und sagt, wo wir nicht raten würden. Wenn Sie das Werkzeug noch nicht kennen, lesen Sie zuerst, was Strata ist.
Die Strata Hardware-Anforderungen in Kürze
| Teil | Praktisches Minimum | Komfortabel |
|---|---|---|
| GPU | 12 GB NVIDIA RTX der Serien 20 bis 50 (ältere Karten nutzen eine CUDA-12-Engine); AMD, Intel Arc und Apple Silicon haben eigene Anleitungen | 16 bis 24 GB oder zwei Karten |
| RAM | Etwa 48 GB für die beiden kleinsten Größen | 64 GB für jede Größe; mehr bei langen Kontexten |
| SSD | Etwa 80 GB frei, NVMe bevorzugt | 1 TB, um mehrere Größen zu behalten |
| CPU | Moderne x86-64; die Engine hat AVX2- und AVX-512-Codepfade | AVX-512 hilft laut Testern |
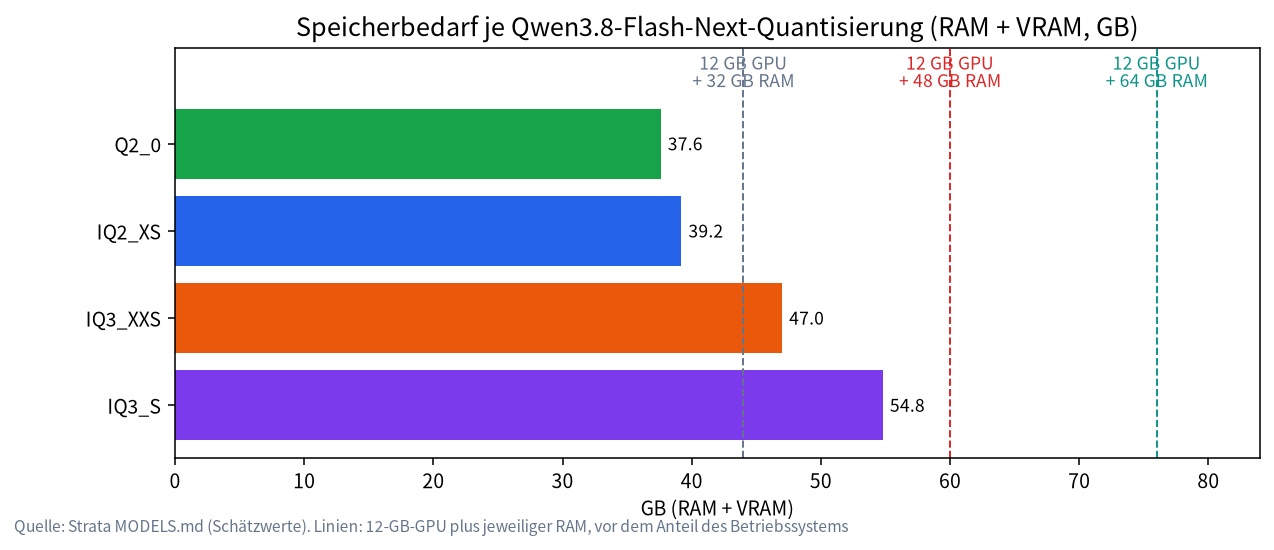
Die Modellseite des Projekts nennt die Gewichte als RAM plus VRAM: 37,6 GB für Q2_0, 39,2 für IQ2_XS, 47,0 für IQ3_XXS und 54,8 für IQ3_S. Sie sagt, man solle Platz für das Betriebssystem lassen, und dass die Zahlen Schätzungen sind. Ein Tester bei AkitaOnRails schrieb, das vom Projekt genannte Minimum seien 32 GB RAM und VRAM zusammen, das führe nur die am stärksten komprimierte Version aus, und das IQ3_S, das in seinen Tests gut abschnitt, wolle etwa 64 GB RAM.
Was jedes Teil tut
GPU und VRAM. Laut dem HOW_IT_WORKS-Dokument des Projekts hält die Karte Attention-Schichten, Router, gemeinsame Experten, den KV-Cache und einen Expertencache, der den restlichen VRAM füllt, mit etwa 700 Experten pro zusätzlichem Gigabyte. Ein größerer Cache bedeutet, dass mehr Token auf der GPU berechnet werden. PC Watch maß etwa 3.031 Experten auf einer 12-GB-Karte und eine Trefferquote von 72 % mit IQ2_XS, gegenüber 1.104 Experten und 56 % mit IQ3_S. Auch die Zahl der parallelen Anfragen folgt dem VRAM: 1 bei 12 GB, 2 bei 20 GB, 3 bei 24 GB und 4 ab 32 GB.
RAM. Alle 24.576 Experten liegen im fixierten Speicher, und die CPU berechnet die, die der GPU fehlen. Die RAM-Kapazität entscheidet, welche Größe Sie ausführen können; RAM-Geschwindigkeit und CPU-Befehle entscheiden, wie schnell die Fehlgriffe sind. PC Watch nannte die DDR4-Bandbreite und das Fehlen von AVX-512 bei seiner Test-CPU als bremsende Faktoren, und ein anderer japanischer Tester sagte dasselbe über eine CPU ohne AVX-512.
SSD. Eine 28,8 GB große n-Gramm-Tabelle wird mit wenigen Zeilen pro Token gelesen. Fehlt RAM, streamt ein optionaler Modus Experten von der Platte, was laut Dokumentation funktioniert, aber viel langsamer ist. Auf einem Laptop mit 30 GB RAM maß der Tester von arm1.ru etwa 6,9 TB, die in einem 1,3-stündigen Testlauf von der SSD gelesen wurden (durchschnittlich 1,4 GB/s).
CPU. Keine Schlagzeilen-Spezifikation, aber sie leistet bei jedem Cache-Fehlgriff echte Arbeit. Die Engine hat getrennte Codepfade für CPUs mit und ohne AVX-512.
Ausbaustufen, mit dem, was Tester meldeten
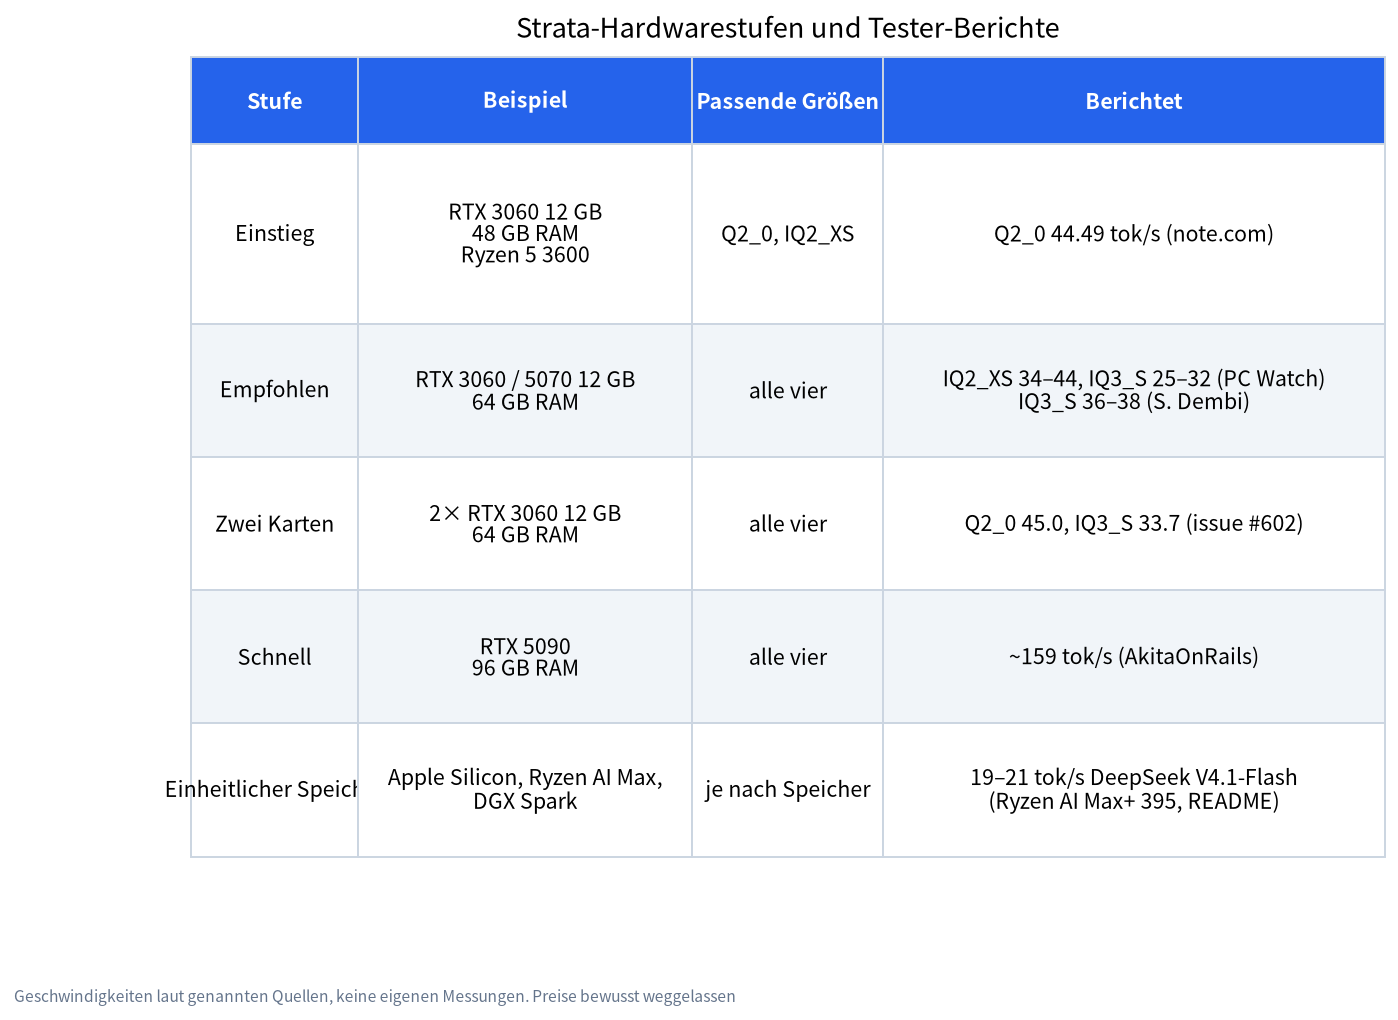
| Stufe | Beispielteile | Passende Größen | Was die Quellen meldeten |
|---|---|---|---|
| Einstieg | RTX 3060 12 GB, 48 GB RAM, Ryzen 5 3600 | Q2_0, IQ2_XS | Q2_0 mit 44,49 tok/s Generierung, 326,68 tok/s Prefill (note.com) |
| Empfohlen | RTX 3060 oder RTX 5070 mit 12 GB, 64 GB RAM | Alle vier | IQ2_XS 34 bis 44 und IQ3_S 25 bis 32 tok/s (PC Watch); IQ3_S 36 bis 38 tok/s mit etwa 50 GiB RAM (Dembi) |
| Zwei Karten | 2× RTX 3060 12 GB, 64 GB RAM | Alle vier | Q2_0 45,0 und IQ3_S 33,7 tok/s (Projekt-Issue #602); Multi-GPU teilt nach Schichten und braucht kein NVLink |
| Schnell | RTX 5090, 96 GB RAM, starke CPU | Alle vier | Etwa 159 tok/s und 91 Punkte im eigenen Benchmark des Autors (AkitaOnRails) |
| Unified Memory | Apple Silicon (macOS 15+), Ryzen AI Max, DGX Spark | Nach Speicher | Das README des Projekts selbst meldet 19 bis 21 tok/s (Code) für DeepSeek V4.1-Flash auf einem Ryzen AI Max+ 395 mit 128 GB |
Preise haben wir bewusst nicht in diese Tabelle aufgenommen. GPU- und Speicherpreise ändern sich von Woche zu Woche, und die obigen Quellen nannten keine datierten Preise, die wir prüfen konnten. Unsere datierten Preisleitfäden sind der bessere Startpunkt: Einstiegs-Build, Build mit 24-GB-GPU, Gebrauchte GPUs kaufen und Günstige GPUs für LLMs.
Platten- und SSD-Planung
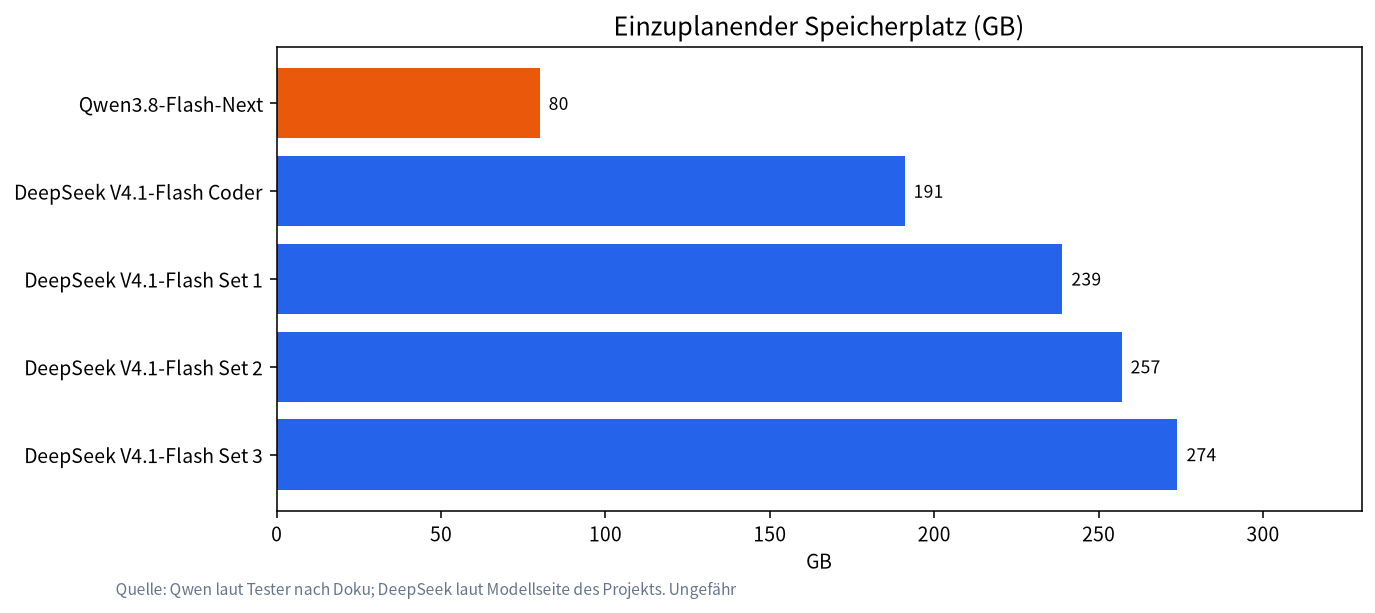
Für Qwen3.8-Flash-Next planen Sie etwa 80 GB frei ein, vor allem weil der Download die quantisierten Experten, Hilfsdateien und die n-Gramm-Tabelle enthält. DeepSeek V4.1-Flash braucht je nach Satz 191 bis 274 GB; unser Artikel DeepSeek V4.1 Flash mit 12 GB behandelt diesen Fall. Lesezugriffe verschleißen eine SSD nicht, aber ein beschäftigtes Laufwerk bremst alles andere; legen Sie den Strata-Ordner daher, wenn möglich, auf eine NVMe-Platte, die nicht Ihre Systemplatte ist.
Laptops, WSL2 und Unified Memory
Laptops sind der unbequeme Fall. Der Tester von arm1.ru führte das 125B-Modell auf einer RTX-5080-Laptop-GPU mit 30 GB RAM aus und stellte fest, dass es lief, aber der Speicher war knapp: Strata nutzte etwa 21 GB RAM und 4 bis 5 GB Swap, weshalb wir 32 GB RAM eher ein Kunststück als einen Plan nennen würden. Windows mit WSL2 funktioniert ebenfalls, wie der Community-Index für eine RTX 5060 Ti zeigt, auch wenn die Dokumentation anmerkt, dass unter Windows-Grafiktreibern bei Multi-GPU-Läufen nur ein Teil des Expertenspeichers fixiert wird. Bei Unified-Memory-Rechnern wie Strix Halo sind Grafikspeicher und RAM derselbe Pool, sodass eine Zahl von 128 GB die getrennten VRAM- und RAM-Werte der obigen Tabellen ersetzt.
Weitere Ergebnisse aus dem Benchmark-Index des Projekts
Das Repository führt einen Community-Benchmark-Index mit von Nutzern eingereichten Läufen. Sie sind selbst gemeldet, nutzen verschiedene Versionen (v0.1.40 bis v0.1.43) und Prompt-Längen, und wir haben keinen davon nachvollzogen; nehmen Sie die Tabelle also als Gefühl für die Spanne, nicht als Rangliste.
| Hardware (wie eingereicht) | Größe | Generierung, tok/s |
|---|---|---|
| RX 9070 16 GB, Ryzen 7 5800X3D, 64 GB RAM | IQ3_XXS | 57,9 bis 58,7 |
| RTX 5060 Ti 16 GB (WSL2), Ryzen 7 3700X, 128 GB RAM | IQ3_S | 47,7 bis 48,2 |
| 2× Tesla P40 24 GB, Xeon E5-2699 v3, 125 GB RAM | IQ3_S | 35,0 |
| Tesla V100 32 GB, Threadripper 2990WX, 96 GB RAM | UD-IQ4_XS | etwa 28 bis 33 |
| Strix-Halo-Laptop, 128 GB unified, 70 W | UD-IQ4_XS | 42 bis 59, je nach Prompt-Länge |
Zwei Dinge fallen auf. Die 16-GB-Karten im Index melden für vergleichbare Größen höhere Geschwindigkeiten als die 12-GB-Werte oben, was zum Expertencache-Design passt, auch wenn CPUs und Versionen verschieden sind. Und alte 24-GB-Workstation-Karten laufen bei großem RAM noch mit nützlichem Tempo. Beides passt zur Upgrade-Reihenfolge unten, aber es sind Einzeleinreichungen; lesen Sie sie nicht als Garantien.
Den eigenen Rechner abschätzen
Addieren Sie VRAM und RAM und ziehen Sie die Modellgröße ab: Der Rest ist der Platz für Betriebssystem, Browser, KV-Cache und alles andere. Das ist einfache Arithmetik auf den Zahlen des Projekts, keine Messung.
| Konfiguration (VRAM + RAM) | Summe | Spielraum für IQ2_XS (39,2 GB) | Spielraum für IQ3_S (54,8 GB) |
|---|---|---|---|
| 12 GB + 32 GB | 44 GB | etwa 4,8 GB, sehr knapp | passt nicht |
| 12 GB + 48 GB | 60 GB | etwa 20,8 GB | etwa 5,2 GB, sehr knapp |
| 12 GB + 64 GB | 76 GB | etwa 36,8 GB | etwa 21,2 GB |
Je weniger Spielraum, desto wahrscheinlicher swappen Sie wie der Laptop von arm1.ru, und das Tempo leidet. Unser Rat: Jagen Sie auf einem „gerade ausreichenden“ Rechner nicht der größten Größe nach; wählen Sie eine Größe kleiner und behalten Sie den Spielraum für lange Kontexte und den Alltag. Dieselbe Arithmetik sagt Ihnen auch, welchen Speicher Sie kaufen sollten: erst die Größe festlegen, dann rückwärts rechnen, statt erst zu kaufen und zu hoffen, dass es passt.
Upgrade-Reihenfolge, wie wir die Dokumente lesen
Das ist unsere Schlussfolgerung daraus, wie das Projekt sein Design beschreibt, keine gemessene Rangliste.
- RAM auf 64 GB. Dort liegen alle Experten, also entscheidet er, welche Größen Sie ausführen können. Meist der günstigste große Schritt.
- Mehr VRAM. Jedes Gigabyte fügt etwa 700 gecachte Experten hinzu, und eine höhere Trefferquote bedeutet weniger CPU-Berechnungen.
- Eine CPU mit AVX-512 und schnellerer Speicher. Das hilft bei den Fehlgriffen, laut zwei Testern.
- NVMe-Speicher. Am wichtigsten, wenn Sie Experten von der Platte streamen müssen.
Zu den Speicher-Abwägungen dahinter siehe unseren Leitfaden zu RAM vs VRAM und CPU-Offload und unseren GPU-VRAM-Leitfaden.
Wann ein Wunsch-PC sinnvoll ist
Das Zusammensuchen der Teile ist das Schwierige: eine Karte mit 12 oder 24 GB, genug RAM-Steckplätze, ein NVMe-Laufwerk, ein Netzteil und Kühlung passend kombinieren. Wenn Sie das lieber nicht tun, baut und testet unser Team in Shenzhen Rechner für lokale LLMs, und der Leitfaden zu Maschinen und Lösungen erklärt, wie das funktioniert. Nennen Sie uns Zielmodell, Budget und Lärmgrenzen, und wir schlagen eine Teileliste mit datierten Preisen vor. Wir haben Strata auf keinem Rechner gebenchmarkt; bitten Sie uns also um einen Test der konkreten Konfiguration, die Sie erwägen, statt die obigen Zahlen als gegeben zu nehmen. Leistung und Wärme behandelt unser Leitfaden zu Stromversorgung und Kühlung.
Was wir getan haben und was nicht
Am 2026-11-04 haben wir die Dokumente MODELS, HOW_IT_WORKS und Multi-GPU des Projekts sowie die oben verlinkten Testerberichte gelesen. Wir haben keinen Rechner gebaut, keinen Benchmark ausgeführt und nennen keine Preise. Wo eine Zahl von einer einzelnen Person stammt, nennen wir sie.
Häufige Fragen (FAQ)
Kann ich Strata mit einer 8-GB-GPU ausführen?
Der offizielle Weg empfiehlt 12 GB oder mehr. Der Community-Index des Projekts nennt zwei Quadro RTX 4000 mit 8 GB und 96 GB RAM, die IQ2_XS mit 18 bis 23 Token/s Generierung bei sehr langen Prompts ausführen, aber das sind zwei Karten und viel RAM, und wir haben es nicht geprüft.
Reichen 32 GB RAM?
Es ist knapp. Die Gewichte allein brauchen 37,6 bis 54,8 GB RAM plus VRAM; 12 GB VRAM und 32 GB RAM decken auf dem Papier also gerade die kleinste Größe ab, noch vor dem Anteil des Betriebssystems. Die auf Coding ausgerichtete Variante des Projekts ist mit etwa 32 GB RAM gelistet. Für die Standardgrößen sind 48 GB das praktische Minimum und 64 GB komfortabel.
Spielt die RAM-Geschwindigkeit eine Rolle?
Ja, denn die CPU berechnet Experten, die nicht auf der GPU liegen. Tester nannten DDR4-Bandbreite und fehlendes AVX-512 als Faktoren, aber wir haben keinen kontrollierten Vergleich.
Brauche ich eine NVMe-SSD?
Für den Standardweg brauchen Sie vor allem Platz, etwa 80 GB. NVMe wird wichtiger, wenn RAM knapp ist und Strata Experten von der Platte streamen muss.
Kann ich AMD, Intel oder einen Mac nutzen?
Das Projekt listet unterstützte AMD-Radeon-Karten, Intel Arc unter Linux, Apple Silicon ab macOS 15, Ryzen AI Max und DGX Spark, jeweils mit eigener Anleitung. Prüfen Sie die Installationsanleitung für Ihre Karte.
Sind zwei kleine GPUs besser als eine große?
Ein Tester maß zwei RTX-3060-Karten mit 45,0 Token pro Sekunde bei Q2_0, gegenüber Werten in den 40ern bei Einzelkarten anderer Tester; der Gewinn ist bei dieser Größe also nicht offensichtlich. Bei größeren Größen kann es mehr helfen, aber wir fanden keinen kontrollierten Vergleich.
Sprechen Sie mit uns
Planen Sie einen Build rund um GPU, RAM und Budget? Treten Sie der Community bei oder schreiben Sie an admin@microaione.com und sagen Sie uns, was Sie haben.