12GB 显存跑 DeepSeek V4.1 Flash:SSD 流式加载的速度推算与厂商实测,“能跑”到底有多慢
“12GB 显存加 64GB 内存就能本地跑 763B 大模型”是最近很多人转发的说法。我们的结论先放在前面:12GB 显存跑 DeepSeek V4.1 Flash 确实有人做到了,但“跑”的意思是以每秒个位数 token 的速度生成,数百 GB 的权重大部分躺在固态硬盘里,一次想很久的回答要等几分钟甚至十几分钟。这篇文章把推算过程摊开:模型结构、专家怎么放、每个 token 要从硬盘读多少数据、不同硬盘能撑到多快,并与运行时 Strata 自己公布的实测对照。这个话题的起因是GSQ-RCO 魔改版的核查;如果你想了解上一轮 1.5 TB 版本的部署账,见OBLITERATUS 版本地部署指南。
要点速览(更新于 2026-11-01)
- 该模型每层 384 个路由专家、每词用 6 个,共 40 层;2.00 bpw 这一档的骨干约 138 GB,加上 111 GB 的 Engram 表,磁盘需要约 257 GB(含 8 GB 草稿模型)。显存和内存都装不下,所以靠硬盘补读。
厂商 Strata 自测:RTX 5070 12GB + 64GB 内存 + 3.6 GB/s NVMe 约 4.7 token/s(README 表写 4–6),读 4K 提示约 121 token/s。这是对未编辑的 ISTA-DASLab 档的测量,不是魔改版。
我们的推算:每词约 2 GB 专家数据,若缓存命中 60%,3.6 GB/s 的硬盘上限约 4.4 token/s,与实测吻合;SATA 盘只有约 0.6 token/s。推算是上限,假设已逐条写明。
“能跑”不等于“跑满”:2 位量化(相对原版 KL 0.170、困惑度 +15.5%),小显卡默认只用 5/6 的专家,且不支持并发请求。
想要舒服的速度,要么大内存(128GB 统一内存约 11–21 token/s),要么更多显存和 250GB 内存。
12GB 显存跑 DeepSeek V4.1 Flash,“能跑”到底指什么
先把“能跑”拆开看,每一项都来自 Strata 的文档,或者由它直接推出:
| 项目 | 在 12GB + 64GB + 3.6GB/s NVMe 上的现实 | 依据 |
|---|---|---|
| 生成速度 | 约 4.7 token/s(README 表 4–6) | Strata 自报 |
| 读提示速度 | 4K 约 121 token/s,8K 约 231 token/s | Strata 自报 |
| 4,000 字提示的首字等待 | 约 35 秒 | 4,000 ÷ 121,推算 |
| 一次 2,000 token 的思考 | 约 7 分钟 | 2,000 ÷ 4.7,推算 |
| 一次 5,000 token 的长思考 | 约 18 分钟 | 5,000 ÷ 4.7,推算 |
| 并发请求 | 不支持 | Strata 文档“同时多个请求不在此版本” |
| 加载时间 | 每次几分钟(文档称每次加载 1–3 分钟) | Strata 文档 |
| 磁盘空间 | 239 / 257 / 274 GB | 1.75 / 2.00 / 2.25 bpw 三档含 Engram 和草稿模型 |
| 内存低于约 40GB | 未测试且很慢 | Strata 文档 |
所以“能跑”大致等于:能加载、能回答、能做离线的单人任务,但不适合要求快速交互、多人共用或长思考的场景。开启思考时,魔改版还可能为原版会拒绝的请求制定更长的计划,这会把等待时间再拉长。
为什么 250GB 的模型能塞进 12GB 的卡
DeepSeek-V4.1-Flash 是混合专家模型:40 层,每层 384 个路由专家,每个词只用其中 6 个,所以每一步只需要全部专家里的 1.6% 左右(6/384)。路由专家共 15,360 个,Strata 文档给出源格式(MXFP4)下每个约 18.8 MB,合计 288.8 GB;注意力等稠密权重约 16.8 GB;另外还有一张 n-gram 的 Engram 表,每个词只读其中几行,不占显存也不占内存,但放在慢盘上会拖慢每个词。
| 部分 | 大小(2.00 bpw 档) | 放在哪里 | 备注 |
|---|---|---|---|
| 稠密权重(注意力等) | 508 GB 的 Q8 档为 16.8 GB(BF16);2 位档的具体数字文档未给出 | 显存 | 12GB 卡的实测见下文;Q8 档的单卡余量说明不适用于 12GB 卡 |
| 15,360 个路由专家 | 骨干合计 138 GB,专家占绝大部分 | 显存装热门的,其余在内存,再放不下的在硬盘 | 缓存按使用频率自适应 |
| Engram 表 | 111 GB(IQ4_NL) | 固态硬盘,按需读取 | 建议放 NVMe |
| 草稿模型 DSpark | 8 GB | 磁盘,运行时用 | 用于投机解码 |
Strata 怎么放:三级存储
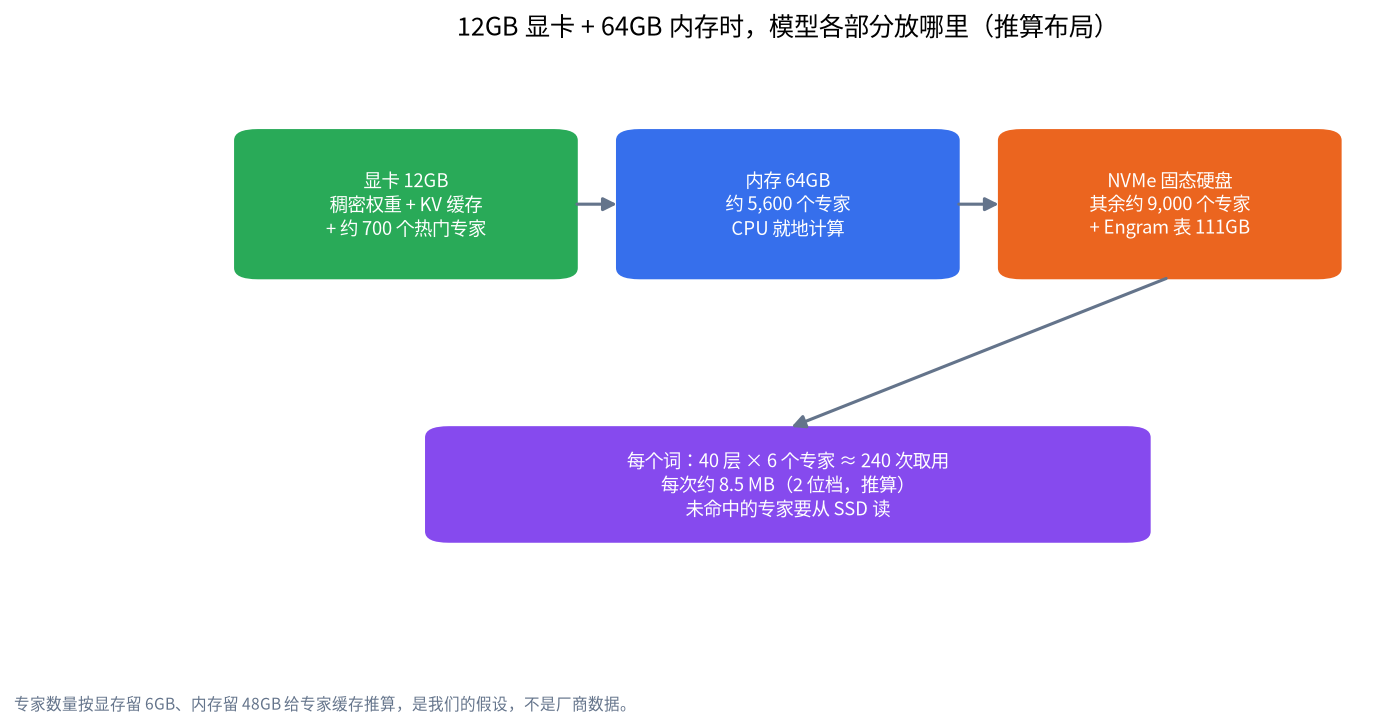
Strata 把显存当作最热的一层:稠密权重、KV 缓存,再加一个“专家缓存”,装下最常被选中的专家;内存是第二层,没在显卡里的专家由 CPU 就地计算(不搬到显卡);放不进内存的那部分专家,按文档所说,“在模型回答时从 SSD 读”,也就是“能运行,但很慢”。Strata 还随包带了一份“热门专家”的统计,用来在启动时预先决定先放哪些。上面的图是我们对 12GB + 64GB 的推算:显存留 6GB 给专家,内存留 48GB 给专家,则能缓存约 700 + 5,600 ≈ 6,300 个专家,占 15,360 个的约 41%。这两个预留量是我们的假设,不是厂商给的数。
每个 token 要读多少数据:吞吐推算
我们把推算的假设逐条写出来,你可以按自己的情况改:
- 每个专家按 2.00 bpw 档约 8.5 MB。推导:源格式 MXFP4 为 4.25 bit,18.8 MB × 2.00 ÷ 4.25 ≈ 8.8 MB;另一种算法是(138.24 GB − 约 8 GB 稠密)÷ 15,360 ≈ 8.5 MB。两者接近,取 8.5 MB。
- 每个词用 40 层 × 6 个专家 = 240 次取用,约 2.04 GB(默认的“更快”模式用 5 个专家,约 1.70 GB)。
- 缓存命中率未知。均匀路由时约等于缓存占比 42%;有热门专家倾斜时更高,我们取 60% 与 75% 作情景。
- 未命中的专家按 SSD 持续读取带宽读,不含 CPU 计算、随机读损耗和 DSpark 投机解码的收益,因此是上限。
- Engram 每词只读几行,忽略不计。
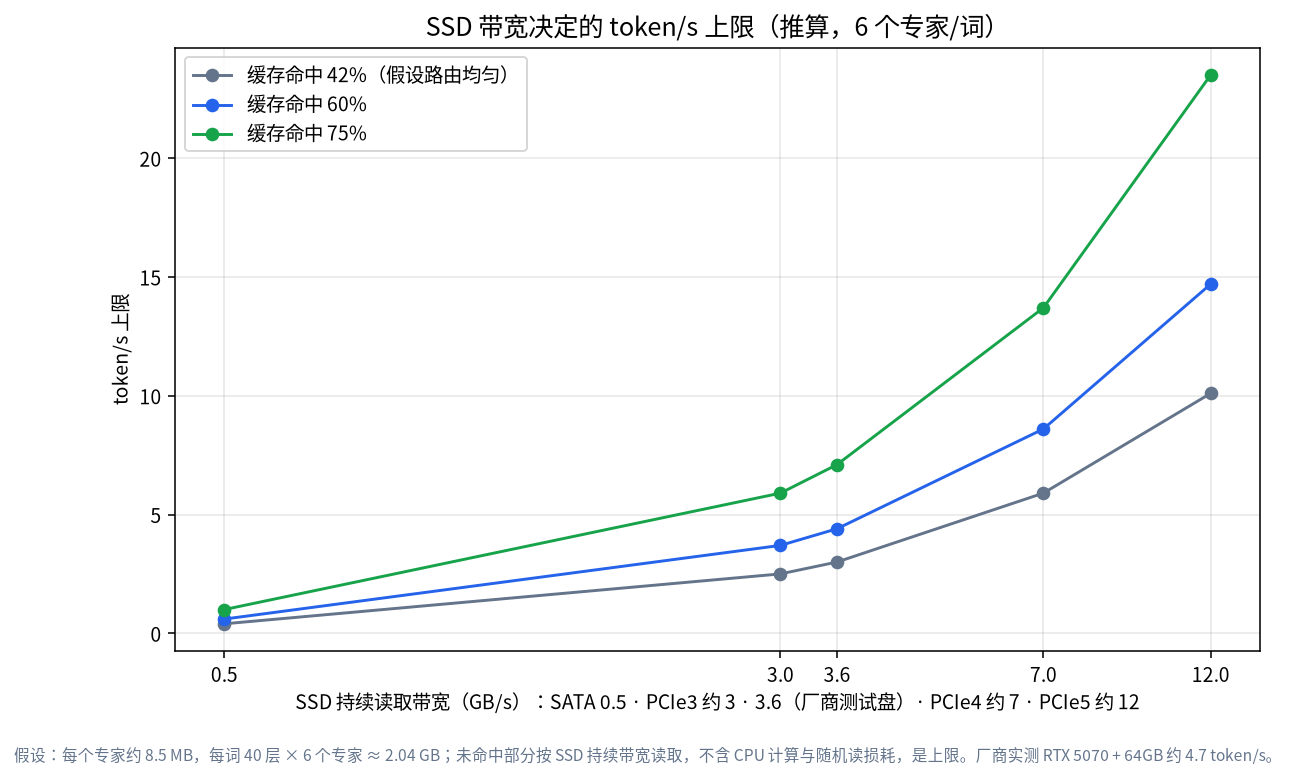
| 命中率 | SATA 0.5 GB/s | NVMe 3.6 GB/s(厂商测试盘) | PCIe 4.0 约 7 GB/s | PCIe 5.0 约 12 GB/s |
|---|---|---|---|---|
| 42%(均匀路由) | 约 0.4 token/s | 约 3.0 | 约 5.9 | 约 10.1 |
| 60% | 约 0.6 | 约 4.4 | 约 8.6 | 约 14.7 |
| 75% | 约 1.0 | 约 7.1 | 约 13.7 | 约 23.5 |
| 60%,5 个专家(更快模式) | 约 0.7 | 约 5.3 | 约 10.3 | 约 17.6 |
读这张表:同一块 3.6 GB/s 的硬盘,我们的推算在 60% 命中率下是 4.4 token/s,而厂商实测约 4.7(README 表 4–6),说明推算量级没有跑偏,也说明实际命中率大概在六成左右。但这是“用实测反推假设”,不能算独立验证。硬盘带宽是关键变量:换成 SATA 盘,上限掉到 1 token/s 以下;换成 PCIe 5.0 盘,理论上限能翻两到三倍,但那时 CPU 计算和内存带宽会先成为瓶颈,我们没有对此建模。
厂商实测:哪些可信,哪些要留心
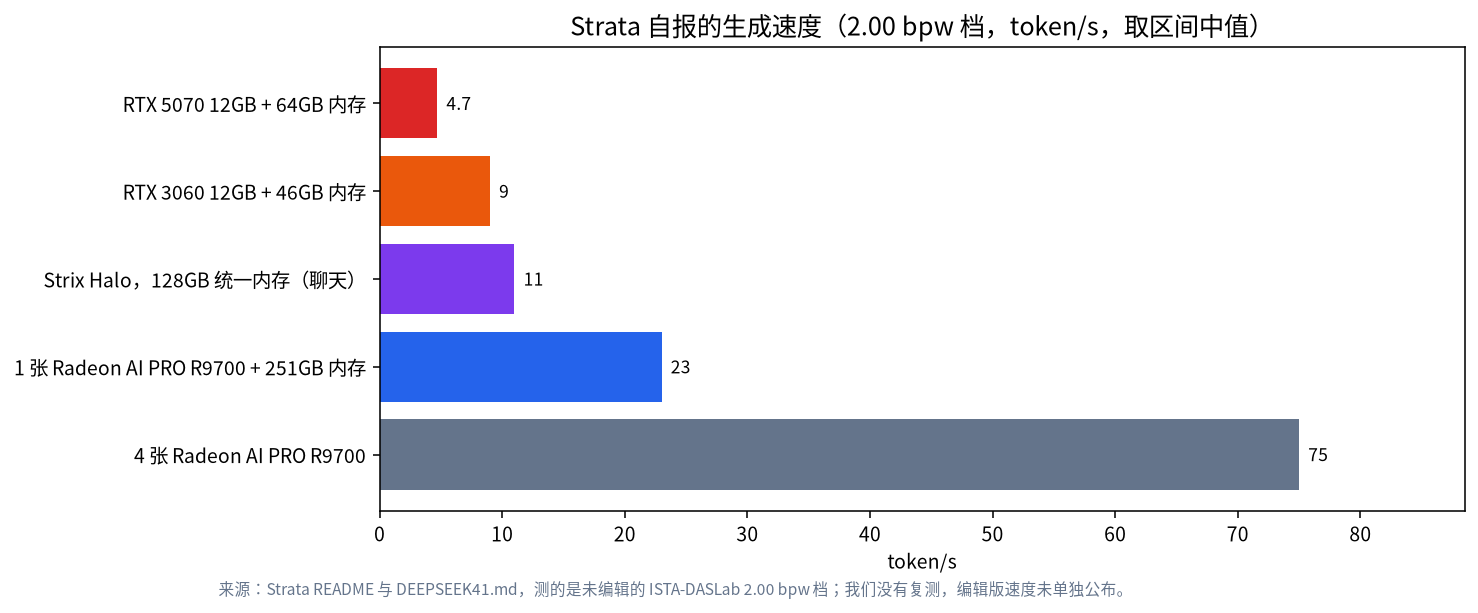
| 配置 | 生成速度 | 读提示 | 来源与备注 |
|---|---|---|---|
| RTX 5070 12GB + 64GB 内存 + 3.6GB/s NVMe | 约 4.7(README 4–6) | 4K 约 121 token/s | Strata 自报,引擎 0.2.5 |
| RTX 3060 12GB + 46GB 内存 | 约 8–10(README 9–11) | 8K 约 149 token/s | 自报;DSpark 关闭 |
| Strix Halo 128GB 统一内存 | 代码约 19–21,聊天约 11 | 4K 约 87,8K 约 125 | 自报,约 23GB 专家仍从 SSD 读 |
| 1 张 R9700 + 251GB 内存 | 约 21–25 | 8K 约 320–360 | README 自报 |
| 4 张 R9700 | README 74–77,文档约 48(2.00 档)/80(2.25 档) | 8K 约 400–450 | 两处口径不一致,我们不下结论 |
| RTX 4090 48GB + 128GB(用户自编引擎) | 40.2 | 4.6K 约 615 | GitHub 议题 #3935,单个用户报告 |
两处需要留心。第一,RTX 3060(46GB 内存)比 RTX 5070(64GB 内存)还快,按直觉应该反过来。Strata 文档没有解释,我们也没有核实,可能与硬盘、引擎版本或测试方法有关,只能如实标出。第二,上面全部是 Strata 自报的未编辑 ISTA-DASLab 档的数字。AtomicChat 的魔改版没有公布自己的速度;它的文件大小与未编辑档相同,所以量级应该接近,但那是我们的推断,没有验证。另一个背景是:Strata 项目创建于 2026-09-24,我们读到时约 3.7 万星、1,088 个未关闭议题,这说明很受关注,但不等于经过安全审计。
质量代价:极低比特加“更快”模式
2 位量化不是没有代价。Strata 报告的未编辑档相对原版:2.00 bpw 的 KL 为 0.170、困惑度 +15.5%;2.25 bpw 的 KL 为 0.107、困惑度 +7.3%;1.75 bpw 的 KL 为 0.217、困惑度 +21%,普通英文文本退步更明显。ISTA-DASLab 自己的卡片称 2.00 档保持了基础模型任务平均的 100%,AtomicChat 在同一个档上测到的 AIME25 和 GPQA 低得多,两边没有对上,细节见核查篇。此外,在显存不超过 16 GiB 的电脑和 Strix Halo 这类集成显卡上,Strata 默认启用“更快”模式,每个词只用 6 个专家中的 5 个,文档称质量变化“通常不明显”。这也是为什么“跑满 763B”这个说法站不住:你实际运行的是压到 2 位左右、默认少用一个专家的版本。
硬盘、内存与显卡怎么选
| 预算档位 | 配置 | 预期体验(推断) | 说明 |
|---|---|---|---|
| 最低可试 | 12GB 显卡 + 64GB 内存 + PCIe 4.0 NVMe | 个位数 token/s,对应厂商 4–6 | 低于约 40GB 内存未测试 |
| 更舒服 | 同上 + 更大内存(96–128GB) | 命中率上升,速度上升 | 内存越大,越少碰硬盘 |
| 统一内存 | Strix Halo 128GB | 厂商 11–21 token/s | 约 109GB 专家留在统一内存里 |
| 大内存 + 单卡 | 251GB 内存 + 1 张 32GB 卡 | 厂商 21–25 token/s | 2.00 档的专家大概率都在内存里(推断) |
| 不建议 | SATA 固态或机械盘存放 Engram 与专家 | 上限不到 1 token/s | 文档要求放 NVMe |
磁盘空间要留足:只下 2.00 档需要约 257 GB,三档都下约 533 GB;魔改版三档合计约 414 GB,另需 ISTA 仓库的 Engram(约 111 GB)。更详细的显存估算见GPU 显存选购指南和12GB 与 16GB 显存本地大模型对比,内存与 CPU 卸载的原理见内存与显存、CPU 卸载与本地跑 MoE 模型。想知道你的显卡能跑什么,可以直接查显存对照表。
替代路线
如果目标是“拿到可用的本地大模型”,而不是“必须是这一个”,有几种选择。一是选一个能完整放进内存的较小模型,速度往往是 10 倍以上,可参考MoE 模型本地部署。二是买大统一内存的机器,如 Strix Halo 128GB 或高内存 Mac,参考迷你主机大内存跑大模型与Mac 本地运行大模型;Strata 说明 Apple Silicon 需要至少 64GB 内存、只支持文本。三是走 llama.cpp:上游已在 2026-10-25 合并 deepseek41,ISTA 卡片称其未编辑文件在 b11870 及以上版本可用,Engram 表按需映射,不占内存,但我们没有测速。四是如果你要的是安全研究用途,更便宜的做法是在较小的模型上做拒绝方向实验,原理见原理详解。如果要做企业内部的私有化部署,请联系我们按预算评估(解决方案咨询)。
风险与合规
这份魔改版会回答原版会拒绝的请求,使用的责任在使用者。我们不复现任何有害回答,也不提供绕过方法。MIT 许可不等于合规:面向公众提供服务要遵守所在地的生成式 AI 规定(中国《生成式人工智能服务管理暂行办法》,欧盟 Regulation (EU) 2024/1689),这里只是一般信息,不是法律意见。建议只在内部研究中使用,并加分类器护栏、日志和访问控制。运行第三方引擎要多留一份小心:Strata 的 DeepSeek 引擎是单独的签名下载,文档说会校验签名和哈希,但我们没有核验安装包本身,下载前请先看清来源、对照校验值。更完整的原则见核查篇。
我们做了什么,没做什么
我们读取了 Strata 的 README 与 DeepSeek 文档、AtomicChat 与 ISTA-DASLab 的模型卡,并自己做了吞吐推算。我们没有下载权重,没有在任何硬件上测速,表中所有“实测”都是厂商自报,所有“推算”都标明了假设。
常见问题
12GB 显存加 64GB 内存真的能跑吗?
能,厂商自测约 4.7 token/s(README 4–6)。但数百 GB 的权重大部分在固态硬盘上,需要约 257 GB 空间,等待时间长,不适合实时交互。
为什么这么慢?
每个词要用 40 层 × 6 个专家,约 2 GB 的数据;显存和内存装不下的专家要从硬盘读,硬盘带宽就成了上限。
换更快的固态硬盘能快多少?
按我们的推算,命中率 60% 时,3.6 GB/s 约 4.4 token/s,7 GB/s 约 8.6,12 GB/s 约 14.7,但这是上限,CPU 计算和内存带宽会先成为瓶颈。
内存加到 128GB 有用吗?
有用。缓存的专家越多,读硬盘越少;Strix Halo 128GB 的厂商数字是 11–21 token/s,但那是统一内存,不等于普通电脑加内存条的结果。
魔改版和原版 GGUF 的速度一样吗?
文件大小一致,量级应该接近,但魔改版自己没有公布速度,思考时的计划还可能更长,我们没有验证。
适合生产使用吗?
不建议。它不支持并发请求,量化与“更快”模式带来质量损失,且回答原版会拒绝的请求。内部研究请加护栏与日志。
想按预算评估配置?
欢迎到社区交流,或发邮件到 admin@microaione.com,说说你的显卡、内存、硬盘和预算,我们帮你推算。
参考资料:Strata 的 DeepSeek-V4.1-Flash 文档、AtomicChat 模型卡、ISTA-DASLab GSQ-RCO GGUF 卡片、llama.cpp PR #31086、EU AI Act。数据读取于 2026-11-01,均为各页面自报。