DeepSeek 本地部署费用:从 8 千元到百万元,三种路线与 API 的回本测算
问“DeepSeek 本地部署费用是多少”,得到的答案常常相差一百倍:有人说一台 8 千元的电脑就行,有人说企业一体机要上百万。两种说法都没错,因为他们说的根本不是同一个模型。这篇文章把 DeepSeek 的本地使用拆成三条路线——小蒸馏版、满血的 V4.1 Flash、直接调 API——分别算出一次性硬件费用、每月电费,再用官方 API 价格算回本月数。所有价格都标明来源和日期,所有假设(汇率、用量、功率、电价)都写在算式旁边,你可以换成自己的数字重算。我们没有在本地跑过满血的 V4.1 Flash,文中没有自测速度。
要点速览(更新于 2026-11-04)
- 蒸馏版路线(Ollama 上的 R1 蒸馏 7B 到 70B):参考整机从 7,899 元(RTX 3060 12GB 入门)到 33,214 元(RTX 4090 24GB)。
满血 V4.1 Flash 路线:模型约 763B 参数;Unsloth 给出的 1 比特量化需要约 128 到 145GB 的内存加显存。参考 128GB 整机 24,566 元起,但 128GB 刚好卡在需求区间下沿,速度与可行性要自己验证。
API 路线:官方
deepseek-flash非高峰每百万 token 输入 0.15 美元(缓存命中 0.003)、输出 0.60 美元,高峰翻倍。我们算的“轻度”用户月费只有约 19 元。- 回本测算:轻度和中度用户,硬件几乎不可能靠“省 API 费”回本;只有每月 API 费上千元的重度用户,大约一到两年才可能回本。省钱不是本地部署的主要理由,隐私、离线和可控才是。
先说清楚:你要部署的到底是哪个 DeepSeek
“DeepSeek 本地部署”在网上至少指三种东西,费用差别极大:
| 路线 | 具体是什么 | 大小量级 | 典型硬件 |
|---|---|---|---|
| 蒸馏版 | 用 DeepSeek-R1 的输出训练的小模型,底座是 Qwen 或 Llama,Ollama 标签 7b、14b、32b、70b | 4.7GB 到 43GB(Ollama 量化版) | 8GB 到 48GB 显存 |
| 满血 V4.1 Flash | DeepSeek 自己的最新模型,约 763B 参数,MIT 许可 | Unsloth 量化 233GB 到 508GB 文件;1 比特约需 128 到 145GB 内存加显存 | 大内存工作站、服务器,或统一内存的整机 |
| 官方 API | 不在本地,按 token 付费 | 无 | 任何能上网的设备 |
最重要的一点:蒸馏版不是 DeepSeek 本体。它们由别的底座模型加上 R1 的推理数据训练得到,能力和 V4.1 Flash 不在同一档,所以拿“4090 跑 32B 蒸馏”和“API 调 V4.1 Flash”比成本,本身就不是同一个商品。这一点我们在 DeepSeek R1 蒸馏版大小详解和满血版部署指南里分别讲过。入门级的教程见 DeepSeek 本地部署教程。
DeepSeek 本地部署费用之一:一次性硬件费用(本站参考价)
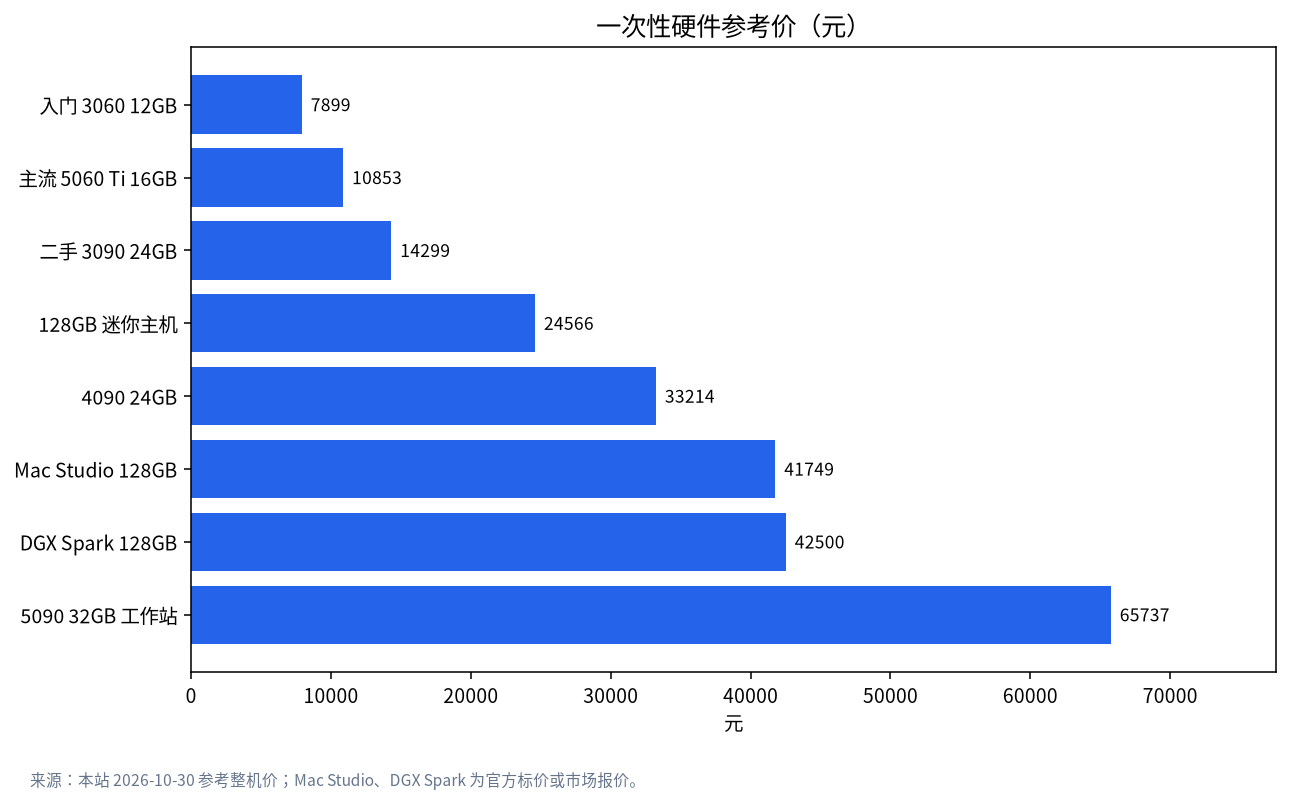
下表来自我们 2026-10-30 整理的参考整机价格(按市场中位价估算,不含显示器、外设、系统授权、运费和组装测试服务费,实际以报价为准)。
| 路线 | 参考配置 | 参考价(元) | 能跑什么 |
|---|---|---|---|
| 蒸馏版入门 | RTX 3060 12GB + i5-12600KF + 32GB 内存 | 7,899 | 7B、8B 蒸馏,14B 需压缩上下文 |
| 蒸馏版主流 | RTX 5060 Ti 16GB + i5-14600KF + 32GB 内存 | 10,853 | 14B 蒸馏较舒适 |
| 蒸馏版进阶 | 二手 RTX 3090 24GB + i5-14600KF + 32GB 内存 | 14,299 | 32B 蒸馏,短上下文 |
| 蒸馏版进阶替代 | RTX 4090 24GB + 同平台 | 33,214 | 同上,速度更快 |
| 大显存工作站 | RTX 5090 32GB + R7 9700X + 64GB 内存 | 65,737 | 32B 蒸馏更宽裕 |
| 大内存迷你主机 | Ryzen AI Max+ 395 128GB 整机 | 24,566 | 大内存,可尝试 MoE 与低位量化,需自测 |
| 对照:品牌整机 | Mac Studio M5 Max 128GB/1TB(官方标价) | 41,749 | 同上 |
| 对照:品牌整机 | DGX Spark / GB10 128GB(市场报价) | 42,500 | 同上 |
| 对照:企业一体机 | 671B 满血档(市场报价,不是我们的报价) | 1,350,000 | 满血 DeepSeek 级模型,服务多人 |
看这张表要注意两点。第一,32B 蒸馏在 24GB 显卡上大约需要 22GB(8K 上下文)到 24GB(16K 上下文),已经非常贴近显存上限,见我们的 24GB 显存能跑什么。第二,“满血 V4.1 Flash”在家用价位上唯一可能的路线是大内存的统一内存整机,但 1 比特量化需要 128 到 145GB,128GB 的机器处于区间下沿,需要靠磁盘卸载或更小量化,速度和稳定性我们没有实测,请不要把它当作承诺。更多关于内存和显存搭配的原理见 内存与显存的取舍。
API 费用:先把官方价格读准
我们 2026-11-04 读取了 DeepSeek 官方定价页:deepseek-flash(即 DeepSeek-V4.1-Flash-1017)非高峰时段每百万 token 的价格为缓存命中 0.003 美元、缓存未命中 0.15 美元、输出 0.60 美元;高峰时段翻倍。高峰时段是工作日的 UTC 01:00 到 04:00 和 06:00 到 10:00,换算成北京时间是工作日 09:00 到 12:00 和 14:00 到 18:00,也就是上班时间,节假日按官方说明不算高峰。上下文长度 1M。官方旧的模型名已退役,请以官方页面为准。
给三类典型用户算月费(假设汇率 1 美元 = 7.1 元,用量是我们设定的示例,不是统计):
| 用户类型 | 每月输入 tokens | 缓存命中比例 | 每月输出 tokens | 非高峰月费 | 高峰月费 |
|---|---|---|---|---|---|
| 轻度(偶尔问答) | 12M | 50% | 3M | 约 2.72 美元 = 19 元 | 约 5.44 美元 = 39 元 |
| 中度(每天写作与编程辅助) | 120M | 50% | 30M | 约 27.18 美元 = 193 元 | 约 54.36 美元 = 386 元 |
| 重度(编程智能体常开) | 1,200M | 80% | 300M | 约 218.88 美元 = 1,554 元 | 约 437.76 美元 = 3,108 元 |
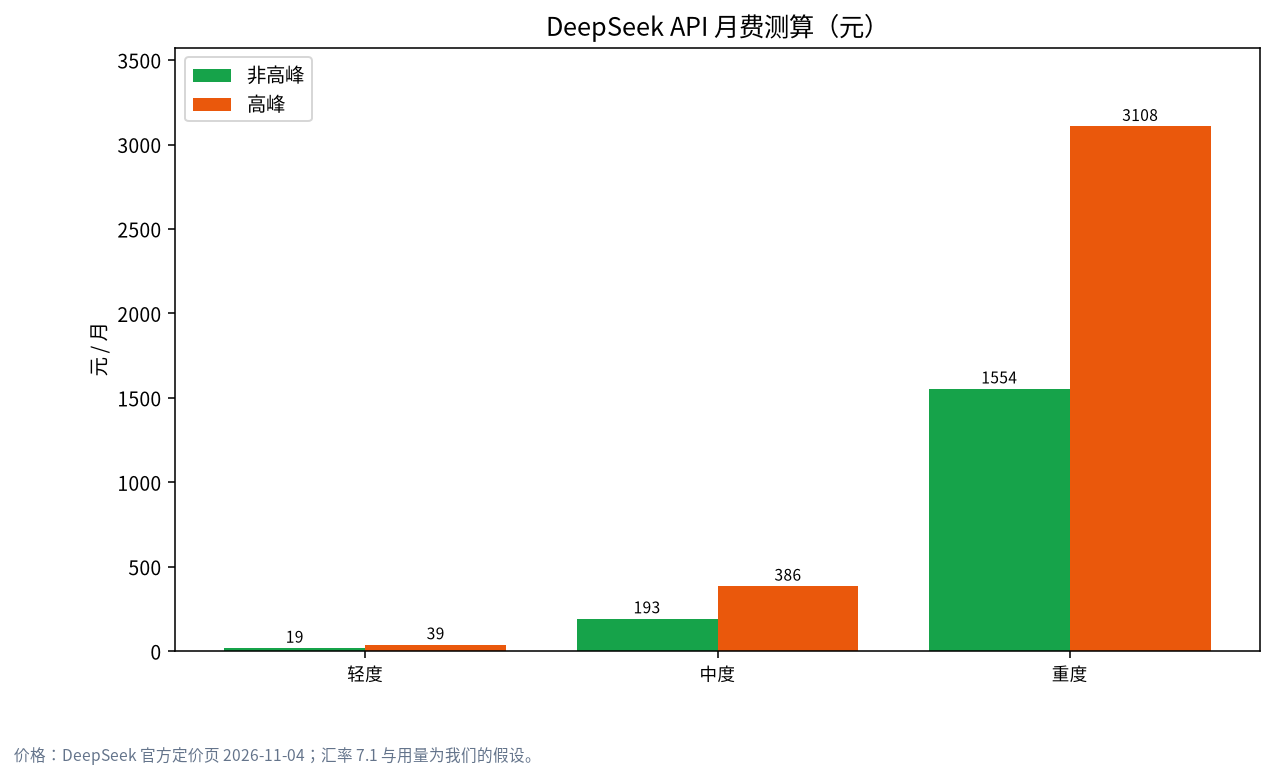
计算示例(轻度,非高峰):输入 12M,其中命中 6M、未命中 6M,输出 3M。费用 = 6 × 0.003 + 6 × 0.15 + 3 × 0.60 = 0.018 + 0.90 + 1.80 = 2.718 美元,约 19 元。重度用户的算式相同:命中 960M × 0.003 / 1M 等于 2.88 美元,未命中 240M × 0.15 / 1M 等于 36 美元,输出 300M × 0.60 / 1M 等于 180 美元,合计 218.88 美元。可以看到:输出 token 是大头,缓存命中几乎不花钱。把非紧急任务放到非高峰,能直接省一半。我们在 本地部署还是 API 更划算里也给过类似的对比框架。
每月电费:算一遍,其实不是大头
电费 = 功率 × 每天使用小时数 × 30 天 ÷ 1000 × 电价。我们假设电价 0.6 元/千瓦时、每天满载使用 4 小时:
| 方案 | 假设整机满载功率 | 每月耗电 | 每月电费 |
|---|---|---|---|
| 入门机(RTX 3060 12GB) | 350W | 42 千瓦时 | 约 25 元 |
| 4090 整机 | 600W(GPU 450W 加其他约 150W) | 72 千瓦时 | 约 43 元 |
| 128GB 迷你主机 | 140W | 16.8 千瓦时 | 约 10 元 |
| Mac Studio | 120W | 14.4 千瓦时 | 约 9 元 |
这些功率是我们的假设,实际取决于负载和机器,请用插座功率计测一下。如果你每天跑 8 小时,电费翻倍,但仍然是几十到一百元量级,远小于折旧。4090 的 450W 满载功耗和电源要求见 RTX 5090、4090、3090 对比。
回本测算:硬件到底要多久才比 API 便宜
回本月数 = 硬件一次性价格 ÷(每月 API 费 − 每月电费)。我们用“中度”和“重度”两种用量(非高峰价)算:
| 方案 | 一次性价格 | 每月电费 | 对中度 API(193 元/月)回本 | 对重度 API(1,554 元/月)回本 |
|---|---|---|---|---|
| 入门机 7,899 元 | 7,899 | 25 元 | 约 47 个月 | 约 5.2 个月 |
| 4090 整机 33,214 元 | 33,214 | 43 元 | 约 222 个月 | 约 22 个月 |
| 128GB 迷你主机 24,566 元 | 24,566 | 10 元 | 约 134 个月 | 约 15.9 个月 |
| Mac Studio 41,749 元 | 41,749 | 9 元 | 约 227 个月 | 约 27 个月 |
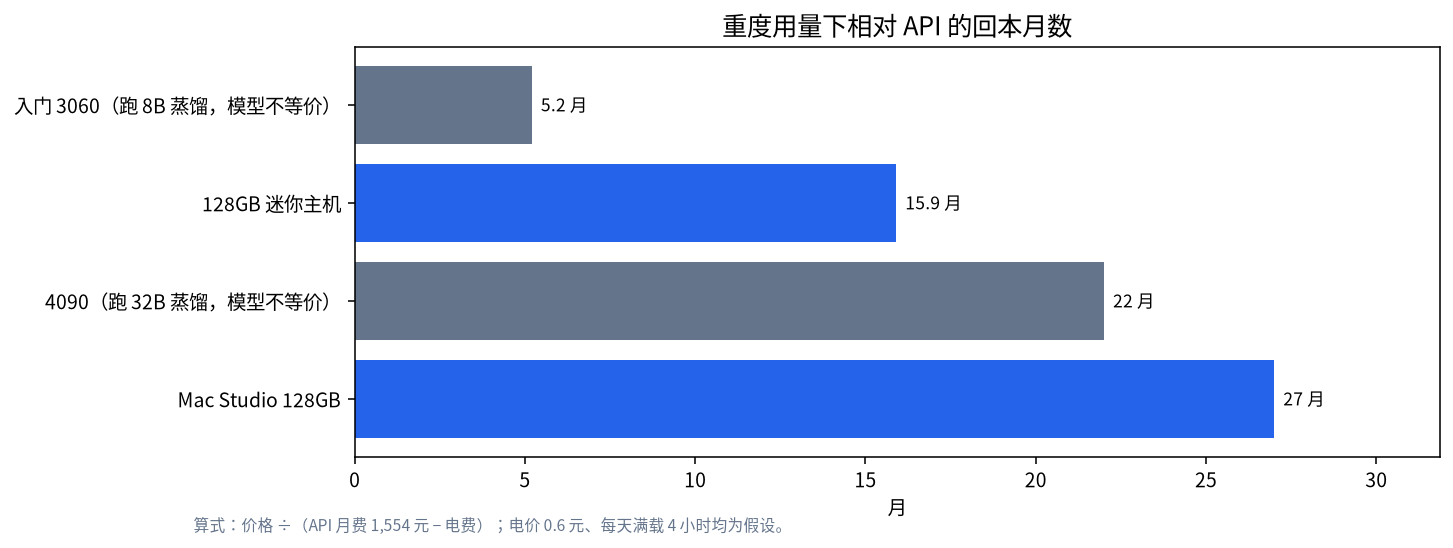
算式示例(4090,重度):33,214 ÷ (1,554 − 43) = 33,214 ÷ 1,511 ≈ 22 个月。必须强调三个“不等价”:
- 模型不等价。 入门机和 4090 跑的是蒸馏版,不是 V4.1 Flash;入门机“5 个月回本”的前提是你愿意用一个 8B 蒸馏替代 API 上的旗舰级模型,质量差距很大。只有 128GB 迷你主机和 Mac Studio 这类机器才有可能尝试接近满血的大模型,而且要自己验证。
- 速度不等价。 API 的速度来自数据中心,我们引用过的第三方统计为约 175 tokens/s;本地的速度取决于内存带宽,需要自测。
- 价值不等价。 这个测算没有计入设备折旧后的残值、你的时间成本、噪音、故障,也没有计入隐私和离线能力的价值。
所以结论是:如果只为了省钱,绝大多数人用 API 更划算;只有用量很大、数据不能出本机、或者需要离线时,本地才值得。
隐藏成本清单
- 存储: 大模型文件几十到几百 GB,2TB 的 SSD 起步,频繁换模型还会占用更多空间。
- 电源与散热: 4090 级整机建议 850W 电源,见前面的参考配置;机箱风道和噪音也要考虑。
- 时间: 部署、调参、排查问题的时间不是零。
- 升级: 模型换代很快,显存不够时往往要整卡更换。
- 运维与安全: 对外服务要做认证和审计,见 本地 API 服务器。
按场景选路线
- 只想试试: 先用 API,或用 7B、8B 蒸馏在现有电脑上跑,成本接近零。
- 个人日常使用、数据敏感: 24GB 显卡跑 32B 蒸馏或同级模型,预算约 1.4 万元(二手 3090)起。
- 想接近满血能力: 大内存整机,预算 2.5 万到 4 万元,但要自测速度。内存不够时的取舍见 12GB 显存与 SSD 流式加载。
- 团队、多人并发: 企业一体机或云 GPU,成本量级以万为单位到百万元,需要单独评估。
常见问题 FAQ
DeepSeek 本地部署费用最低是多少?
用现有电脑跑 1.5B 到 8B 的蒸馏版,费用接近零;如果为此新买硬件,我们参考的入门整机是 7,899 元(RTX 3060 12GB)。
本地部署满血 DeepSeek 要多少钱?
模型约 763B 参数,Unsloth 的 1 比特量化需要约 128 到 145GB 内存加显存。家用价位的大内存整机约 2.5 万到 4 万元,但可行性和速度需要自测;企业级满血方案的市场报价约 135 万元(非我们报价)。
本地部署 DeepSeek 比用 API 更省钱吗?
对多数人不是。以轻度用量,API 月费只有约 19 元;中度约 193 元;只有重度用量才可能在一到两年内回本,而且前提是本地模型能力满足需求。
DeepSeek 官方 API 现在多少钱?
2026-11-04 我们读取的 deepseek-flash 非高峰价:缓存命中 0.003 美元、未命中 0.15 美元、输出 0.60 美元(每百万 token),高峰翻倍。价格会变,请以官方页面为准。
电费会不会很贵?
按每天满载 4 小时、0.6 元/千瓦时估算,4090 整机每月约 43 元,大内存迷你主机约 10 元,电费不是主要成本。
蒸馏版和 DeepSeek 本体差在哪?
蒸馏版是用 R1 的推理数据训练的 Qwen 或 Llama 底座小模型,不是 DeepSeek 自己的大模型,能力不在同一档,详见 蒸馏版大小详解。
和我们聊聊
如果你想按自己的预算和用量重算回本月数,欢迎把用量、预算和所在地电价发到社区或邮件 admin@microaione.com,我们帮你算一遍。购买前请核对实时报价,本文价格是 2026-10-30 的参考价。
参考资料:DeepSeek API 官方定价页、Unsloth 的 DeepSeek 本地运行指南、Ollama deepseek-r1 页面。价格读取于 2026-11-04,北京时间。